代码大模型:分走半壁程序员工作后,留下的真问题
上个月在南京江北的产学研对接会蹲了三天,见了七八支做模型的团队,也听了七八个制造业、互联网公司的技术负责人吐槽。大半demo看起来都炫,点进实际生产场景用,全是水土不服。
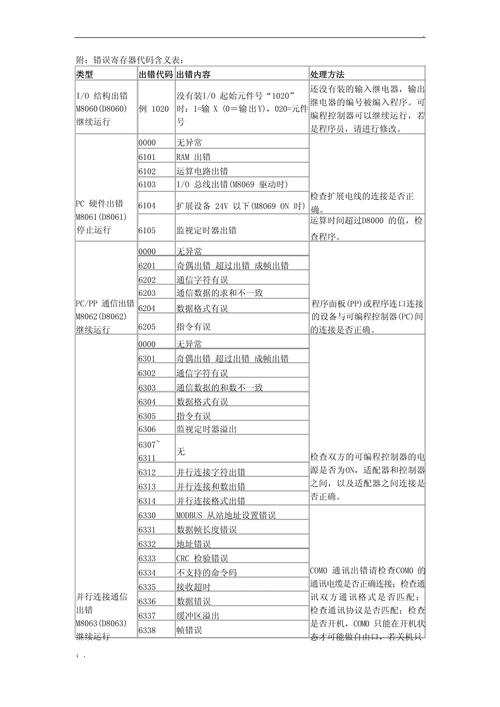 代码大模型生成错误PLC驱动代码示例
很多demo都是提前出好的题,题干和标准答案都在训练集里,模型当然能做对。换一个你企业私有的、从来没上传过公开网络的业务需求,错漏能占到三成以上。
我见过最夸张的,模型生成的代码里,居然把客户内部没公开的业务接口名都写出来了——合着训练数据里偷爬了人家没开源的私库,这风险谁敢碰?
实话讲,现阶段能稳定落地的能力,还是停留在"帮人做重复劳动",不是替人做决策。你让它改格式、写单元测试、补注释,都没问题。你让它梳理模糊需求、设计核心架构,那就是赶鸭子上架。
 Github主流开源协议代码占比统计
去年欧美已经出现了首例代码生成侵权诉讼,原告是开源项目作者,告模型训练的时候抄了他的代码,生成结果带了他的原创实现,要求赔偿。现在法院还没判,但这个风险已经悬在所有用模型的企业头上。
GPL协议的传染性是摆在这里的,模型学了GPL协议的代码,生成的衍生代码会不会继承GPL协议的开源要求?没人能给出明确答案。
绝大多数团队做数据清洗,只会去重、去乱码,根本不会按开源协议分类清洗。反正训出来效果好就行,风险全丢给下游用的企业,说白了就是不负责任。
还有一个容易被忽略的点,数据偏见会放大技术路径依赖。不管你什么需求,模型都倾向于给你生成它见得多的Python代码,明明用C写性能更好,明明用汇编更贴合硬件,它偏不,因为训练数据里Python多,这就是惯性,改都改不过来。
 落地的正确姿势:嫁接,不是替换
我听过最蠢的决策,就是某创业公司去年裁了一半初级程序员,全靠模型写代码省成本,结果三个月后项目上线,bug堆得没人能改,又花双倍价钱招人,亏了小一千万。
这些人都是被营销忽悠了,错把工具当成了人。
现阶段真正用得好的团队,没有一个是拿模型替换程序员的,都是把模型的能力嫁接在现有开发流程里。让模型干程序员不想干的脏活累活:写重复的CRUD、补全单元测试、生成接口文档、改旧代码的格式,把程序员的时间省出来干需求梳理、架构设计这些需要人脑判断的活,这才是正途。
不要迷信通用基座的能力。通用模型能覆盖所有场景?根本不可能。你要想用在自己的生产环境,老老实实拿自己企业的代码库、自己的业务规范做领域微调,成本比训一个百亿基座低得多,效果好出好几个量级。
应用边界其实很清晰:有明确规则、有固定范式、有足够领域数据的场景,尽管用,能省一半时间。反过来,需求模糊、需要业务创新、要平衡不同部门利益的场景,模型帮不了你,最多帮你整理个会议纪要。
至于风险,除了前面说的版权,还有安全问题。模型生成的代码经常藏着未被发现的漏洞,甚至有现成的后门,你不做审核直接上线,就是给黑客开门。这个已经有不下十个公开案例了,别心存侥幸。
接下来怎么走?我看不是堆参数,不是比谁的模型更大,是往垂直走,往场景里嵌。再过三五年,你不会到处说"我用了大模型写代码",它就只是你IDE里的一个基础功能,就像当年的语法提示、自动补全一样,悄咪咪把程序员的重复活接走,留下更多时间给真正的创造。
从补全到生成,被高估的能力和被低估的盲区
一开始大家对这类模型的期待,停留在IDE里的自动补全,能帮你敲完剩下的变量名就行。不知道从什么时候开始,营销口径变成了"从零生成整个项目"。 真有这么神? 那个做工业控制系统的老周,当场把他们厂新上的PLC驱动需求丢给三个不同模型,生成出来的代码跑起来全报错。要么寄存器地址写错,要么中断逻辑不对,连最基础的硬件时序都对不上。 为什么会这样?本质上,所有当前模型的输出,都是训练数据分布内的拟合,超出分布覆盖的范围,出错概率直接拉满。代码大模型生成错误PLC驱动代码示例
很多demo都是提前出好的题,题干和标准答案都在训练集里,模型当然能做对。换一个你企业私有的、从来没上传过公开网络的业务需求,错漏能占到三成以上。
我见过最夸张的,模型生成的代码里,居然把客户内部没公开的业务接口名都写出来了——合着训练数据里偷爬了人家没开源的私库,这风险谁敢碰?
实话讲,现阶段能稳定落地的能力,还是停留在"帮人做重复劳动",不是替人做决策。你让它改格式、写单元测试、补注释,都没问题。你让它梳理模糊需求、设计核心架构,那就是赶鸭子上架。
训练阶段看不见的暗坑:数据偏见与版权雷区
现在训模型用的代码,百分之九十以上来自公开开源仓库。Github上星标越高的项目,权重占比越大,这天生就带了偏见。 热门语言、热门框架的代码占了绝大多数权重,冷门领域的代码根本没说话的份。比如写工业单片机汇编的,整个Github上的存量代码,都不如一个热门前端框架三个月的commit多,训出来的模型能写对才怪。 更麻烦的是版权问题。Github主流开源协议代码占比统计
去年欧美已经出现了首例代码生成侵权诉讼,原告是开源项目作者,告模型训练的时候抄了他的代码,生成结果带了他的原创实现,要求赔偿。现在法院还没判,但这个风险已经悬在所有用模型的企业头上。
GPL协议的传染性是摆在这里的,模型学了GPL协议的代码,生成的衍生代码会不会继承GPL协议的开源要求?没人能给出明确答案。
绝大多数团队做数据清洗,只会去重、去乱码,根本不会按开源协议分类清洗。反正训出来效果好就行,风险全丢给下游用的企业,说白了就是不负责任。
还有一个容易被忽略的点,数据偏见会放大技术路径依赖。不管你什么需求,模型都倾向于给你生成它见得多的Python代码,明明用C写性能更好,明明用汇编更贴合硬件,它偏不,因为训练数据里Python多,这就是惯性,改都改不过来。
落地的正确姿势:嫁接,不是替换
落地的正确姿势:嫁接,不是替换
我听过最蠢的决策,就是某创业公司去年裁了一半初级程序员,全靠模型写代码省成本,结果三个月后项目上线,bug堆得没人能改,又花双倍价钱招人,亏了小一千万。
这些人都是被营销忽悠了,错把工具当成了人。
现阶段真正用得好的团队,没有一个是拿模型替换程序员的,都是把模型的能力嫁接在现有开发流程里。让模型干程序员不想干的脏活累活:写重复的CRUD、补全单元测试、生成接口文档、改旧代码的格式,把程序员的时间省出来干需求梳理、架构设计这些需要人脑判断的活,这才是正途。
不要迷信通用基座的能力。通用模型能覆盖所有场景?根本不可能。你要想用在自己的生产环境,老老实实拿自己企业的代码库、自己的业务规范做领域微调,成本比训一个百亿基座低得多,效果好出好几个量级。
应用边界其实很清晰:有明确规则、有固定范式、有足够领域数据的场景,尽管用,能省一半时间。反过来,需求模糊、需要业务创新、要平衡不同部门利益的场景,模型帮不了你,最多帮你整理个会议纪要。
至于风险,除了前面说的版权,还有安全问题。模型生成的代码经常藏着未被发现的漏洞,甚至有现成的后门,你不做审核直接上线,就是给黑客开门。这个已经有不下十个公开案例了,别心存侥幸。
接下来怎么走?我看不是堆参数,不是比谁的模型更大,是往垂直走,往场景里嵌。再过三五年,你不会到处说"我用了大模型写代码",它就只是你IDE里的一个基础功能,就像当年的语法提示、自动补全一样,悄咪咪把程序员的重复活接走,留下更多时间给真正的创造。