量子纠错:量子计算真正落地的最后一块拼图
打开科技新闻,三天两头就能刷到“某某团队造出多少比特量子芯片”“量子优越性再破新纪录”。
大部分人都觉得,量子计算马上就要改变世界了对吧?
没人提量子纠错。
好像这玩意儿不存在一样。
为什么量子计算离了量子纠错就不行?
量子比特这个东西,太娇贵了。
稍微一点外界干扰,机箱的振动,温度飘个零点几开,旁边过个电磁波,量子态直接就歪了,这个就是大家常说的退相干。一旦量子态错了,整个计算结果就废了。
经典计算机纠错很简单,把信息复制几份存着,错了对比一下就改过来。量子不行,量子不可克隆定理摆在那儿,你连复制都做不到,更别说对比纠错了。
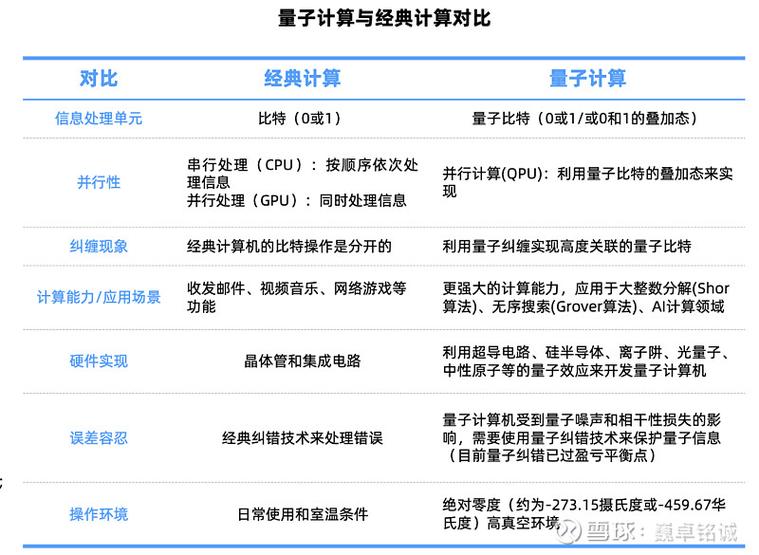 量子退相干对量子计算结果影响对比图
现在市面上所有商用的量子计算原型机,全是NISQ,也就是没做完整纠错的噪声器件。最多跑点演示性的算法,真接工业活,干一个错一个。
错一个,全错。
白跑几个小时,最后出来一堆没用的垃圾数据,说的就是这种没纠错的机器。要做真正能用的量子计算,绕不开量子纠错这道坎,没任何捷径可走。
现在量子纠错走到哪一步了?
五年前,学界的共识是:要做一个错误率比物理比特低的逻辑量子比特,至少还得十五年。毕竟主流的表面码方案,做一个逻辑比特就得上百个物理比特,当时根本造不出来这么多低噪声的物理比特。
结果呢?2023年底谷歌团队在《自然》发的那篇论文,直接把这个天花板捅破了。他们用144个物理比特,搭出了一个表面码编码的逻辑量子比特,实测出来纠错后的错误率,比单个物理比特本身的错误率还要低。
这不是量变,这是质变。
 谷歌悬铃木量子芯片表面码量子纠错布线图
之前全世界做量子纠错,最多做到纠错后错误率还是比单个物理比特高,等于白纠错,还浪费了一堆硬件。现在终于反过来了,说明这条路走通了,方向对了,接下来就是堆规模的事儿。
IBM今年年初更新了他们的路线图,直接把商用纠错量子计算机的时间表从2030年代中期提前到了2029年。说实话,我第一次看到这个新闻的时候,直接把手机放下愣了半分钟,这速度比五年前行业报告里预测的,早了整整十二年。
说白了,量子纠错的核心逻辑就是用一堆容易错的物理比特,通过纠缠编码绑在一起,凑出一个几乎不会错的逻辑量子比特。只要纠错后的错误率降下来,就能把多个逻辑比特拼起来做真正复杂的计算,之前是卡在上游,现在上游通了。
量子纠错落地之后,最先改变什么?
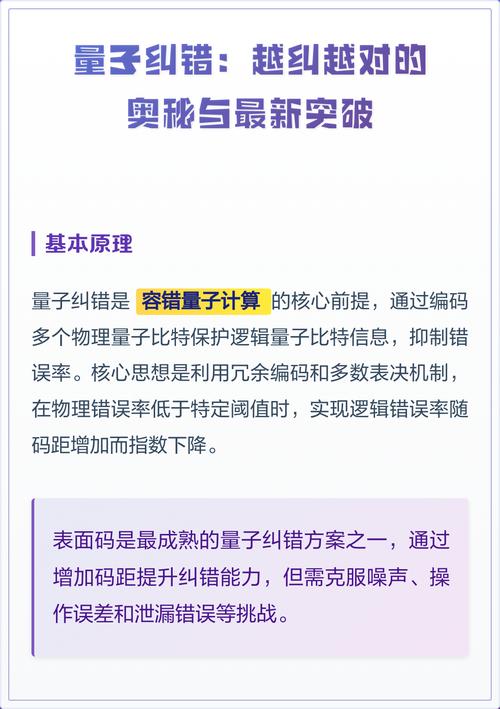 量子纠错落地之后,最先改变什么?
别听自媒体瞎扯什么马上破解RSA密码,那还远着呢。破解RSA需要几百万个逻辑量子比特,现在才做出来一个能用的,堆到几百万还得十几年,不用瞎操心。
最先吃到量子纠错红利的,肯定是药物研发和新材料模拟。
现在开发一款新的靶向抗癌药,找靶点找分子结构,临床前就得花五六年,一大半时间都在试错。为什么?因为经典计算机算不准大分子的量子相互作用,你算出来的结合能差一点点,实际实验就是完全不结合,白瞎大半年功夫,几百万经费就打了水漂。
要是有了几十个纠错过的逻辑量子比特,就能准确模拟小分子和蛋白靶点的相互作用,直接把试错范围缩小到原来的百分之一,开发新药的时间成本直接砍半,这不是吹的。不少跨国药企已经在盯着量子纠错的进展了,就等第一台可用的纠错量子计算机出来,立马就往药物研发上堆。
还有现在卡脖子的固态电池,找合适的固态电解质,全靠科学家一盆一盆烧材料试,十年都没找到能大规模商用的理想材料。有了量子纠错的量子计算机,直接就能算清楚不同晶体结构的锂离子传导率和稳定性,不用瞎试,研发速度至少提好几倍。
不过话说回来,现在也别吹得太神,毕竟现在也就做出来一个能用的逻辑比特,堆到几十个上百个,还得五到十年功夫。但你得承认,那层窗户纸已经捅破了。
之前量子计算就像盖高楼,盖到一半发现没有合格的承重墙,所有人都在想办法炼出合格的钢筋,现在第一根合格的钢筋已经炼出来了,接下来就是盖楼的事儿了。
说不定我们这一代人,就能在有生之年用上量子计算研发出来的抗癌新药,用上续航一千多公里的固态电池。
这事儿,想想都让人激动。