从故障惊魂到主动进化:混沌工程背后的系统生存逻辑
去年深秋在南京软件园,和几个做架构的朋友喝酒,聊起上半年的一次生产故障,本来只是一个边缘服务的内存泄露,结果愣是拖垮了首页的交易链路,整个团队熬了通宵才恢复,所有人都在骂——平时测试都好好的,怎么出点小问题就全崩了?
这不是个例。现在的分布式系统,服务拆得越来越细,依赖多到连开发自己都数不清。稳态从来不是天生的,你没主动找过问题,不代表问题不存在。
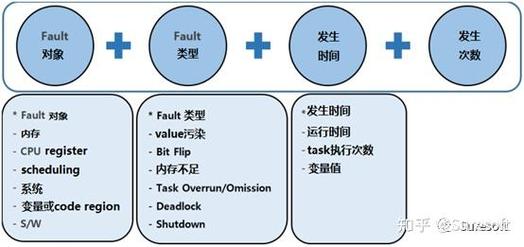 分布式系统混沌工程故障注入流程图
举个真实的例子,国内某电商平台,大促前做演练,故意关闭一个缓存集群,结果发现因为缓存预热的逻辑有bug,所有流量直接压到数据库,不到十秒数据库就打满了。提前三天发现问题,总比大促当天整个平台挂了好。说实话,就这一次演练,省了不知道多少损失,也省了多少人的年终奖。
不过话说回来,它也不是万能的。它只能找到你设计过、想得到的故障场景,那些完全超出预期的黑天鹅事件,比如运营商光纤被挖断,整个机房进水,它没法天天练,成本太高。
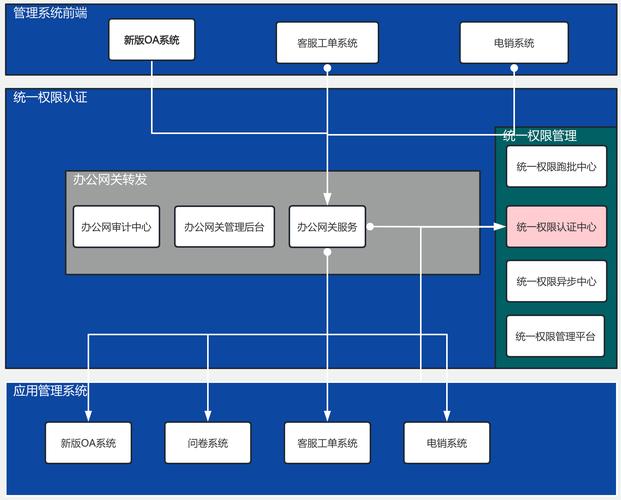 企业级混沌工程演练权限控制架构图
讲应用边界,不是所有系统都需要做。如果你是一个小型的单体应用,服务就一两个节点,核心逻辑也不复杂,花大成本搭这套东西,完全没必要。如果你的系统是几十个服务互相依赖,用户不能容忍五分钟以上的 downtime,那这个投入绝对值。哪怕你是金融核心交易系统不能随便碰生产,也可以把生产流量复制一份到影子隔离环境,在影子环境做演练,不影响真实用户,一样能拿到有效结果。
 容易被忽略的隐形陷阱
很多团队做完几次演练,没出问题,就觉得自己系统天下无敌了,这恰恰是最大的陷阱。
第一个陷阱,过度演练占用资源。为了满足演练要求,每个开发每个月都要抽好几天时间配合,本来排好的业务迭代被迫延期,最后变成了为了演练而演练,忘了本来目的是保障业务,不是走流程。
第二个陷阱,演练覆盖率迷信。很多团队追求100%的故障场景覆盖,其实没必要。真正能压垮系统的,永远是那几个核心场景,把核心场景验证好,比覆盖一百个边缘场景有用得多。而且你永远覆盖不了所有场景,真的。
第三个陷阱,权限风险。演练工具本身需要很高的系统权限才能注入故障,如果权限管理没做好,很容易变成黑客入侵的突破口,这个风险很多团队根本没考虑过。
现在行业里聊得越来越多,很多工具也越来越成熟,把原来很高的门槛拉低了不少。本质上它不是一套工具,是一种思维方式——承认我们做的系统本来就不完美,承认小故障一定会发生,所以主动去暴露问题,解决问题,而不是等问题找上门来再救火。
对很多团队来说,做完第一次成功的演练,最大的改变不是修了几个bug,是整个团队对系统的信心变了——哪怕出问题,我们也扛得住。
不是故意搞破坏,是给系统做极限体检
很多人第一次听这个概念,第一反应就是“没事干嘛断我服务器”,觉得就是运维闲得没事折腾开发。其实完全不对。它的核心逻辑很简单:复杂系统里,小故障一定会发生,你不主动试,它就会在你最忙的时候找上门——比如大促半夜,比如春节抢票峰值。 所有没经过故障验证的高可用设计,都是纸面文档。你说你做了异地多活,那你把主可用区断电试试,流量切得过去吗?你说你做了熔断降级,那你把依赖的下游服务全停了,核心交易还能跑吗?很多时候,配置写了,开关没开;逻辑写了,异常判断漏了边界。不试一把,你永远不知道哪里藏着雷。分布式系统混沌工程故障注入流程图
举个真实的例子,国内某电商平台,大促前做演练,故意关闭一个缓存集群,结果发现因为缓存预热的逻辑有bug,所有流量直接压到数据库,不到十秒数据库就打满了。提前三天发现问题,总比大促当天整个平台挂了好。说实话,就这一次演练,省了不知道多少损失,也省了多少人的年终奖。
不过话说回来,它也不是万能的。它只能找到你设计过、想得到的故障场景,那些完全超出预期的黑天鹅事件,比如运营商光纤被挖断,整个机房进水,它没法天天练,成本太高。
能落地的路径,从来不是一步到位
很多团队上来就雄心勃勃,要在生产全链路搞全量故障注入,结果直接把自己玩崩了。说实话,这种坑我听过不下五次了。能落地的实现路径,核心只有一个:永远把爆破半径控制在你能承受的范围里。 正确的节奏,一定是从小到大逐步推进。先在测试环境,玩单个实例的故障注入,比如杀进程、占满CPU,验证单个服务的容错能力,没问题了再去预发环境,玩整个服务实例组的故障,再然后才敢碰生产环境——生产环境也一定是先拿灰度流量、非核心服务试,慢慢扩展到核心链路。 必须讲清楚限制条件,没有这个条件,就是瞎搞。第一个,必须有明确的自动终止条件:当错误率超过5%,或者延迟超过两百毫秒,立刻终止演练,恢复所有服务,这个是红线,碰都不能碰。国内某SaaS厂商去年的演练事故,就是没设自动终止,开发手动终止的时候,已经影响了三成付费用户,最后赔了客户大几十万,还丢了好几个大客户。 第二个,必须做权限隔离,演练只能在允许的范围里操作,不能随便碰核心生产的关键节点。企业级混沌工程演练权限控制架构图
讲应用边界,不是所有系统都需要做。如果你是一个小型的单体应用,服务就一两个节点,核心逻辑也不复杂,花大成本搭这套东西,完全没必要。如果你的系统是几十个服务互相依赖,用户不能容忍五分钟以上的 downtime,那这个投入绝对值。哪怕你是金融核心交易系统不能随便碰生产,也可以把生产流量复制一份到影子隔离环境,在影子环境做演练,不影响真实用户,一样能拿到有效结果。
容易被忽略的隐形陷阱
容易被忽略的隐形陷阱
很多团队做完几次演练,没出问题,就觉得自己系统天下无敌了,这恰恰是最大的陷阱。
第一个陷阱,过度演练占用资源。为了满足演练要求,每个开发每个月都要抽好几天时间配合,本来排好的业务迭代被迫延期,最后变成了为了演练而演练,忘了本来目的是保障业务,不是走流程。
第二个陷阱,演练覆盖率迷信。很多团队追求100%的故障场景覆盖,其实没必要。真正能压垮系统的,永远是那几个核心场景,把核心场景验证好,比覆盖一百个边缘场景有用得多。而且你永远覆盖不了所有场景,真的。
第三个陷阱,权限风险。演练工具本身需要很高的系统权限才能注入故障,如果权限管理没做好,很容易变成黑客入侵的突破口,这个风险很多团队根本没考虑过。
现在行业里聊得越来越多,很多工具也越来越成熟,把原来很高的门槛拉低了不少。本质上它不是一套工具,是一种思维方式——承认我们做的系统本来就不完美,承认小故障一定会发生,所以主动去暴露问题,解决问题,而不是等问题找上门来再救火。
对很多团队来说,做完第一次成功的演练,最大的改变不是修了几个bug,是整个团队对系统的信心变了——哪怕出问题,我们也扛得住。