给AI穿“防弹衣”:聊聊对抗样本防御
去年跟南大的师弟去看他们实验室的自动驾驶路测,就出了个洋相。测试员在路边的停车标志上贴了张巴掌大的方格贴纸,纹路歪歪扭扭,我凑过去看,除了有点突兀啥也看不出,结果车载识别模型直接把它认成了限速60,一脚油门就过去了...吓得带队老师喊了半天刹车。你说离谱不?AI看世界,居然比我们瞎这么多。
AI也会“看错”?这不是bug是天生缺陷
这种能骗到AI的特殊输入,就是我们说的对抗样本。说白了就是给正常输入加一点人眼完全无法分辨的微小扰动,就能让AI以超过99%的概率输出错误结果。
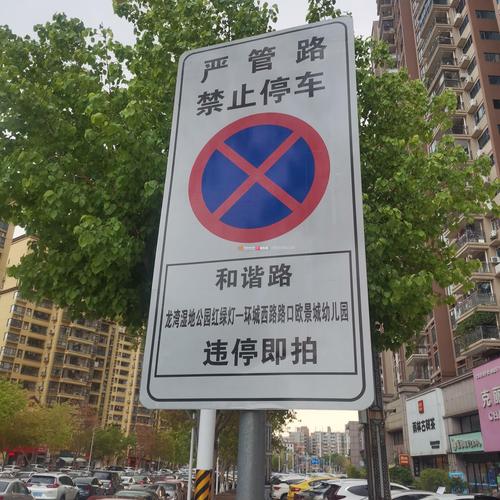 对抗样本干扰停车标志示意图
很多人第一反应是,这肯定是AI训练得不够多对吧?不对。这个问题是天生的。高维空间里,AI的分类决策边界本来就不是严丝合缝的,那些微小的扰动就刚好卡进了这些缝隙里,人类感知不到,AI却能被直接带偏。
说实话,我第一次做这个小实验的时候,把手写数据集里的数字7加了点扰动,人眼还是明明白白的7,模型直接100%置信度说是1,当时我盯着屏幕愣了半分钟。那时候才反应过来,原来我们日常用的AI,居然这么容易被骗。要是有人在小区门禁贴个小贴纸就能开门,往收费站的收费牌贴个东西就能让ETC识别成免费车道,想想都后背发紧。
现在主流的对抗样本防御,到底是怎么干活的
既然知道AI容易被骗,那怎么给它加防护?我接触最多、也最落地的就是对抗训练。说穿了也简单,就是把攻击者生成的对抗样本,混进原来的训练集里,再重新训练一遍模型,相当于给AI“见世面”——原来还有长成这样的假样本,下次别认错了。
类比一下,就像警校给学员看各种各样的假钞,连真票纸做的假钞都见过,真碰到了自然能认出来。还有一类思路叫输入纯化,就是AI识别之前,先给输入做个处理,要么加个模糊,要么压缩再重建,把攻击者加的扰动给磨掉,说白了就是给AI戴了个过滤眼镜,脏东西先滤掉再看。
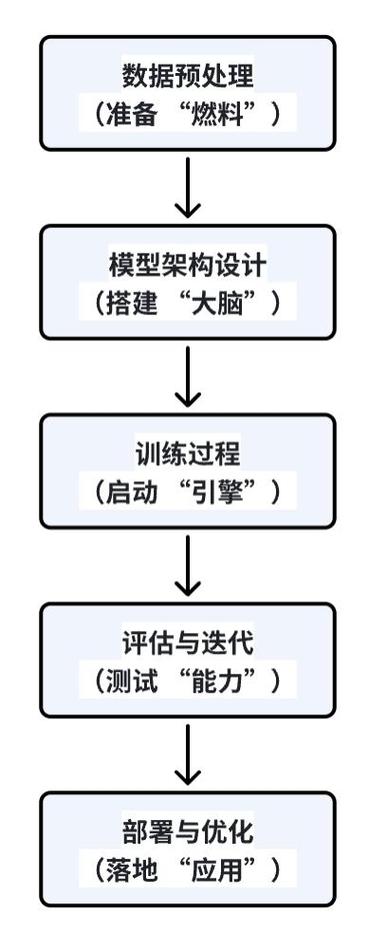 对抗训练优化AI模型流程图
对抗训练效果确实好,很多落地的项目都用它。但是代价嘛...真的感人。原来训练一次要三天,加了对抗训练至少要十天,还得先生成对抗样本,一来二去,大模型做一次全对抗训练,烧掉的算力成本够在二三线买套小房子首付了。
就是这么贵。不过话说回来,刚需场景该掏还是得掏。现在你用的刷脸支付,自动驾驶的视觉模块,手机端的人脸解锁,背地里都加了防御。只不过没人会把这个写在宣传页里,你用着方便,根本感觉不到。我之前跟业内朋友聊,他们说现在人脸验证的模型,至少能防八成常见的对抗样本攻击,要是没这层防御,早就被人玩坏了。
别神化,对抗样本防御的坑比你想的多
 别神化,对抗样本防御的坑比你想的多
我见过很多做产品的朋友,一听说有防御,就觉得这下稳了,AI不会被骗了。哪有这么好的事。
首先,道高一尺魔高一丈,你防御更新了,攻击者也会更新攻击方法,新的对抗样本分分钟就能绕过你现有的防御。之前就有圈内朋友做过测试,新出的十几种防御方法,不到一周就被新的自适应攻击全攻破了。
还有一个常见的误区,很多人觉得防御一定会降低模型的正常精度,其实也不一定。调好了对抗训练,反而能让模型对正常输入的泛化性更好,相当于顺便做了个正则化。但是调不好呢?就会出事。比如你输入纯化磨得太狠,正常的小猫图片磨成了小狗,本来对的也变成错的了。这个度,现在全靠工程师调参,没什么通用的方法论。
还有,现在所有的防御都是针对特定场景的,根本没有通用防御。你图像领域做得好好的防御,放到NLP的大模型对抗里,一点用都没有。现在大模型不是流行prompt注入吗?本质上就是文本的对抗样本,改几个词就能让大模型绕过对齐,输出乱七八糟的内容,现在还没哪个防御能百分百防住。对吧?我之前做过一个小测试,给开源大模型加了两种主流的防御,换了个说法的prompt注入还是直接就绕过去了,太无力了。
还有更扯的,现在很多论文里的防御,都是在标准数据集上刷准确率,换个真实场景的输入,准确率直接掉二十多个点,说白了就是凑成果,根本落不了地。
大模型火了之后,对抗样本防御反而变成更核心的问题了。多模态大模型能接收图片输入,做个带扰动的图片发过去,就能让它生成违规内容,要是用在自动驾驶、智能风控这些地方,出问题就是大事。
现在圈子里也在挖新方向,有的从因果推理入手,让AI学的是本质特征不是表面的相关性,有的从硬件入手,在传感器端就过滤掉扰动,还有的用大模型本身的能力做自防御,不过都还在试错阶段。没谁拿出一个完美的方案。至于最后哪条路能跑通,咱们走着瞧。