能藏秘密的数学魔术:零知识证明到底改变了什么
0923那天在南京江北的科创园咖啡馆,和做隐私计算的旧友聊了一下午,吵得邻座小姐姐频频回头。核心问题很简单,这个被资本、圈子吹得神乎其神的密码学技术,到底是真能改变规则,还是只是用来圈钱的空中楼阁。
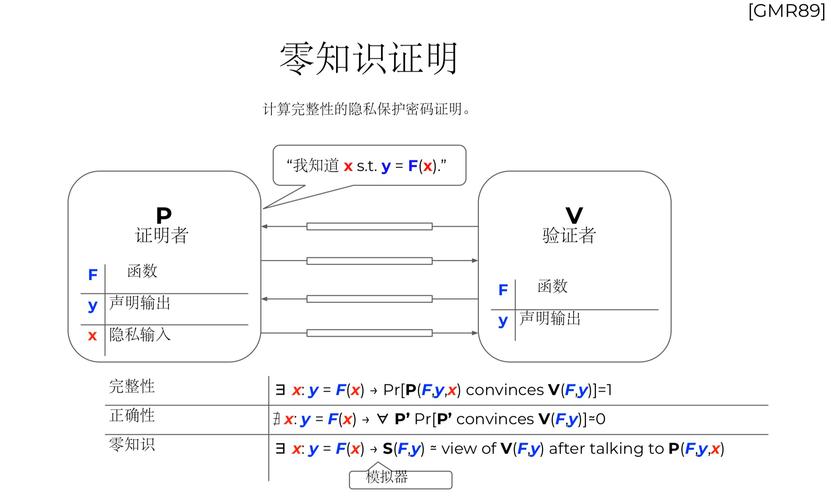 零知识证明交互式验证过程示意图
很多人搞混它和加密的区别。加密是为了让信息不被第三方看到,零知识证明是为了让第三方不用看到信息,就能相信你说的话。它不隐藏信息的存在,只隐藏信息本身,只证明信息符合某个预设的属性。
说穿了就是一场设计精巧的数学魔术。
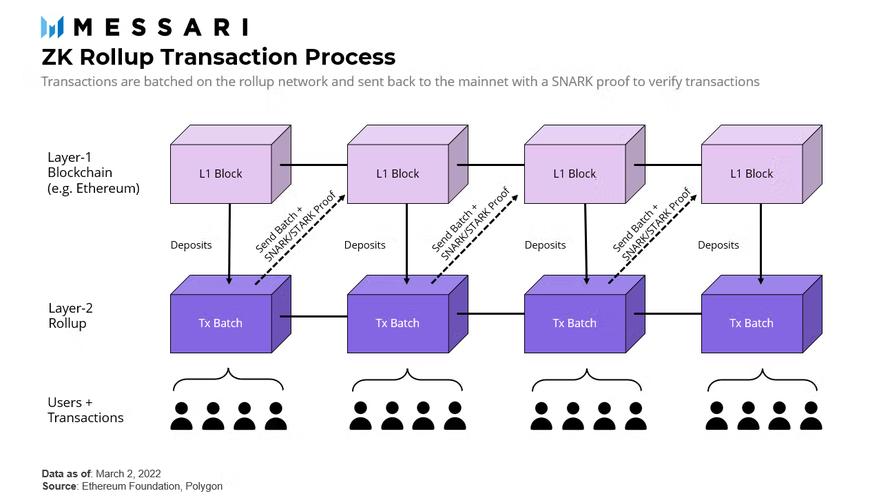 零知识证明ZK Rollup二层扩容架构图
 别被概念牵着走
说实话,现在大部分喊着做这个的项目,都是蹭热度。
很多场景根本不需要这项技术。比如做公开供应链溯源,所有数据本来就应该公开可查,你非要把数据藏起来搞证明,除了增加用户成本,拖慢系统速度,没有任何额外价值。
它的应用边界非常清晰:只有那些需要证明身份/资产属性,但又不能泄露原始隐私信息的场景,才值得用。比如区块链上的隐私交易,用户不想让所有人都看到自己的余额和交易对手;比如互联网身份验证,我要证明我符合银行开户的年龄要求,但不用把我的身份证号、家庭住址全都交给平台;再比如医疗数据联合建模,我要证明我的病历符合新药试验的入组标准,不用把我的完整病史共享给试验方。
但风险也非常明确。最大的争议就是隐私和监管的平衡,完全匿名的证明系统,给洗钱、非法资产转移留下了足够的操作空间,这也是为什么大部分国家对这类技术的落地都持谨慎态度,不会完全放开。
还有一个很多人不会说的误区:它只能证明命题符合计算逻辑,不能保证命题本身符合事实。比如我证明我拥有超过100万美金的加密资产,只能证明我持有对应地址的私钥,符合“余额超过100万”的计算条件,不代表这些资产的来源合法,也不代表这些资产真的属于我。
技术本身是中性的。现在递归证明聚合、硬件加速这些方向的迭代很快,成本一直在降,性能一直在提,未来在隐私计算、去中心化身份、Web3隐私这些领域,肯定会有真正接地气的落地。只是现在行业里炒概念的太多,真干活的太少,别听到“颠覆互联网”“完全隐私”就冲进去接盘。
毕竟,魔术再神奇,也变不出真钱。
藏起秘密,怎么证明你真的知道?
我知道一个公开哈希值对应的原像,我不想告诉你原像具体是什么,怎么才能让你相信我真的知道答案? 这就是整个问题的起点。 不同于普通人理解的加密——把信息锁起来,需要的时候再解开——这套协议从根上就不一样。它要做的,是在完全不泄露核心信息的前提下,让验证者相信某个命题是对的。三个核心性质缺一不可:完备性、可靠性、零知识性。 完备性很好懂:只要证明者真的知道秘密,一定能通过验证,不会被冤枉。可靠性是反过来:如果证明者在撒谎,根本不知道秘密,几乎不可能骗过验证者。最核心的是零知识性:验证者完成验证后,除了知道“证明者说的是对的”这个结论,拿不到任何额外的信息。 最早的方案都是交互式的,证明者和验证者要来回交互很多轮,才能完成验证,只适合两方一对一的场景。后来非交互式的方案出来,只需要生成一个证明,任何人都可以一次性验证,才终于能用在公开分布式网络里。零知识证明交互式验证过程示意图
很多人搞混它和加密的区别。加密是为了让信息不被第三方看到,零知识证明是为了让第三方不用看到信息,就能相信你说的话。它不隐藏信息的存在,只隐藏信息本身,只证明信息符合某个预设的属性。
说穿了就是一场设计精巧的数学魔术。
落地必须迈过的三道坎
原理讲起来简单,真要做成能用的产品,每一步都卡脖子。 第一关就是性能。生成一个合法证明,需要海量的计算量,哪怕是目前优化最成熟的方案,生成证明的算力消耗,也比直接验证原始数据多几十上百倍。Layer2扩容赛道里,证明生成延迟始终是用户体验的最大痛点,哪怕是头部项目,出一个跨桥证明也要等十几秒,更别说更大规模的应用了。现在很多团队在做硬件加速,用FPGA专门跑证明生成,速度能提几十倍,但成本又上去了,始终是 trade off。 第二关是电路正确性。所有的证明逻辑都要转换成算术电路写进协议,只要电路设计有一个微小的漏洞,攻击者就能生成假证明,而且根本没人能查出来。前几年就有头部扩容项目因为电路参数写错了一个位置,被人盗走了数千万美元的资产,直到今天,还有很多小项目直接抄开源代码,根本不做完整的形式化验证,埋了一堆暗雷。 第三关是可信初始化。大部分非交互式方案都需要一个共同的初始化参数,生成参数的过程如果被人动手脚,做参数的一方就能随便伪造证明,直接偷光所有资产。早年不少项目都是团队自己生成参数,被社区质疑了好几年,后来才有了多方参与的可信启动仪式,每个人出一部分随机数,只要不是所有人都合谋作恶,参数就是安全的,但流程太复杂,成本很高,小项目根本玩不起。零知识证明ZK Rollup二层扩容架构图
别被概念牵着走
别被概念牵着走
说实话,现在大部分喊着做这个的项目,都是蹭热度。
很多场景根本不需要这项技术。比如做公开供应链溯源,所有数据本来就应该公开可查,你非要把数据藏起来搞证明,除了增加用户成本,拖慢系统速度,没有任何额外价值。
它的应用边界非常清晰:只有那些需要证明身份/资产属性,但又不能泄露原始隐私信息的场景,才值得用。比如区块链上的隐私交易,用户不想让所有人都看到自己的余额和交易对手;比如互联网身份验证,我要证明我符合银行开户的年龄要求,但不用把我的身份证号、家庭住址全都交给平台;再比如医疗数据联合建模,我要证明我的病历符合新药试验的入组标准,不用把我的完整病史共享给试验方。
但风险也非常明确。最大的争议就是隐私和监管的平衡,完全匿名的证明系统,给洗钱、非法资产转移留下了足够的操作空间,这也是为什么大部分国家对这类技术的落地都持谨慎态度,不会完全放开。
还有一个很多人不会说的误区:它只能证明命题符合计算逻辑,不能保证命题本身符合事实。比如我证明我拥有超过100万美金的加密资产,只能证明我持有对应地址的私钥,符合“余额超过100万”的计算条件,不代表这些资产的来源合法,也不代表这些资产真的属于我。
技术本身是中性的。现在递归证明聚合、硬件加速这些方向的迭代很快,成本一直在降,性能一直在提,未来在隐私计算、去中心化身份、Web3隐私这些领域,肯定会有真正接地气的落地。只是现在行业里炒概念的太多,真干活的太少,别听到“颠覆互联网”“完全隐私”就冲进去接盘。
毕竟,魔术再神奇,也变不出真钱。