搞懂云原生可观测性:别再把监控当万金油了
不少公司迁完云,拆完微服务,突然发现一个尴尬的问题:出问题找不到根因了。
明明监控面板上CPU内存都好好的,用户就是说登不上、付不了款。十几个开发对着一堆黑盒服务抓瞎,翻日志翻到眼花,最后只能靠重启赌运气。
这就是没搞懂云原生可观测性的下场。
为什么云原生时代,老监控不好使了?
以前做单体应用,总共就几台服务器,盯牢CPU、内存、磁盘的使用率,出问题搜一下服务器上的日志,基本八九不离十。
现在呢?
服务拆成几十个上百个微服务,容器每天动态调度,今天这个Pod跑在A节点,明天就跑到B节点去了,调用链路绕得像蜘蛛网,一个请求从入口到数据库能串七八层服务。你还只监控机器指标,顶什么用?
老监控解决的,都是已知的未知:你知道哪里可能出问题,才会提前去埋点监控。可云原生环境里,大部分生产问题都是未知的未知——你根本想不到哪个依赖的隐性调用出了幺蛾子。
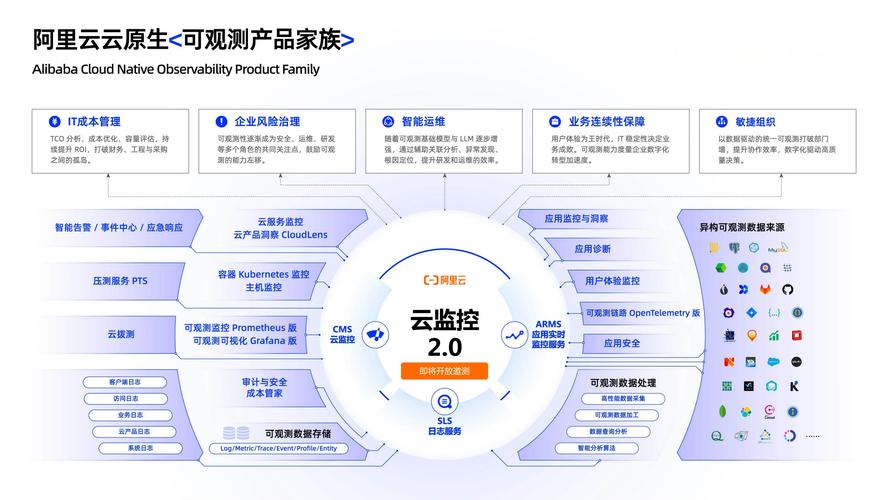 传统监控与云原生可观测性架构对比图
去年我帮一家电商公司排查问题,大促的时候首页加载慢了3秒,监控面板所有指标全绿,一群人查了四个小时才发现,是某个没在意的第三方广告服务超时,拖慢了整个链路。这种事,换老监控根本查不出来。
云原生可观测性的三大支柱,真的不是凑概念
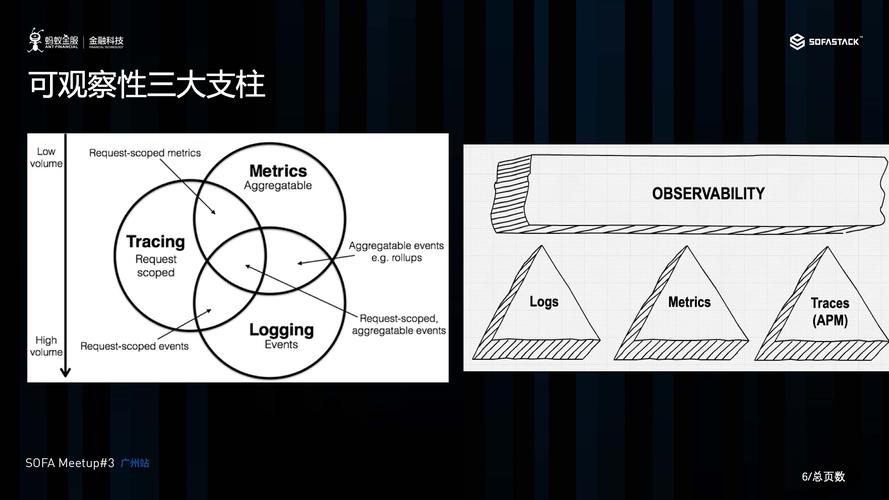 云原生可观测性的三大支柱,真的不是凑概念
现在圈内张口就是Metrics、Logs、Traces三大支柱,太多公司凑齐三个组件,就敢对外说自己落地了云原生可观测性。
说实话,大部分都是换皮。
Metrics指标,很多人还是只攒机器指标,根本不做业务指标和分位值统计。平均值骗死人你不知道?平均延迟100ms,背后可能藏着一堆P99延迟1s的请求,用户早就炸了,你监控上还看着一切正常。
Logs日志,不少还是把非结构化日志往ELK一扔就完事,搜索靠猜,关联靠人工,一个请求串了十几个服务,连个统一的TraceID都没有,找起来比大海捞针还难。
Traces链路,这个是重灾区,十个公司有八个做的是半吊子链路,只有核心入口埋了点,下游内部服务全没接入,出问题直接断链,等于白做。
CNCF去年的年度调研数据摆在这里:超过六成企业已经在生产环境用云原生可观测性,但是能做到全链路无断链的,不到两成。剩下的,都是凑数。
落地踩过的坑,给你拎几个最痛的
 落地踩过的坑,给你拎几个最痛的
我见过太多公司,一开始冲概念,最后做成了摆设。给你捋几个我亲眼见的大坑。
第一个坑:堆工具不做融合。Prometheus抓指标,Grafana画图,Jaeger追链路,ELK存日志,一套工具链下来,各个系统数据不通,查问题一会切这个界面一会输那个ID,反而比原来更慢。我见过一家创业公司,光维护这套可观测性工具,就养了三个运维,成本比不少核心业务都高。离谱。
第二个坑:全量埋点硬扛,性能崩了。为了不漏数据,所有请求全量打Trace,结果业务接口直接慢了两三百毫秒,业务方天天找上门骂,最后只能砍掉一半埋点,又回到出问题查不到的老样子。对吧?其实根本没必要全量,现在的智能采样,只采样异常请求、长尾请求,既不影响正常业务的性能,出问题又有数据可查,平衡才是关键。
第三个坑:只给运维用,和业务脱钩。很多可观测性平台满屏都是节点、Pod、容器的技术指标,产品经理、业务开发根本看不懂,出了问题还是只能找运维,来回甩锅。真正好用的云原生可观测性,一定是把技术指标映射到业务的——你打开面板就能看到,华南区支付失败率涨了3%,对应哪个k8s集群的哪个服务Pod退出率异常,一两步就能定位到根因,不用跨部门扯半天。
不过话说回来,这两年技术进化真的快,eBPF的普及真的解决了老痛点。之前有个客户,一堆跑了五六年的老Java服务,不敢改代码埋点,迁到云之后出问题根本查不了,最后用eBPF无侵入探针,直接把全链路数据拉出来了,省了大几百万的改造费用。太爽了。
现在圈里就爱吹概念,把云原生可观测性说得玄乎其玄,其实说白了,就是给你的系统装一双眼睛。能让你出问题十分钟定位,不用熬夜排查到凌晨,就是好的可观测性。别的都是虚的。