标签漂移与权重战争:联邦学习中的非独立同分布为何难缠
偏斜不是噪声,而是结构
客户端本地数据分布偏斜时,FedAvg的算术平均会制造一种错觉:参数在中心服务器上完成了融合,模型却在每个客户端上各说各话。标签分布偏斜、特征分布偏移、概念漂移、样本量不均,常被混成一个笼统的非独立同分布。可它们的失效路径并不相同。
标签偏斜会让本地目标函数的极小点彼此错位。某个客户端只见过少数类别,它的梯度方向会把共享模型往本地经验风险的低谷拉。中心端做加权平均,得到的不是共识,而是折中。折中有时可用。极端时,全局模型在少数类上几乎不学习。
 联邦学习客户端标签分布偏斜示意图
特征偏移更隐蔽。客户端输入空间的边缘分布不同,条件分布却可能一致。此时全局模型并非必然失效,但它学到的决策边界在本地可能落在低密度区域。概念漂移则更麻烦:同样的输入,标签语义不同。参数平均无法消解语义冲突,只会把冲突藏进聚合后的权重里。
样本量不均又是另一条线。按样本量加权,大客户端主导更新;改用均匀权重,又可能放大低质量本地数据的噪声。这里没有普遍解,只有对系统目标的取舍。
聚合的算术平均为何会失手
在凸且同分布的设定下,参数平均有较好的收敛解释。非凸、非独立同分布、每轮只采样部分客户端时,这些解释很快变薄。一个直接后果是客户端漂移:各本地模型朝各自方向走得太远,聚合回来的参数既不是全局最优,也不是任何客户端的局部最优。
FedProx用近端项把本地更新拉向全局模型,SCAFFOLD用控制变量校正本地梯度的偏差,MOON借对比学习约束表征漂移。它们都在处理同一个矛盾:本地适应与全局一致之间的张力。可条件很关键。近端项过强,个性化不足;控制变量要传额外状态,通信成本上升;客户端采样稀疏时,校正量的方差也会变大。
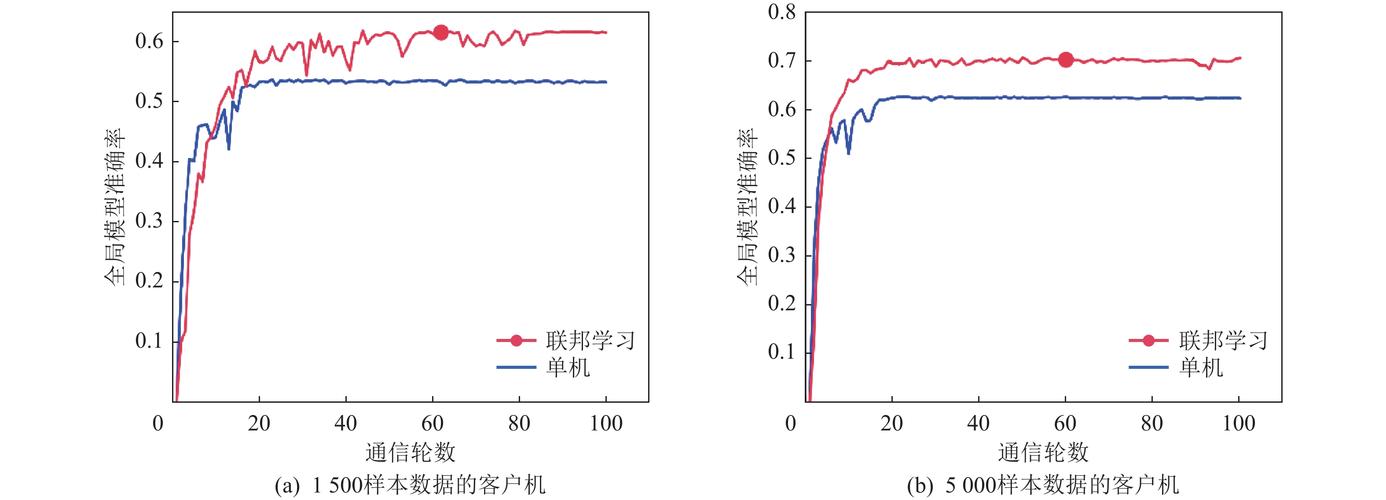 联邦学习聚合权重与客户端漂移收敛曲线图
还有一个常被忽略的反例:当标签缺失极端到某些客户端只含单一类别,正则化可能把模型拉回一个对本地几乎无用的全局解。此时问题不再是聚合公式不够精巧,而是共享表示与本地任务之间的可迁移性本身不足。
把个性化放回系统边界
 把个性化放回系统边界
实现路径大致分几层。共享底座加个性化头,适合特征有共性、标签语义相对稳定的场景;聚类联邦学习按分布相似性分组聚合,适合客户端群体存在潜在分簇;元学习把客户端当作任务,追求少量本地样本上的快速适应;知识蒸馏则绕开参数平均,在输出空间传递软信息。
个性化不是免费午餐。它削弱了全局模型的统一性,也改变了隐私与公平的边界。差分隐私噪声在样本量小的客户端上影响更大,个性化层又可能记住本地敏感信息。跨医院影像、跨设备键盘输入这些场景,数据偏斜与合规约束往往同时出现,方法选择必须把通信、隐私、鲁棒性放在一张表里权衡。
工程上更现实的做法,是把非独立同分布当作系统约束,而不是训练前需要清洗掉的脏数据。聚合策略、客户端采样、个性化层深度、控制变量更新频率,都应按分布结构设计。
验证与风险:全局精度会撒谎
 验证与风险:全局精度会撒谎
只看全局平均精度,很容易掩盖尾部客户端的退化。更可靠的评测要报告分位数精度、低分位客户端表现、校准误差和本地漂移监测。概念漂移场景下,还要区分输入分布变化与标签语义变化,否则调参可能调错方向。
风险也在暗处。非独立同分布会放大后门攻击的隐蔽性:恶意客户端可借本地偏斜把触发模式嵌进共享参数,而全局指标未必立刻报警。公平性问题同样棘手,聚合权重与本地样本量耦合,少数群体可能持续处于低分位。
趋势上,分层共享、动态聚类、个性化与全局约束的联合优化会更常见。但任何方案都有边界:客户端数量、采样率、通信预算、隐私预算一变,原先的收敛直觉就可能失效。把条件写清楚,比宣称某种方法普遍有效更有价值。