多模态对齐的缝隙:语义坐标被缝合之后
先把一个误解拆掉。多模态对齐不是把图像向量和文本向量拉到余弦相似度足够高就完事。真做项目的人知道,向量靠近只是表面现象,背后是粒度、任务和证据链的妥协。
我在产学研合作里见过一个典型场景:工业质检的图文报告,文本写“边缘毛刺轻微”,图像里毛刺只占几十像素。全局对比学习能把整张图和整句话对上,却对不上那个局部。检索看着漂亮,现场工程师不买账。这事没那么浪漫。
对齐不是融合,更不是把两种模态压成一种
很多讨论把对齐和融合混着说。对齐处理的是关系:图像区域、文本片段、视频片段之间能否建立可比较的语义坐标;融合处理的是决策:下游任务如何把这些表示拼起来用。两者相邻,但目标不同。**对齐的目标不是让两个向量长得像,而是让跨模态的语义关系可比较、可检索、可验证。**
以CLIP式全局对比学习为例。它把整图与整句拉进共享嵌入空间,靠大规模成对数据学习粗粒度对应。条件很明确:成对数据要足够多,任务偏全局语义。限制也很明确:组合性弱,否定和关系容易出错。“狗追猫”和“猫追狗”在词袋层面高度重叠,全局相似度未必分得开。这时需要区域—词 grounding、结构化先验或分布匹配式细粒度约束,而不是继续加大 batch 或温度系数。
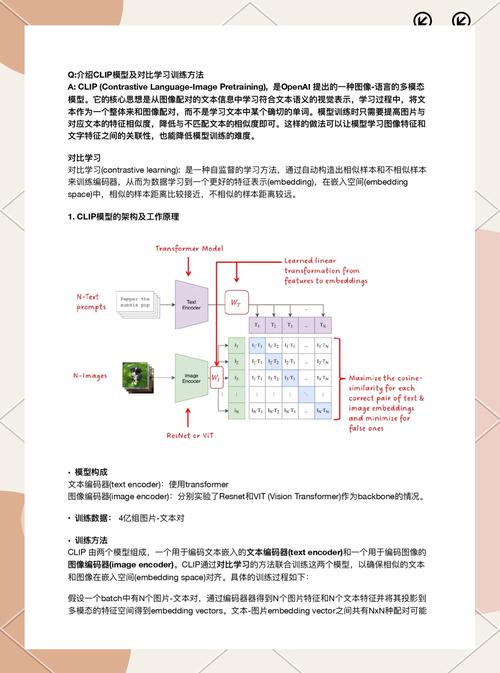 多模态对齐CLIP全局对比学习图文结构图
跨模态注意力是另一条路径。它让一种模态在另一种模态的上下文里选择证据,适合生成式桥接和多模态大模型。但注意力图好看,不等于语义对齐可靠。语言先验一旦过强,模型可能用常识补全视觉证据。医疗图文报告里,阴性发现常被省略,报告文本与影像区域并非一一对应。这时对齐误差不是“没对上”,而是“对上了不该对上的捷径”。
粒度错配才是硬骨头
文本有 token、短语、句子、篇章;图像有像素、区域、物体、场景;视频还有帧、片段、事件。粒度不对齐,监督信号就会错位。拿整句去约束整图,局部物体可能被背景吞掉;拿词去约束像素,又会遇到指代和歧义。**多模态对齐的误差往往不是“没对上”,而是“对上了不该对上的捷径”。**
细粒度对齐常见做法包括区域—词匹配、时序事件对齐、图结构约束和分布匹配。它们能缓解粒度错配,但各有条件。区域 proposal 的质量决定上限;时序对齐依赖事件边界标注;分布匹配对噪声敏感。生成式多模态模型用语言模型做桥接,表面看绕开了显式对齐,实际把对齐压力转移到了语言先验和指令数据上。数据干净时效果可观,数据带偏时幻觉也会被“对齐”得更像真的。
 多模态对齐医疗影像报告区域文本粒度对应示意图
我倾向于认为,粒度问题不能靠单一损失函数解决。它需要任务分解:检索要全局稳定,grounding 要局部可解释,生成要证据可追溯。三件事的评价标准并不相同。把它们压成一个对齐分数,挺让人懊恼。
评价这件事,比训练更让人不安
检索 Recall、零样本分类、VQA 准确率,能说明一些问题,却说明不了对齐质量。组合性、否定、关系、计数、分布偏移,这些维度一测就露馅。更麻烦的是成对数据本身有噪声:网页图文对里,文本可能只描述图像的一小部分;医疗报告里,正常发现常被省略;工业场景里,缺陷描述和缺陷区域未必严格对应。**如果评价只奖励全局相似度,模型就会学会用语言先验替代视觉证据。**
可行的验证路径包括反事实替换、区域遮挡、关系扰动和跨分布测试。它们不追求一个漂亮总分,而是追问:换掉关键区域,对齐表示是否变化;打乱关系,检索是否还能区分;遇到缺失模态,置信度是否校准。应用边界也在这里显形。开放世界长尾、低资源模态、隐私敏感数据,都会让对齐从“表示学习问题”变成“证据治理问题”。
 多模态对齐组合性反事实评估基准示意图
落地边界:可校准比可对齐更难
工业质检、医疗辅助、自动驾驶、具身智能,这些场景要的不是一个对齐分数,而是可校准的跨模态证据链。缺失模态时能不能降级,分布漂移时能不能报警,局部证据能不能回溯,这些比训练集上的对齐损失更接近真实需求。多模态对齐终究不是万能胶。它更像一份需要不断复核的测绘合同——坐标可以缝合,证据链不能省略。