容错计算技术:别再把‘备份’当救命稻草了
先别急着聊什么高可用架构。说个扎心的事儿:你机房里的服务器没挂,不代表算对了。
真的。宇宙射线打翻一个bit,内存里0变1,程序照样跑,结果悄悄错。很烦。这就是容错计算技术要收拾的烂摊子。它不是“多买两台机器”这么粗暴,背后是故障模型、冗余方式、恢复路径的一整套工程账。
一次单粒子翻转,能把“稳定”俩字打回原形
我见过太多团队把容错等同于备份。硬盘做RAID,电源做双路,交换机堆两台——这些当然有用。但它们主要防的是“整机挂掉”。可现实里更阴险的是瞬时故障,比如高能粒子轰击存储单元引发的单粒子翻转(SEU)。芯片没烧,系统没重启,某个寄存器里的值变了。你让上层业务怎么发现?靠日志?往往啥都没有。
航天器、汽车MCU、基站基带、金融交易网关,都怕这个。去年跟一个做星载计算机的朋友聊,他说他们最怕的不是大故障,是“看起来正常”。啧,麻烦就麻烦在这儿。
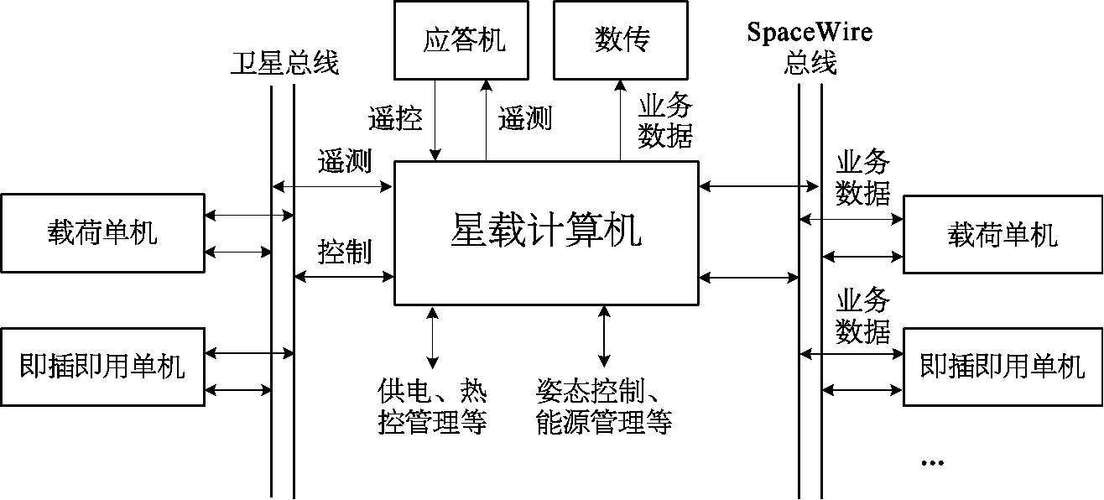 航天器星载计算机三模冗余容错计算架构示意图
所以硬件层面常见三模冗余(TMR):三份逻辑同时算,输出表决。少数服从多数。一个模块被粒子打歪,另外两个还能把它摁住。听着挺美,对吧?代价也直白——面积、功耗、成本大约三倍起。更尴尬的是,如果三个模块共因失效,比如供电塌了、时钟歪了,TMR也救不了。别神化任何单一手段。
更轻量的玩法是纠错码。内存ECC能在读的时候发现并纠正单比特错误,SECDED还能处理“纠正一比特、发现两比特”。数据中心里ECC内存条几乎是标配。可你猜怎么着?很多业务团队根本不看EDAC计数。机器报correctable error,没人理,等到不可纠正错误扎堆,才拍大腿。晚了。
纠错码不是万能药,锁步也不是
信息冗余这条路,本质是用校验位换可靠性。海量存储里还有Chipkill、RAID-6、纠删码,思路类似。科研圈这几年在做的,是把纠错码和存算一体、近存计算结合,降低校验开销。听着很前沿,落地却得看场景。你让边缘设备跑复杂LDPC?功耗先把你劝退。
汽车电子那边更爱提双核锁步:两个核跑同样指令,周期级比对。一旦不一致,报警、复位、切安全状态。ISO 26262功能安全体系里这套很常见。不过话说回来,锁步核解决的是CPU执行路径的故障,外设、总线、传感器呢?还得一层层补。容错计算技术从来不是一颗芯片的事。
 汽车MCU双核锁步容错计算故障注入实验台架图
我挺烦那种发布会话术:“我们支持硬件容错。” 然后一问故障注入报告,没有。问故障模型,说不清。问恢复时间,支支吾吾。说白了,没有验证过的容错,约等于心理安慰。
软件容错:检查点、重试,还有混沌工程这剂猛药
硬件不够,软件来凑。大型分布式系统常用检查点/恢复:把任务状态周期性落盘,节点挂了从最近检查点拉起。AI大模型训练尤其吃这套。几千张卡跑几周,不挂才怪。 checkpoint间隔设太短,I/O扛不住;设太长,一挂回滚几小时。这个权衡,真让人头大。
还有拜占庭容错。它假设节点不光会挂,还会“说假话”。区块链、联盟链里讨论得多。经典PBFT类协议通信复杂度高,工程上往往结合可信执行环境或轻量共识做折中。别一听拜占庭就觉得高大上,节点数一多,消息风暴能把你埋了。
云原生圈子这几年流行混沌工程。故意杀进程、注延迟、断网、灌脏数据。听着像捣乱?其实是主动找故障。Netflix的Chaos Monkey算早期代表,现在Kubernetes生态里故障注入工具不少。我的看法很直接:容错系统必须被故障反复摩擦。实验室里的完美架构,到了生产环境经常一地鸡毛。
 数据中心服务器内存ECC纠错码容错计算测试场景图
行业动态:Chiplet、RISC-V和AI加速器都在补容错课
Chiplet火起来之后,容错计算技术又多了新战场。多die封装,良率上去了,可互连故障、坏die屏蔽、冗余链路设计都得跟上。业内常用冗余互连和可重构路由,把故障区域绕过去。科研论文里还喜欢玩近似容错:不是所有计算都值得三模冗余,比如神经网络推理对少量位翻转没那么敏感,那就分层保护。省钱,也省功耗。这个思路挺务实。
RISC-V往汽车、工业控制走,功能安全认证是硬门槛。双核锁步、ECC总线、内存保护单元、故障收集单元,一个都不能少。国内不少团队在做的,是把RISC-V核和自研安全岛集成,通过故障注入验证覆盖率。说实话,这条路不轻松,但比堆PPT强。
AI加速器也有自己的麻烦。HBM容量大、带宽高,位翻转概率跟着涨。训练任务又长,检查点开销大。于是有人做弹性训练框架,有人做在线错误检测,还有人研究算法级容错——模型参数错一点,能不能自己扛住?目前看,推理侧容忍度高些,训练侧还得老老实实做校验和恢复。
所以下次有人跟你吹“我们做了容错”,先问一句:故障模型是什么?注入过没有?恢复时间多长?——这三个问题,比PPT上的“高可用”三个字有用多了。容错计算技术不玄乎,它就是把“可能出错”当默认前提,然后一层层设计退路。很土。但真管用。