别急着加机器:系统可靠性设计里一个反直觉的坑
凌晨两点十七分,手机在床头柜上震得像只漏电的蜂鸣器。我眯着眼看告警:订单服务超时率飙到 43%。心里咯噔一下。前一天我们刚把节点从 6 个扩到 12 个,压测报告漂亮得很。结果呢?一个配置中心实例内存泄漏,客户端重连风暴把线程池打穿,十二个节点跟多米诺骨牌似的,全躺。监控大盘绿得发亮,可用户那边已经炸锅。你说气不气人。
这就是系统可靠性设计很扎心的地方:它不负责让你“看起来稳”,它只负责在坏事情发生时,别让整条船沉底。
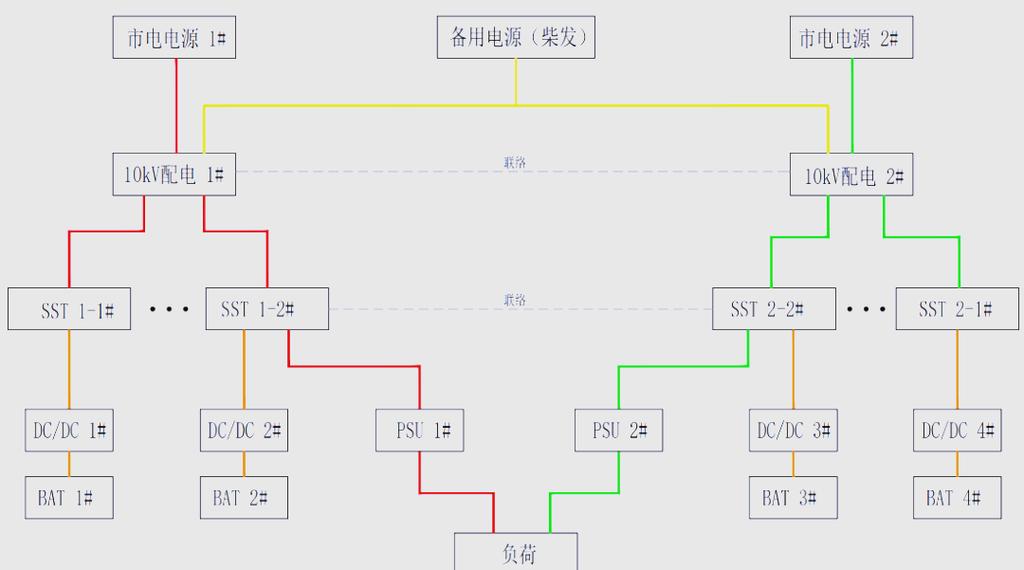 数据中心服务器双路电源冗余接线实景图
我常拿飞机液压系统打比方。它有三套冗余,不是因为它喜欢堆料,而是因为单套失效时,剩下那套还能把飞机落下去。注意,冗余的目标不是“永远不坏”,是“坏一套还能飞”。系统可靠性设计也一样,你得先画出故障树:哪些故障会直接掀桌子?哪些只是崴脚?单点故障——就是那种一坏全完的节点——必须被找出来。找不到,后面全是白搭。
 分布式系统单点故障故障域隔离示意图
所以做系统可靠性设计,别光看架构图上的框。要问:这两个框,共享什么?共享电源吗?共享网络出口吗?共享发布流水线吗?共享那个谁都不敢动的祖传定时任务吗?故障树和 FMEA(失效模式与影响分析)不是给评审看的 PPT,它更像一份“找茬清单”。把“一个配置推错,会不会全站崩”这种问题问出来,比加十个节点管用。
不过话说回来,冗余也有代价。节点多了,一致性、监控、发布复杂度全上来。你复制的是副本,不是免疫力。真要做,先把故障域切开,再做冗余。顺序反了,钱白花。
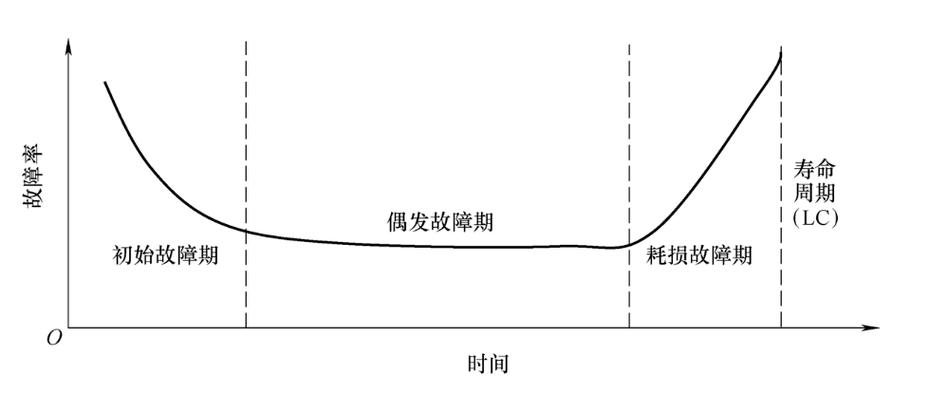 系统可靠性设计浴盆曲线故障率分布图
可观测性也得算设计的一部分。指标、日志、链路追踪,不是给老板看的大屏,是故障时的“黑匣子”。我见过太多系统,一出问题只能靠猜。你连哪个依赖先慢都说不清,谈什么快速恢复?MTTR 就是这么被拖长的。
还有演练。混沌工程听着玄,其实就是主动找茬:挑一个非高峰时段,把某个实例干掉,看流量切不切得走;把依赖的超时调短,看会不会雪崩。别一上来就在生产环境放火。爆炸半径先圈好,回滚预案先写好。可靠性是练出来的,不是祷告出来的。
一、可靠性不是“不出故障”,是“出了故障还能活”
很多人把可靠性理解成“别坏”。这不现实。硬盘会坏,网线会被挖断,机房会进水,人会手抖改错配置。对吧?靠谱的系统可靠性设计,前提是承认“一定会坏”,然后设计坏掉之后的活法。 工程上爱提 MTBF(平均无故障时间)和 MTTR(平均恢复时间)。别背定义。你就想:一个系统再能扛,也扛不住恢复得慢。MTTR 每缩短一半,用户感知的可用性往往提升一大截。修得快,比坏得少更现实。数据中心服务器双路电源冗余接线实景图
我常拿飞机液压系统打比方。它有三套冗余,不是因为它喜欢堆料,而是因为单套失效时,剩下那套还能把飞机落下去。注意,冗余的目标不是“永远不坏”,是“坏一套还能飞”。系统可靠性设计也一样,你得先画出故障树:哪些故障会直接掀桌子?哪些只是崴脚?单点故障——就是那种一坏全完的节点——必须被找出来。找不到,后面全是白搭。
二、冗余的幻觉:你复制的是节点,不是故障域
说个真事。某次巡检,我发现“双机热备”的两台数据库,宿主机在同一台物理机上。对,虚拟机分了两个,物理机只有一台。电源一掉,哥俩手拉手一起走。运维同事还委屈:配置里明明写了两节点啊。 你看,冗余不是数机器。冗余是隔离故障域。同一个机柜、同一路市电、同一台交换机、同一个配置中心、同一份没做灰度就全量推送的代码,都能把“双活”变成“双杀”。这在可靠性工程里叫共因失效——两个看起来独立的部件,因为同一个根因同时挂掉。分布式系统单点故障故障域隔离示意图
所以做系统可靠性设计,别光看架构图上的框。要问:这两个框,共享什么?共享电源吗?共享网络出口吗?共享发布流水线吗?共享那个谁都不敢动的祖传定时任务吗?故障树和 FMEA(失效模式与影响分析)不是给评审看的 PPT,它更像一份“找茬清单”。把“一个配置推错,会不会全站崩”这种问题问出来,比加十个节点管用。
不过话说回来,冗余也有代价。节点多了,一致性、监控、发布复杂度全上来。你复制的是副本,不是免疫力。真要做,先把故障域切开,再做冗余。顺序反了,钱白花。
三、把可靠性设计进日常:降额、隔离、可观测、演练
系统可靠性设计不是上线前突击一把。它得长在研发流程里。 先说服自己:容量别跑满。CPU 常年 85% 以上,不是“资源利用率高”,是“没给故障留缓冲”。这叫降额设计。跟电子元件降额使用一个道理,别让它在额定边缘蹦迪。留 30% 余量,突发流量来了才不至于一泻千里。 再就是隔离。舱壁模式听过吧?船底破了,舱壁把水挡住,别让一个舱进水淹了整条船。对应到系统里:线程池隔离、连接池隔离、租户隔离、读写分离。一个慢查询别把整个服务拖死。超时、重试、熔断、限流,这几个词都快被说烂了,但真配对的没几个。重试不是许愿。下游已经喘不上气,你还三次五次地拍门,那是重试风暴,不是可靠性。系统可靠性设计浴盆曲线故障率分布图
可观测性也得算设计的一部分。指标、日志、链路追踪,不是给老板看的大屏,是故障时的“黑匣子”。我见过太多系统,一出问题只能靠猜。你连哪个依赖先慢都说不清,谈什么快速恢复?MTTR 就是这么被拖长的。
还有演练。混沌工程听着玄,其实就是主动找茬:挑一个非高峰时段,把某个实例干掉,看流量切不切得走;把依赖的超时调短,看会不会雪崩。别一上来就在生产环境放火。爆炸半径先圈好,回滚预案先写好。可靠性是练出来的,不是祷告出来的。