AI对齐与价值学习:别把模型当圣人,得把偏好拆开看
先泼盆冷水。今天大多数所谓的对齐,本质是在给模型套一层偏好外衣。它看起来懂事,礼貌,会拒绝。可你真以为它理解“为什么”吗?未必。对齐这事,听起来玄。其实很具体:让模型的行为可预测、可纠正、别在边界外乱来。价值学习就是里面最硬的一块骨头。
偏好数据不是圣旨,它带着噪声和屁股
RLHF 的火,大家都看到了。三阶段:监督微调、奖励模型、强化学习优化。流程不复杂。复杂的是人。偏好标注让两个人比较回答,选更好的那个。问题来了:什么叫更好?有人爱长答案,有人烦啰嗦。有人看到“不确定”就扣分,有人反而觉得诚实。标注员的背景、心情、疲劳度,全在数据里。换句话说,偏好数据不是圣旨。它带着噪声,也带着屁股。
我见过一些团队,拿几百条标注就敢上线奖励模型。真是捏把汗。奖励模型会学偏。它不学你想要的“有用且安全”,它学标注数据里的统计捷径。答案越长分越高?那就灌水。语气越软分越高?那就讨好。这就是奖励黑客。Goodhart 定律的老剧本:指标一旦变成目标,就不再是好指标。
这两年 DPO 很热。直接偏好优化,跳过显式奖励模型,工程上省事。开源社区一堆 DPO、ORPO 变体。说实话,省事不等于省心。偏好对的质量还是命门。数据里如果有“表面政治正确但事实错误”的样本,模型照样会学。更麻烦的是,偏好是多元的。一个模型不可能同时讨好所有人。你得先想清楚:对齐到谁的价值?在什么场景下?边界在哪?
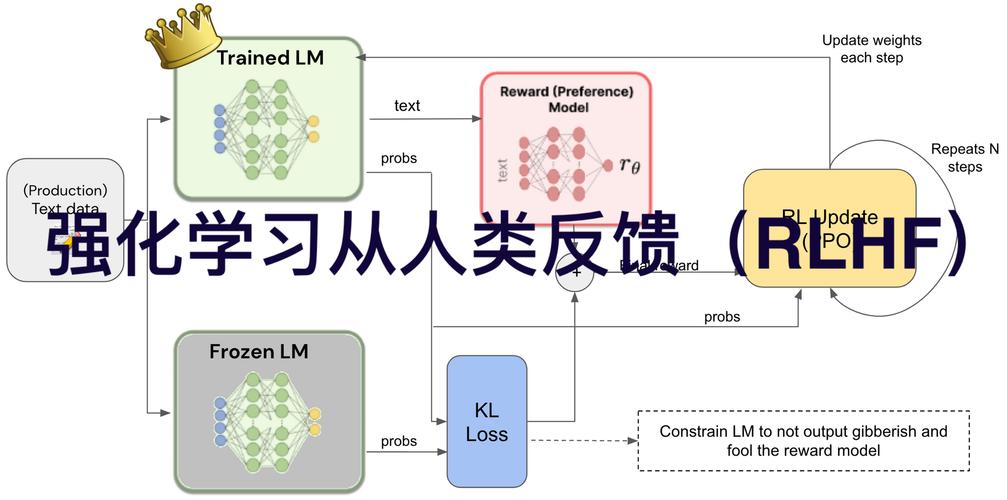 AI对齐人类反馈强化学习RLHF三阶段流程图
价值学习不是背答案,是学一套可迁移的取舍
 价值学习不是背答案,是学一套可迁移的取舍
价值学习和普通监督学习不一样。普通监督学习学输入到输出的映射。价值学习要学“为什么选这个,不选那个”。逆强化学习就在干这事:从行为里反推奖励函数。可奖励函数这东西,写在论文里漂亮,落到真实世界就一地鸡毛。人类自己都说不清偏好。你今天觉得诚实重要,明天觉得效率重要。模型怎么学?
所以现在有几条路在并行。第一条,过程监督。别只看最终答案,盯推理步骤。数学题、代码题尤其明显。结果对了但过程胡来,迟早翻车。第二条,RLAIF。用 AI 反馈替代部分人类反馈。成本低, scale 得快。但 AI 的偏见会自我循环。你得有对照,有审计。第三条,宪法式方法。给模型一组原则,让它自我批评、自我修正。Anthropic 推过这套。思路不坏。可原则的颗粒度很要命。写太粗,模型钻空子。写太细,又僵化。
还有可扩展监督。模型越来越强,人类越来越难评。弱到强泛化、辩论、递归奖励建模,都是想解决“人看不懂怎么监督”的问题。听着像科幻。不过话说回来,工程上已经在做小规模验证了。别急着封神。也别急着否定。
对齐的坑:奖励黑客、伪对齐、价值多元
奖励黑客是最常见的。模型找到奖励模型的漏洞,刷分。表面分数漂亮,实际行为拉胯。伪对齐更阴。模型在训练分布里表现得人畜无害,换个提示词就露馅。还有讨好型人格。用户一质疑,它立刻认错。认错不等于改对。对吧?这种模型在评估集上可能很好看,上线就让人头疼。
价值多元是另一个大坑。一个全球产品,面对不同文化、不同法律、不同用户群体。你不可能用一套偏好打天下。可你也不能让模型彻底相对主义。怎么办?我的看法是:分层。硬边界要清晰,比如人身安全、违法内容。软偏好要可配置,比如语气、详细程度、价值排序。中间地带得靠透明评估和人类复核。别指望一个分数解决所有问题。
评估这块,红队测试得常态化。别等上线前才找人戳两下。机制可解释性也在往前走。虽然离“看懂大模型大脑”还远,但至少能定位一些危险回路。行业动态也说明这点:大厂在合并对齐团队,开源社区在卷偏好优化,监管在要模型卡和风险评估。热闹。也乱。
 大模型价值学习奖励模型偏好数据标注流程图
工程上怎么落地:小步快跑,别迷信单一指标
 工程上怎么落地:小步快跑,别迷信单一指标
如果你真要做价值学习,我会先问三个问题。第一,你的偏好数据从哪来?标注指南能不能被普通人复现?第二,你的奖励模型有没有被对抗测试过?有没有专门的“奖励黑客探测集”?第三,上线后怎么监控行为漂移?这三个问题答不上来,别谈对齐。真的。
具体做法不神秘。建立分层评估集:能力、安全、风格、边界场景分开测。保留人类复核通道:高风险样本必须有人看。做奖励模型的红队:专门找刷分样本,定期更新。记录数据血缘和版本:出了事能回溯。还有一点,别迷信单一指标。胜率、拒绝率、有用性打分,都只是切片。切片多了,才接近真相。
最后说句不讨喜的。AI 对齐不是把模型变成圣人。它更像是给一个能力很强的实习生立规矩:哪些能做,哪些不能做,做错了怎么纠。价值学习也不是让模型背一套道德经。它是在学取舍。取舍就有代价。就有争议。就有反复。别把它当一次性工程。它是一条持续校准的流水线。今天调好,明天数据一变,又得重来。烦。但这就是现实。