显存里那本翻烂的账本:大模型推理优化到底在省什么?
晚上十点半,压测群又炸了。客服机器人昨天还跑得好好的,今天上了个长对话场景,延迟突然像坐电梯——上去了就不下来。老板问:加机器?我盯着监控里那块GPU,算力利用率不高,显存倒是快满了。哎,这事吧,真不是一句“加卡”能糊弄过去的。
大模型推理优化,听上去像个大筐。其实落到线上,很多时候就卡在一个很具体的地方:KV Cache把显存吃穿了。你省下了重复计算,转头就欠下一笔显存账。挺像合租屋里那个塞满的冰箱——你以为囤的是方便,开门才发现连盒鸡蛋都放不进去。
显存不是仓库,是条窄巷子
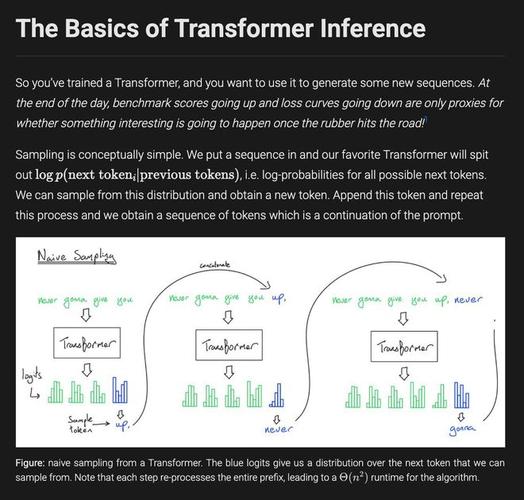
先把镜头拉近。大模型生成文字,是一个词一个词往外蹦。每蹦一个词,模型都要回头看前面所有词。要是每步都把前文重新算一遍,算力烧得飞快,延迟也难看。于是有了KV Cache:把历史token的Key和Value存下来,下一步直接拿来用。
省计算,对吧?对。但代价是显存。
这个缓存不是固定的。对话越长,它越胖。并发越高,它越胖。长上下文一开,那真是肉眼可见地胀。推理阶段还分两段:prefill阶段像搬砖,计算密集,把整段提示词先啃一遍;decode阶段像挤牙膏,每步只出一个词,计算量不大,可每步都要把KV Cache从头读到尾。decode阶段经常不是算不动,是显存带宽跟不上。GPU利用率看着不高,延迟却下不来。这误会,我见过太多次。
 大模型推理KV Cache显存占用示意图
有回排查一个线上服务,单请求延迟抖得厉害。看算力,不像瓶颈;看显存,水位贴着上限。batch只能开得很小,一开大就OOM。你说气不气?明明卡还在那转,活却接不进来。
KV Cache:省下来的计算,转头变成显存账单
KV Cache到底怎么算账?粗略讲,它跟层数、注意力头数、头维度、序列长度、batch大小都挂钩。序列翻倍,缓存跟着涨;并发翻倍,也涨。长上下文场景里,这玩意儿能占到大头。模型权重是固定房租,KV Cache是流水开销。流水一高,房东脸色就不好看。
那怎么办?工程上常见几招,别乱抡。
分页管理。PagedAttention这路子,像操作系统管内存:把KV Cache切成固定大小的块,用块表做映射。请求不必占一整段连续显存,碎片少了,并发能往上提。vLLM把这套带火之后,很多服务端框架都在借鉴。可它也不是白给——块表本身有开销,调度复杂度上来了,短请求特别碎的场景未必都划算。
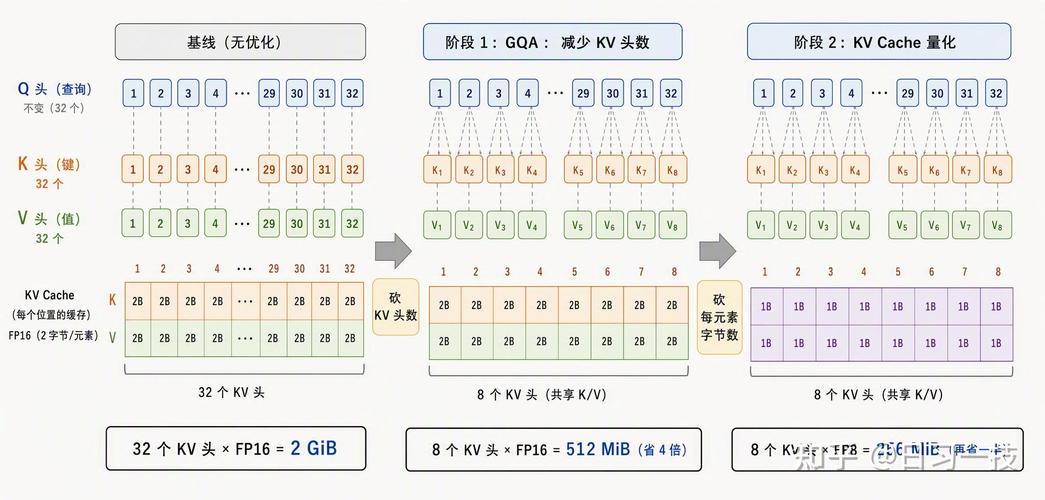
减KV头数。MQA、GQA这类结构,让多个查询头共享少量KV头。缓存体积能降不少。代价呢?表达能力和效果要重新评估。别拍脑袋换结构,拿业务集测。客服问答和代码补全,对损失的敏感度不一样。
量化KV Cache。用更低位数存Key和Value,显存占用往下压。听上去很香。可长文推理、数值敏感任务里,精度损失可能冒头。量化不是无痛针,得看场景。
 PagedAttention大模型推理KV Cache分页管理结构图
还有前缀缓存。相同开头反复出现时,直接复用算过的KV。系统提示词很长、多轮对话共享上下文的场景,收益挺直观。但命中率依赖流量形态。用户开场白千奇百怪,你缓存了个寂寞,也正常。
再就是连续批处理。不同请求动态拼批,别让短请求等长请求。吞吐能上去。可尾延迟会抖,调度策略得细抠。chunked prefill把长提示切块,和decode混跑,也是为了别让一个大请求把整条巷子堵死。
三板斧别乱抡:落地时看什么
说实话,优化这事得先看瓶颈在哪。拿个监控就看:prefill耗时占比多少?decode每步延迟多少?显存水位和带宽利用率什么关系?batch扩大后吞吐涨不涨、尾延迟崩不崩?这些数不看,直接上分页、上量化,容易白忙。
我见过一种典型翻车:为了提吞吐,把batch拉大,结果KV Cache把显存顶满,调度器开始频繁换入换出,延迟反而更难看。还有一种,盯GPU算力利用率,看它不到七成,就以为没吃饱。decode阶段本来就可能带宽受限,算力闲着不丢人,显存带宽打满才是信号。
先分清prefill和decode,再谈优化。prefill偏计算,decode偏显存带宽。两个阶段的脾气不一样。你要是拿prefill的招去治decode,常常药不对症。
 GPU显存带宽与大模型推理解码延迟关系图
还有个容易忽略的点:多租户隔离。前缀缓存共享做不好,可能把别的请求上下文带出来。权限、租户边界、缓存键设计,都得提前想。省显存不能把安全省没了。
边界就在那儿,别假装看不见
 边界就在那儿,别假装看不见
KV Cache优化不是无限续命。长上下文还在变长,注意力计算本身还是随长度增长。分页能减碎片,不能消灭总量。量化能压体积,不能白送精度。前缀缓存能复用,不能保证命中。连续批处理能提吞吐,可能牺牲尾延迟。
所以我现在看大模型推理优化,不太信“一招通吃”。先看业务:是长文摘要,还是短问答?是稳定流量,还是尖峰明显?再看指标:吞吐、尾延迟、显存水位、单位请求成本。然后小步试,留回滚。别一上来就大改。
哎,说白了,KV Cache像本账本。你省下的计算,都会记在显存那页上。工程做的,就是让这本账别翻烂。翻到边界,认。翻过头,线上会教你做人。