代码大模型落地三年:被高估的语法补全,被低估的工程重构
去年深秋在南京江宁的智能制造产业园蹲了两周,跟着本地一家工业控制企业的研发部做存量系统的迭代。最初团队的预期很乐观,以为接入成熟的代码大模型能砍掉30%的重复劳动,最后算下来,真正产生价值的部分,是把原本要花4个月梳理的2018年遗留采集代码,压缩到了6周完成。
说真的,刚看到厂商演示一键生成整套工业控制代码的时候,我差点当场掏出预算表。结果第一次实测就给我们整出了大问题——模型生成的边缘端通信代码语法全对,却把测试环境的内存地址硬编码进了生产逻辑,直接把产线的测试服务器搞到重启。
被误解的训练范式:不是背语法,是学工程逻辑
很多人对这类模型的认知还停留在“能写Python、能刷算法题”的层面,觉得它的核心能力是记住不同编程语言的语法规则。这其实是完全的误解。带提交记录的真实工程化代码片段,占了这类模型训练语料的70%以上,单文件的算法题、练习题代码占比不到2%。
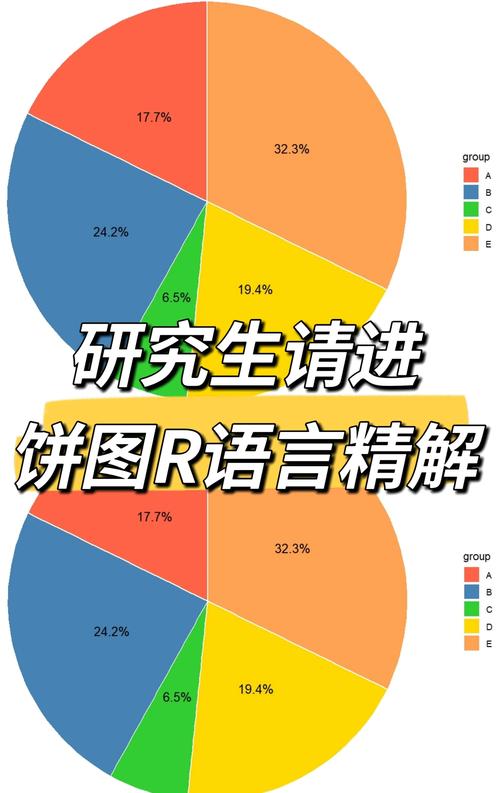 代码大模型训练语料构成占比饼图
换句话说,它从训练阶段接触的就不是孤立的代码知识点,是真实项目里“谁在什么场景下,为了解决什么问题,改了哪几行代码”的完整决策链路。但这并不代表它能直接适配所有工业场景——我们当时测试的西门子私有PLC协议对接代码,模型根本没接触过对应的私有实现规范,生成的代码看起来逻辑通顺,实际上连协议帧的校验位都写错了。
别信演示里的一键生成整套系统。
那是筛了上百次prompt挑出来的效果。
跨场景适配的隐形门槛:上下文窗口的真实边界
过去一年行业里一直在卷上下文窗口的大小,从几万token到几十万甚至上百万token,宣传口径永远是“能塞下整个项目的所有代码”。但真到了实际落地场景,大家会发现一个很尴尬的问题:就算你把项目里所有文件都塞进窗口,模型还是搞不清跨文件的依赖关系。
我们当时对接的那个老系统,核心模块一共127个代码文件,互相的调用关系散落在配置文件、宏定义、甚至是2017年离职员工写在代码边角的注释里。模型根本识别不出来哪个函数是被哪个定时任务触发的,哪个变量的修改会影响下游的传感器采集逻辑。跨文件的依赖关系追踪,从来不是靠窗口塞得下多少文本就能解决的问题。
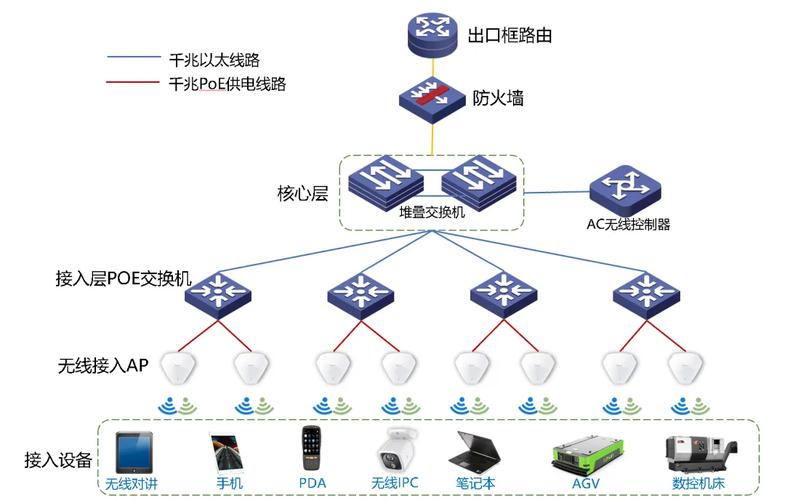 工业软件跨文件依赖调用关系拓扑图
我们做过一组实测:当单个项目的代码量超过50万行,就算用当前最大的上下文窗口,模型对依赖关系的识别准确率会从初始的82%直接掉到31%,根本没法支撑实际的工程修改需求。之前有做模型的厂商过来演示,说能一键梳理全项目的依赖关系,结果当场把三个核心配置文件的调用链路搞混,演示完灰溜溜走了。
现在行业里真正在推进的落地路径,根本不是一味堆窗口大小,而是做轻量化的代码知识图谱嵌入——提前把项目里的函数调用、变量引用、配置关联这些关系抽出来,做成结构化的可检索库,模型生成代码的时候,先去检索对应的关联关系,而不是硬读所有原始文本。这种方式的资源占用只有大窗口模式的1/5,依赖识别准确率反而能稳定在75%以上。
哪些场景真能用,哪些场景绝对碰不得
 哪些场景真能用,哪些场景绝对碰不得
经过这两年的落地验证,产业园里的几个研发负责人已经摸出了比较清晰的应用边界。一类是确定性高、重复度高的场景,模型确实能省不少力气。比如我们当时做的遗留代码梳理,让模型逐行给没有注释的老代码生成说明,再由熟悉项目的工程师过一遍修正,整体的准确率能到76%,比刚毕业的新人从头读代码快三倍还多。再比如测试用例生成,根据现有函数的输入输出规则,生成覆盖边界值、异常值的测试用例,覆盖面甚至比资深测试工程师写的还全。
但涉及核心安全逻辑的场景,哪怕模型生成的代码测试全过,也绝对不能直接用。去年南京江北有个做储能系统的企业,图省事直接把模型生成的电池均衡控制代码上了测试台,模拟场景下所有指标都正常,结果实际运行的时候,模型把电压采样的阈值设错了,导致一组电池过充,光电池组的损失就有两百多万。类似的还有产线的急停控制模块、涉及人员安全的防护逻辑,这些场景的代码容不得半点错漏,模型的黑箱决策特性根本适配不了。
更有意思的是,很多人担心这类模型会取代程序员,实际落地下来根本不是这么回事。它接走的只是那些重复的体力活——比如写重复的CRUD接口、写格式化的日志打印代码、生成固定格式的文档注释。真正需要结合现场场景做架构设计的部分,模型根本替代不了人。比如我们当时要设计一套适配十几种老旧型号传感器的统一采集框架,模型给的三个方案全是网上能搜到的通用开源框架,根本适配不了现场那些服役了十五年的老旧传感器的私有通信逻辑,最后还是三个工程师熬了两个礼拜,改了七版才把框架跑通。
上周跟产业园的几个CTO聊天,大家现在的共识已经很一致了:别追着模型的参数大小跑,也别信什么“通用代码生成”的噱头。对制造类企业来说,真正有价值的从来不是模型能生成多少行全新的代码,而是能不能把手里攒了十几年的几十万行老代码盘活,能不能把工程师从重复的体力活里拉出来,去解决真正卡脖子的现场问题。
工具而已。
用得好是杠杆。
用不好,就是给自己的项目埋雷。