别被路边的小贴纸骗了——聊透没人明说的对抗样本防御
去年9月23号在南京绕城高速辅路那段,我们的测试车离那个贴了三条黑竖线的限速牌还有120米的时候,原本识别成“限速60”的结果突然跳成了“禁止通行”,系统直接触发了紧急制动,跟在后面的厢式货车按了一路喇叭,离我们的后保险杠只差不到半米。 我当时坐在副驾,攥着扶手的手全是汗。 后来拆了系统日志才发现,那三条人眼一眼就能看出来的黑竖线,就是专门用来骗视觉模型的对抗样本——我们花了快半年训练的路牌识别模型,就被路边五毛钱打印的黑色贴纸给骗了。
你以为的“安全”,可能只是没遇到过瞎画的人
好多人第一次听对抗样本的时候,总觉得这是黑客才会用的高级手段,要写几页代码、搞复杂的梯度计算才能生成。真不是。
你随便找一张熊猫的照片,在上面叠一层人眼根本察觉不到的细碎噪点,AI的图像分类模型能99%的置信度把它认成长臂猿。你在路牌上随便画两笔歪歪扭扭的马克笔线条,自动驾驶的视觉系统就能把“限速80”认成“禁止左转”。
说白了,AI认东西的逻辑跟人完全不一样。人是看整体轮廓、颜色、纹理这些有意义的特征,AI是抓那些像素级的细碎关联——比如熊猫耳朵上某个位置的像素值高了10,模型训练的时候刚好把这个特征跟长臂猿的毛发关联上,那不管整体看起来多像熊猫,它都觉得这就是个长臂猿。
而对抗样本防御,就是给这个认死理的AI装个“防骗提醒”,别被那些细碎的小扰动牵着鼻子走。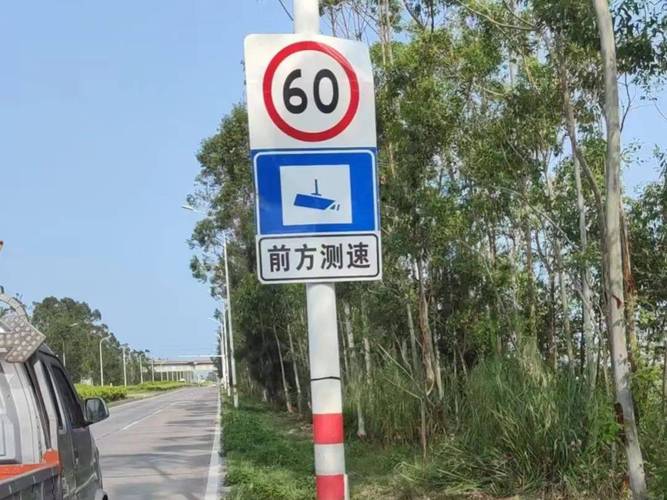 自动驾驶路测中被贴黑条的限速标识牌实拍
说起来好笑,我第一次在实验室看到这个效果的时候,整个人都傻了。之前总觉得我们训练的模型识别率能到98%,已经够安全了,结果被一张加了噪点的熊猫图直接打回原形。哪有什么牢不可破的模型啊,无非是没遇到过专门钻它空子的人。
别迷信“万能防御”,我踩过的三个最蠢的坑
刚开始做防御的时候,我跟好多人一样,总觉得能找到一个一劳永逸的方案。踩了无数坑之后才发现,那些吹得神乎其神的“万能防御”,大多是实验室里的自嗨。
第一个坑,就是把对抗训练当成万能药。
我们花了三个月,把几千张加了不同扰动的对抗样本塞进训练集,看着模型在测试集上的防御成功率冲到95%,差点就开香槟庆祝。结果第一次上路测,遇到有人在路牌上贴了半张外卖小广告,模型直接把“限速40”认成了“行人通行”。合着我们训的模型,只认识我们故意加的那些标准扰动,遇到现实里乱七八糟的随机干扰,直接就懵了。
第二个坑,是迷信那些“输入预处理”的玄学。
之前看到开源方案说,只要把输入的图片随机压缩一下、裁个边、加个随机的噪点,就能把对抗扰动的效果消掉。我们照着改了代码,一测,防御成功率确实涨了,但是正常路牌的识别率直接掉了30%——本来能认出100米外的限速牌,现在压缩之后,50米外都看不清楚数字是啥。防御没做好,先把核心功能搞崩了。
第三个坑,是信论文里那些漂亮的测试数据。
好多论文里说自己的防御方案能挡住99%的对抗攻击,你真的细看测试条件就会发现,人家是用已知的攻击方法生成的对抗样本做测试,相当于先把考题给透了,再去考学生,分数能不高吗?真到开放道路上,什么阳光反光、树叶挡一下、雨天的水痕印在镜头上,这些乱七八糟的变量堆在一起,之前测的99%的成功率,能剩10%都算不错。 机器学习模型对抗攻击与防御原理示意图
我上次跟同行喝酒聊起这个,他说之前在某大厂做防御方案,为了应付测试集,专门针对测试用的攻击方法调了三个月参数,最后上线的时候,被用户上传的一张带特殊纹理的自拍照直接骗开了人脸支付的验证。说起来都是泪。
现在能落地的防御,根本不是什么黑科技
折腾了快一年,我们最后在测试车上落地的防御方案,说出来你可能都不信——根本不是什么复杂的前沿模型,就是最朴素的冗余设计。 简单说就是,别让摄像头一个传感器说了算。 摄像头识别到前方有路牌,说这是“限速80”,别急着把结果传给决策系统。先喊雷达过来对一下:这个目标的距离是多少?实际物理尺寸跟标准路牌差多少?再翻一下高精地图:这个位置是不是本来就该有个限速牌?三个维度的信息都对上了,才把这个识别结果当真用。我们花了几百万迭代的防御方案,最后落地的核心逻辑,本质上就是“不要完全相信单个传感器的判断”——这是做工程的人都懂的冗余设计,根本不是什么顶会论文里的前沿魔法。你想啊,路边贴个假的限速贴纸,摄像头可能真的会被骗,但是雷达测出来这个“牌子”的尺寸比正常路牌小一半,距离还不对,高精地图里这个位置根本没有路牌,三个条件对不上,系统直接就把这个假牌子的结果扔了,根本不会触发急刹。 当然,这也不是万能的。 上次我们遇到个针对激光雷达的攻击,有人在路灯杆上贴了个特殊角度的反光片,让雷达把空路识别成一堵墙,摄像头拍出来明明是畅通的,两个传感器的结果冲突,系统也会保守地减速,虽然不会像之前那样急刹,但是也达不到完全流畅的通行效果。对抗样本防御从来没有“一劳永逸”的解决方案,所有的防御本质上都是在提高攻击的成本——你要骗我的系统,得同时搞定摄像头、雷达、高精地图三个层面,花的时间、精力、成本高到不划算,这个防御就算合格了。就像你家门锁,从来不是为了绝对防住所有小偷,只是让小偷撬锁的时间够长,长到邻居能注意到,警察能赶过来,就够了。 现在我每次开车走南京绕城那段,看到路边的路牌,都会下意识瞅一眼有没有奇怪的黑条或者贴纸。 说起来好笑,搞了这么久的对抗样本防御,我最大的感受不是要做多么高深的模型,而是别把AI想得太聪明。它就是个刚学会认东西的小孩,你不盯着点,随便画两笔就能把它唬得一愣一愣的。 哪有什么绝对的安全啊。 对吧?