量子纠错:那些让量子计算机不再“翻车”的硬核技术
上周刷到谷歌量子AI团队发的新论文,直接把我看愣了。
说真的,之前我对量子计算的印象,还停留在“实验室里的昂贵玩具”——毕竟你想啊,动辄要把芯片冷却到比外太空还低的温度,稍微有点扰动就出错,算半天的结果,可能还不如你手里的笔记本电脑算得准。
直到看到他们把量子纠错的实验数据摆出来,我才反应过来,之前大家怕的那个“量子计算永远跑不出实验室”的魔咒,好像真的被撬开了一道缝。
你以为的量子“错”,根本不是传统电脑那种错
很多人对量子比特的错误没概念,觉得不就是跟传统电脑一样,0变成1,1变成0,多存几份备份不就完了?
根本不是。
传统比特的状态是确定的,你存的是0,只要电路没坏,它就安安稳稳是0,错了也无非是跳成1,查一下就能修正。但量子比特不一样啊——它同时处于0和1的叠加态,连它自己都不知道下一秒会塌缩成啥样,更别说你还没法随便复制它的状态(毕竟量子不可克隆定理摆在那)。
更麻烦的是,它的错误根本不是只有“0变1”这一种。
环境里的热振动、宇宙射线撞过来的粒子、实验室空调的气流吹过芯片带来的微小温度波动,甚至外面马路上过辆重卡带来的地面微震动,都能让它的量子相位悄悄偏掉。这种偏斜你根本没法直接测——一测,叠加态就塌了,之前攒的所有量子性全没了。
 超导量子比特退相干干扰源示意图
说个很具象的数字:现在最顶级的超导量子比特,能保持稳定量子态的时间,也就几百微秒。换算一下,大概就是你眨个眼的时间,它的状态已经歪到没边了。
你总不能让它算题的速度,比它歪掉的速度还快吧?那根本不现实。
原来的量子纠错,为什么总给人“赔本赚吆喝”的感觉
最早大家琢磨量子纠错的时候,其实走的是传统纠错的思路——用多个物理比特,拼出来一个“不会随便错”的逻辑比特。
但算完成本大家都傻了。
按照最开始的表面码方案,要纠一个逻辑比特的错,得铺几百个物理比特,其中90%的算力,都用来盯着其他比特有没有出错,真正用来算题的,可能就那么1个。
之前行业里有个很损的吐槽:想造一台能跑有用算法的量子计算机,得先攒个几千个物理比特的芯片,结果一半的芯片都在当“保安”,剩下一半凑起来的算力,还不如个普通的笔记本。
这谁顶得住啊。
所以前几年大家做量子实验,基本都是“能凑多少物理比特就凑多少”,比的是谁的比特数多,根本不敢提“纠错”这茬——因为算下来,纠错的成本比带来的收益还高,完全是赔本买卖。
直到2024年谷歌的Willow芯片把实验数据放出来。
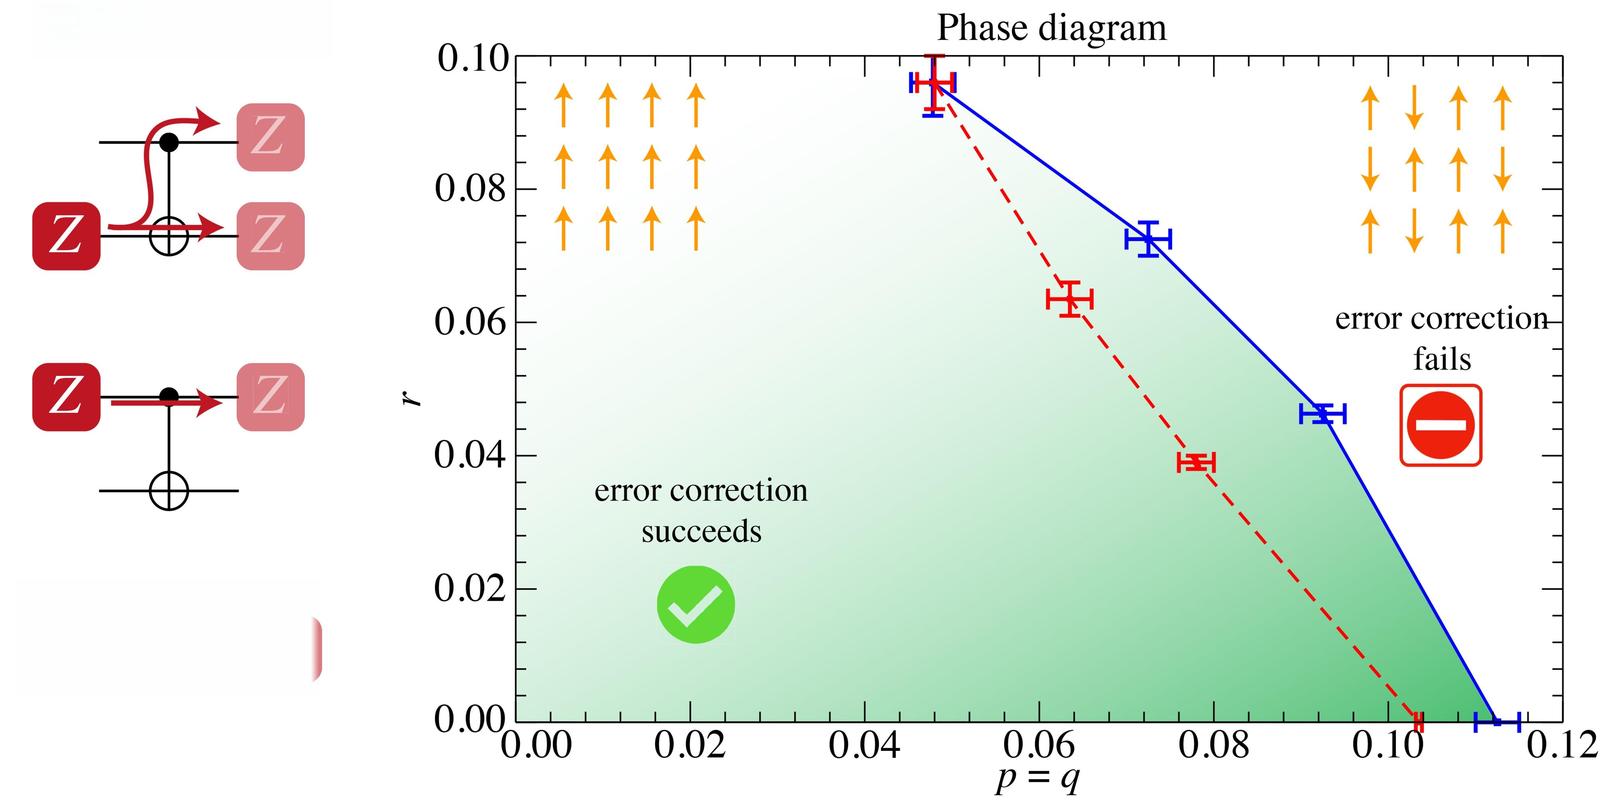 谷歌Willow芯片量子纠错码错误率下降曲线
他们做的事情说穿了很简单:把之前的表面码阵列从距离3(也就是9个物理比特拼一个逻辑比特),扩到距离5(25个物理比特拼一个),再扩到距离7(49个物理比特拼一个)。结果测出来的逻辑比特错误率,是真的在指数下降——每多凑两排物理比特,错误率直接砍了一半。
这是人类第一次在真实的硬件上,证明了量子纠错的收益,是真的能盖过投入的成本。
之前所有的结论都停留在理论推演里,大家都怕实际实验的时候,物理比特之间的串扰、布线的延迟、测量的误差,会把那点纠错的收益全吃掉。结果没有。
我当时盯着那个下降曲线看了快十分钟,真的,鸡皮疙瘩都起来了。
这意味着之前大家觉得“不划算”的量子纠错,现在真的开始划算起来了。
现在的量子纠错,到底离真正能用还有多远
别高兴太早。
就算谷歌把实验做出来了,离大家想象中那种“能模拟新药分子、能跑复杂优化算法”的通用量子计算机,还差得远呢。
首先,现在的进展基本都是在超导路线上跑出来的。离子阱、光量子、中性原子这些其他的量子计算路线,他们的纠错方案能不能达到同样的“收益盖过成本”的效果?谁也说不准。毕竟不同路线的错误类型根本不一样,离子阱的相干时间长,但测量速度慢,光量子的单比特错误率低,但光子丢了根本找不回来,总不能直接把超导的方案硬套过去。
其次,现在的错误率还是太高了。
谷歌这次做到的逻辑比特错误率,大概是每1000个逻辑操作,会出1个错。这个水平,比单物理比特的错误率已经好10倍了,但离真正能跑复杂算法的要求,还差着好几个数量级——比如要模拟一个复杂的蛋白质分子结构,我们需要逻辑比特的错误率降到10^-12量级,也就是每一万亿次操作才错1次。
按照现在每多两排物理比特错误率砍半的速度算,大概还需要把表面码的距离拉到20以上,也就是要用上几万个物理比特,才能摸到那个门槛。
不过话说回来,这两年国内团队的进展,真的快到超出我预期。
之前大家做量子纠错,最头疼的是纠错闭环的反馈延迟——你测出来哪个比特错了,得赶紧给它发个信号修正,要是等你测完算完,比特都已经退相干完了,那纠错全白搭。之前国内的团队,把这个反馈延迟从几百微秒压到了几微秒,跟谷歌的水平已经差不了多少了。
上周跟一个在中科大做量子实验的朋友吃饭,他说现在组里的师弟师妹,已经不像前几年那样,攒几个新的物理比特就抢着发论文了。大家现在都在铆着劲搭大尺寸的比特阵列,测不同码距下的错误率,就想抢在别人前面,把“纠错收益超过成本”这个事,在自己的硬件路线上也跑通。
毕竟谁都明白,没有量子纠错的量子计算机,就是个只能表演“量子随机数”“简单采样”的杂耍玩具,根本成不了能解决实际问题的工具。
哦对,还有个很有意思的细节。
之前很多做传统计算的人,总觉得量子计算是在炒概念,毕竟之前的演示,全是靠堆物理比特数凑出来的花架子,根本没有实用价值。结果这次量子纠错的实验数据出来,几个之前唱衰的传统芯片行业的朋友,私下跟我聊,说现在突然有点慌——原来大家之前不是在玩,是真的在沿着正确的路往前面走。
真的。
技术的拐点从来都不是突然冒出来的。之前大家熬了几十年,就是在等这个“纠错的收益终于能盖过成本”的节点。现在这个节点刚露个边,后面的进展可能比我们所有人想象的都要快。
说不定再过个五六年,我们提到量子计算机的时候,已经不会再问“它到底能不能不犯错”,而是开始讨论“它能帮我们解决什么之前解决不了的问题”了。