工业数字孪生:别把三维漫游当成交付终点
上周去苏州相城的一条新能源电芯产线蹲点,供应商信心满满地演示的全链路数字镜像方案,点开软件转了三圈,连电芯注液工序的压力波动阈值都没标。当场就问了一句:这和花30万做的产线三维漫游动画,差在哪?
对方愣了两秒。
说“我们这个能同步实时数据”。
不是模型够细,才叫孪生
很多人对这套技术的认知偏差,从项目立项的第一天就埋下了——把视觉上的仿真度当成了核心评价标准,觉得模型的边角做的越像真设备,成本就越值。但真正能跑通的映射逻辑,核心从来不是几何精度,是物理量的双向映射:物理产线上的传感器实时采集的振动、温度、压力、介质浓度数据,要同步修正数字端模型的动力学、热力学参数;反过来,数字端通过仿真推演得到的最优参数调整方案,要能反向输出到物理产线的控制系统里,形成闭环。单向的大屏可视化,哪怕做的再逼真,也只是动态的静态演示。
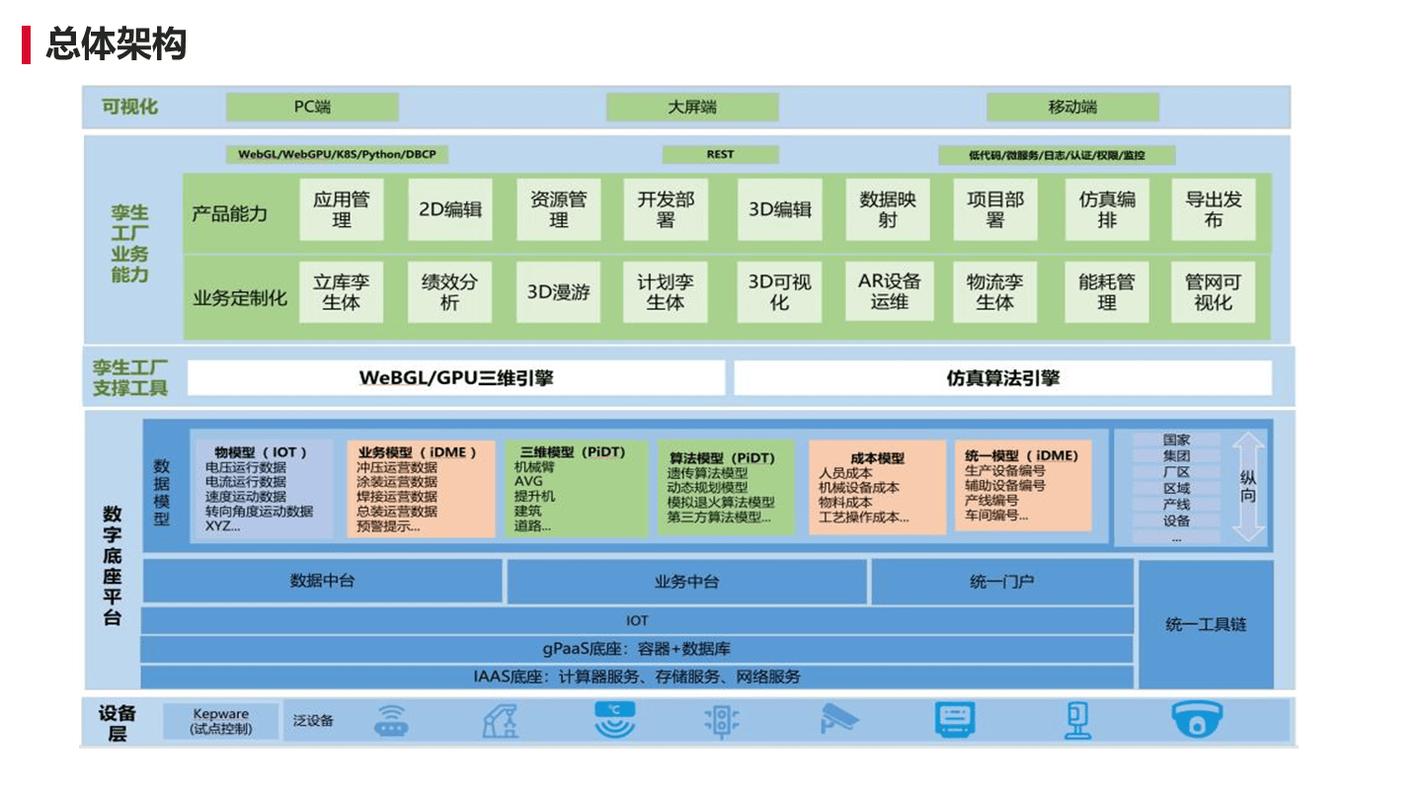 工业产线传感器数据双向映射数字孪生架构图
某汽车零部件厂2022年的项目就是踩了这个坑:花200万找团队做了全产线的高保真三维模型,模型里的冲压机连表面的掉漆痕迹都还原了,最后接的传感器只覆盖了12个表面温度点,连模具的实时磨损量都没采集。数字端算出来的模具剩余寿命,和实际拆下来的实测磨损值差了40%,最后这套系统只在领导来参观的时候打开,日常生产根本没人用。其实对生产场景来说,模型和物理设备的几何尺寸差个几毫米,根本不影响决策;但如果模型里的冲压机振动传递系数、管道流体阻力系数、反应釜的热传导率这些参数和实际值对不上,再精细的视觉模型,也推不出靠谱的生产决策。
卡在数据断点上的落地
跑了十几个制造现场之后发现,所有项目的卡点,从来都不是建模技术不够先进,是数据链路根本通不了。离散制造车间的设备来源太杂了:90年代的老车床没有任何对外通信接口,2015年的注塑机用的是厂家私有的加密协议,2023年采购的新机器人是标准OPC UA接口,这三层的设备数据,本来就不在同一个数据体系里。孪生落地的最大成本从来不是建模,是跨设备的数据协议适配。
长三角某汽车焊装车间,为了打通17种不同品牌的焊接机器人、输送线、焊枪控制器的数据,光部署边缘网关、做协议转换、统一数据格式,就花了建模费用的3.2倍。很多项目一开始的预算分配就错了:上来先买最贵的商业三维引擎,找团队花3个月把产线模型建完,回头发现接不上底层设备的数据,最后只能沦为展示工具。
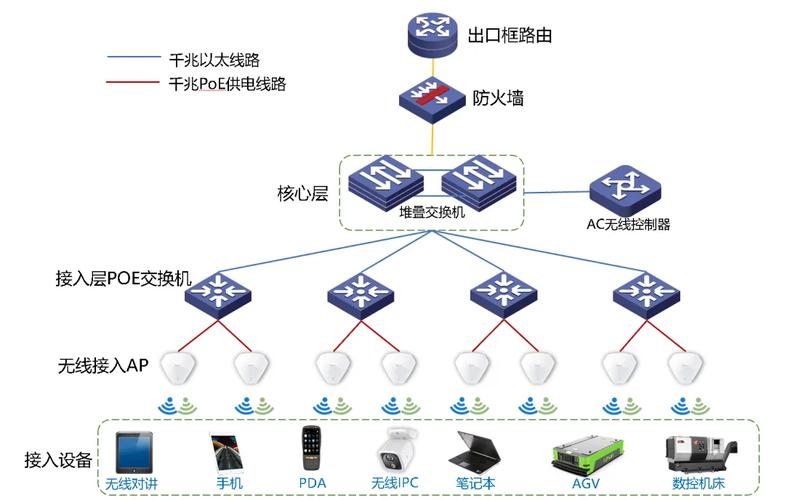 离散制造车间多源设备协议转换边缘网关部署示意图
就算数据协议打通了,还有个容易被忽略的问题:时间同步。不同传感器的采样频率天差地别:压力传感器的采样频率是100ms,振动传感器是10kHz,数字端的仿真步长是1s,三个系统的时钟源不统一,数据时间轴对不齐,映射出来的结果就是错的。比如某半导体封测厂,因为不同子系统的时钟差了8秒,数字端算出来的键合机报警时间,比物理端实际发生的故障时间晚了8秒,最后因为这个延迟,连续3批芯片出现键合强度不足,直接损失近百万。
别往所有场景里硬塞
这两年跟风上项目的工厂不少,最后大多没达到预期,核心问题是没搞清楚这套技术的应用边界。不是所有生产场景都值得投入:高价值、高停机损失的连续生产场景,比如化工反应釜、光伏电池片的扩散工序,停机一次的损失动辄几十万,花成本做全链路的参数映射是划算的;高精度离散加工的核心工序,比如航空发动机叶片的铣削环节,换刀一次的调试成本很高,用孪生模拟不同切削参数下的加工变形,减少试切的时间,投入产出比也够。但如果是简单的瓶装水包装线,本来停机一次的损失才几百块,花几十万上一套系统,算下来要10年才能收回成本,本质是资源错配。
这里要明确,孪生的精度阈值要和场景的决策需求匹配。比如做仓储物流的路径优化,模型只要能算对货架的位置、通道的宽度,能推演AGV的最优路径就行,根本不需要把每个货架的材质、表面粗糙度都建到模型里;但如果是做高压阀门的密封性能测试,那模型的流体动力学参数错一点,测出来的密封寿命就不准,这时候对模型精度的要求就极高。之前碰到过某食品加工厂,跟风把整条包装线的高保真模型建完了,最后发现实际生产里最影响效率的是人工放料的速度——这个变量根本没法用固定参数的模型模拟,最后系统被闲置在服务器集群中,没有实际生产价值。
现在很多厂商宣传的“自演化孪生”,其实还在非常早期的阶段。目前能实现的模型自校准,最多就是根据实时采集的数据,调整几个固定的预设参数,根本做不到完全自主的模型重构。还有个容易被忽略的风险:因为这套系统要采集全链路的生产数据,很多核心的工艺参数、设备参数都存在系统里,如果权限管控不到位,数据泄露的损失是不可逆的。之前某新能源电池厂的极片涂布工艺参数,因为存在孪生系统的云服务器上,权限设置成了公开可读,被竞争对手爬走了核心参数,最后打了两年的知识产权官司。
上个月和苏州那家电芯厂的设备主任聊天,他们把之前那套花180万做的展示型系统砍了,拿一半的预算,只在注液工序做了局部的参数映射,接了27个压力、浓度、温度的传感器,模型只跑注液环节的流体动力学推演,现在算出来的注液量偏差能控制在0.3%以内,比之前人工调参的效率提了30%。你看,根本不需要什么覆盖全产线的宏大叙事,把一个工序的物理映射做准了,比满屏转的华丽三维模型有用多了。