量子纠错:通用量子计算机绕不开的核心关卡
你刷到过很多量子计算的新闻吧?今天突破几百上千比特,明天实现全新量子优越性,听起来好像再过两三年,量子计算机就能取代经典电脑解决大问题了。
醒醒。
所有不带量子纠错的量子计算,都是空中楼阁。
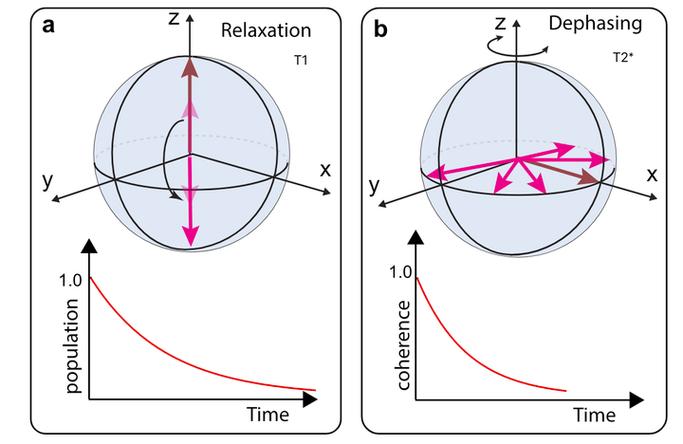 超导量子比特芯片退相干噪声示意图
现在市面上喊出来的几千个量子比特,全都是物理量子比特。什么意思?就是单个的、容易出错的基础单元。要得到一个真正能稳定计算、不出错的逻辑量子比特,你得用一大堆物理量子比特来做纠错,把错误给稀释掉。
之前很多厂商发论文开发布会,晒比特数量晒得欢,其实懂行的人都笑——没有好的纠错,一万个物理比特也顶不上一个能用的逻辑比特,根本做不了有用的计算。
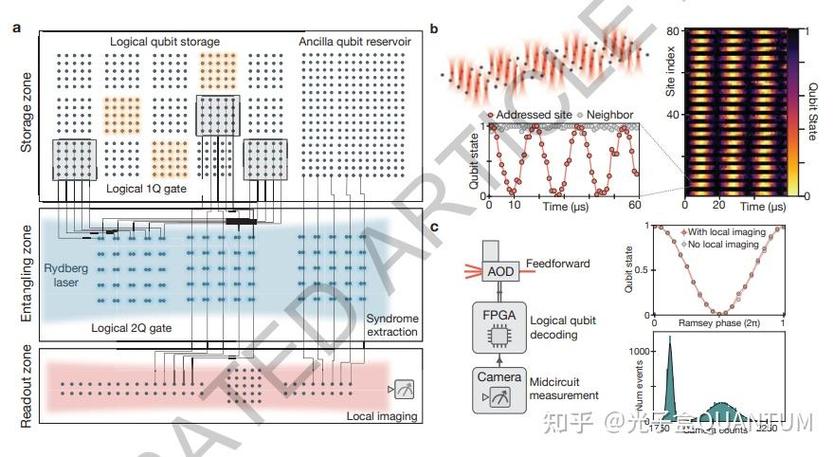 量子计算表面码纠错逻辑比特布局图
现在业界公认,表面码是最接近实用化的量子纠错方案。它对硬件噪声的容忍度比别的方案高,工艺上也更容易匹配现在已经成熟的超导量子比特工艺。这次谷歌用的就是表面码,把逻辑比特的错误率随着码距增加成功降了下来,相当于给整个行业吃了一颗定心丸。
国内其实跟进得也很快,中科大潘建伟团队去年也在光量子平台上做了类似的实验,得到了同样的结论,进度一点不慢。
说实话,这个突破出来之后,量子圈的资本热度一下子又上来了。之前几年量子计算遇冷,好多人都喊这是骗投资的画饼,现在一看,最核心的坎儿第一步已经跨过去了,当然不一样了。
不过话说回来,也别吹得太离谱。现在谷歌做出来的,也就只是证明了原理可行,那个逻辑比特的错误率,还是高到根本没法用来计算。要得到一个完全能用的低错误率逻辑比特,还需要几千个高质量的物理量子比特,要做能解决实际问题的量子计算,得要几十个上百个这样的逻辑比特,算下来就是好几万个物理比特,现在最好的芯片也就几千个,还差得远呢。
 接下来量子纠错要啃哪几块硬骨头?
现在量子纠错最大的瓶颈,说来说去还是两个:硬件规模,硬件质量。
刚才说了,一个能用的逻辑比特就要上千个物理比特,你得把这么多高质量的物理比特做在同一块芯片上,还要能独立控制每个比特的误差,误差还得降到阈值以下——表面码要求物理比特的门错误率低于1%左右,现在很多芯片能做到平均千分之几,但是总有几个残次的,一两个错的就会把整个纠错体系搞崩。
其次是控制的复杂度。你要同时控制几万个物理比特,还要实时做纠错的运算,这个控制电路本身就会带来额外的噪声和热量,你这边刚把错误纠完,那边控制电路带来的新错误又加上了,等于擦桌子越擦越脏,这个平衡很难找。
当然也有别的路线,比如微软押注的拓扑量子比特,本身就自带容错属性,一个拓扑量子比特本身就是逻辑比特,不用堆那么多物理比特,听起来是不是很美?可惜的是,到现在为止,科学界都还没真正稳定制备出一个拓扑量子比特,微软搞了快二十年了,还是在实验阶段,能不能成还不好说。
我之前见过一个做量子硬件的大佬,他说量子纠错就是堆,堆材料,堆工艺,堆实验,一点点把错误率往下降,没有什么惊天动地的捷径可走。
我觉得说得对。现在很多人对技术的态度特别极端,要么就是吹得能上天,要么就是踩得一文不值,其实量子纠错就是这样,一群人在极低温的实验室里,一点点啃硬骨头,今天把错误率降千分之一,明天把比特数多做一百个,一步步往前走。
说不定再过十年,我们就能真的用上能解决实际问题的容错量子计算机,算清楚蛋白的折叠结构,开发出新的靶向药,或者破解掉经典计算机算不出来的复杂问题。
谁知道呢?走着瞧吧。
为什么量子比特天生就这么容易“犯错”?
讲纠错之前,得先搞明白,量子计算为什么需要纠错? 经典计算机你肯定知道,0就是0,1就是1,哪怕有一点噪声干扰,只要不超过阈值,都会被矫正回正确的电平。经典纠错更简单,把信息复制个三五份,少数服从多数就完了。 换到量子世界,规则全变了。 首先有量子不可克隆定理——你没法完美复制一个未知的量子态,直接抄经典的办法根本行不通。其次,量子比特的信息承载在量子态的相位上,外界哪怕一点点干扰,一个光子碰一下,一点温度波动,都会让量子态失去相干性,也就是我们说的退相干,信息直接就乱了,错得没边。超导量子比特芯片退相干噪声示意图
现在市面上喊出来的几千个量子比特,全都是物理量子比特。什么意思?就是单个的、容易出错的基础单元。要得到一个真正能稳定计算、不出错的逻辑量子比特,你得用一大堆物理量子比特来做纠错,把错误给稀释掉。
之前很多厂商发论文开发布会,晒比特数量晒得欢,其实懂行的人都笑——没有好的纠错,一万个物理比特也顶不上一个能用的逻辑比特,根本做不了有用的计算。
近年量子圈顶流突破,到底改变了什么?
2023年下半年,谷歌人工智能量子团队发了一篇Nature,直接炸了整个量子圈。他们做了什么?第一次在实验上证明,增加纠错用的物理量子比特数量,逻辑量子比特的错误率真的会往下降。 别小看这个结论。 之前几十年,量子纠错都停留在理论上,最多做个小演示,你物理比特加得越多,引入的错误也越多,最后逻辑比特错得比单个物理比特还厉害。等于说大家都知道这条路方向对,但是一直没走通,甚至有人怀疑是不是这条路根本走不通。 这次谷歌直接把实锤砸出来了:方向没错,走得通。量子计算表面码纠错逻辑比特布局图
现在业界公认,表面码是最接近实用化的量子纠错方案。它对硬件噪声的容忍度比别的方案高,工艺上也更容易匹配现在已经成熟的超导量子比特工艺。这次谷歌用的就是表面码,把逻辑比特的错误率随着码距增加成功降了下来,相当于给整个行业吃了一颗定心丸。
国内其实跟进得也很快,中科大潘建伟团队去年也在光量子平台上做了类似的实验,得到了同样的结论,进度一点不慢。
说实话,这个突破出来之后,量子圈的资本热度一下子又上来了。之前几年量子计算遇冷,好多人都喊这是骗投资的画饼,现在一看,最核心的坎儿第一步已经跨过去了,当然不一样了。
不过话说回来,也别吹得太离谱。现在谷歌做出来的,也就只是证明了原理可行,那个逻辑比特的错误率,还是高到根本没法用来计算。要得到一个完全能用的低错误率逻辑比特,还需要几千个高质量的物理量子比特,要做能解决实际问题的量子计算,得要几十个上百个这样的逻辑比特,算下来就是好几万个物理比特,现在最好的芯片也就几千个,还差得远呢。
接下来量子纠错要啃哪几块硬骨头?
接下来量子纠错要啃哪几块硬骨头?
现在量子纠错最大的瓶颈,说来说去还是两个:硬件规模,硬件质量。
刚才说了,一个能用的逻辑比特就要上千个物理比特,你得把这么多高质量的物理比特做在同一块芯片上,还要能独立控制每个比特的误差,误差还得降到阈值以下——表面码要求物理比特的门错误率低于1%左右,现在很多芯片能做到平均千分之几,但是总有几个残次的,一两个错的就会把整个纠错体系搞崩。
其次是控制的复杂度。你要同时控制几万个物理比特,还要实时做纠错的运算,这个控制电路本身就会带来额外的噪声和热量,你这边刚把错误纠完,那边控制电路带来的新错误又加上了,等于擦桌子越擦越脏,这个平衡很难找。
当然也有别的路线,比如微软押注的拓扑量子比特,本身就自带容错属性,一个拓扑量子比特本身就是逻辑比特,不用堆那么多物理比特,听起来是不是很美?可惜的是,到现在为止,科学界都还没真正稳定制备出一个拓扑量子比特,微软搞了快二十年了,还是在实验阶段,能不能成还不好说。
我之前见过一个做量子硬件的大佬,他说量子纠错就是堆,堆材料,堆工艺,堆实验,一点点把错误率往下降,没有什么惊天动地的捷径可走。
我觉得说得对。现在很多人对技术的态度特别极端,要么就是吹得能上天,要么就是踩得一文不值,其实量子纠错就是这样,一群人在极低温的实验室里,一点点啃硬骨头,今天把错误率降千分之一,明天把比特数多做一百个,一步步往前走。
说不定再过十年,我们就能真的用上能解决实际问题的容错量子计算机,算清楚蛋白的折叠结构,开发出新的靶向药,或者破解掉经典计算机算不出来的复杂问题。
谁知道呢?走着瞧吧。