当系统崩在大促场:混沌工程教给我们的反脆弱生存法
从救火式运维到主动埋雷
2023年某头部电商大促开场十分钟,支付集群某台服务器硬盘故障,本来只是单点问题,结果触发了限流规则连锁反应,近半小时核心交易不可用,损失保守算有七位数。没人想到,这种百年一遇的故障组合,其实早就能被找出来。
很长时间里,运维的逻辑都是:没出问题就是没问题。做容灾演练全是走纸面流程,拉一群人开个会演一遍,真到出事,该找不到的切换脚本还是找不到,该切不通的流量还是切不通。出了故障全团队熬夜抢修,改完BUG喝杯粥回去睡觉,下次接着再来。
说实话,这种循环放在十年前单体应用时代没问题,整个系统就跑在几台机器上,出问题都是明面上的,改了就好。现在呢?动辄上百个微服务,跨好几个可用区,调用链路绕来绕去,一个不起眼的小配置错误,能沿着链路滚成雪崩。
你做了三地五中心,觉得万无一失。其实切换脚本半年没跑过,已经连不上新扩容的数据库地址了。你加了限流熔断,觉得高枕无忧。真到流量涨上来,限流规则的阈值配错了,直接把正常流量也拦在了外面。这些问题藏在阴影里,平时根本碰不到,真出事就是灭顶之灾。
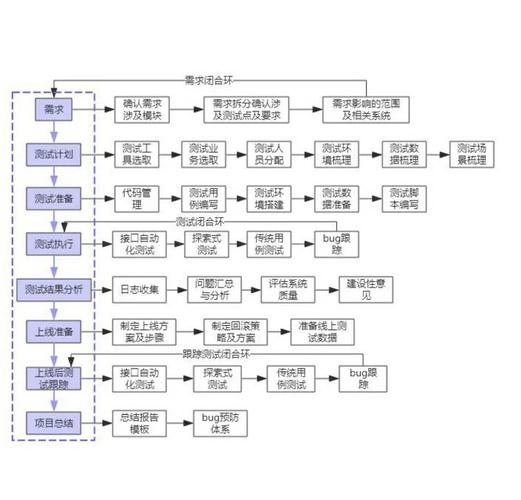 传统被动运维vs主动混沌测试流程对比图
核心逻辑其实很简单:用可控的小规模破坏,暴露不可控的系统性风险。它不是故意搞事,是把未来可能发生的故障,提前在你能控制的场景里放出来,改完了,真出事就不怕了。那些每年大促前偷偷给核心节点拔网线、关服务器的团队,才是真正能扛住流量洪峰,在别人出问题的时候稳稳接住溢出流量的那一个。
别瞎炸:它的适用边界在哪
不过话说回来,我见过太多把经念歪的案例。不少团队看大厂都在玩,不管不顾上来就搞,结果把生产环境搞崩,得不偿失。
之前接触过一个做本地生活服务的创业公司,总共十个人的技术团队,线上活跃用户才几万,CTO看了两场技术峰会,回来就要推全流程测试。第一天搞演练,误操作把核心数据库的流量切去了测试环境,直接停服四个小时,好多商家的订单全丢了,差点把刚拿到的天使轮造没。
它从来不是什么银弹,更不是所有团队都必须上的工具。它存在的前提是:你的系统已经复杂到单点故障会引发不可预测的连锁反应,你的业务也损失得起小范围测试的试错成本。
如果你的业务就是一个小博客,整个系统跑在一台云服务器上,你去拔网线测故障,纯属吃饱了撑的。如果你是做支付、做电商、做公有云,核心系统每秒几十万请求,一个小时停服损失几百万,那你不去做主动测试,才是真的拿业务开玩笑。
最核心的执行原则,就是控制爆炸半径。每次测试只能影响极小范围的非核心用户,或者只跑在预发布环境的小流量上,必须有一键终止的熔断机制,出问题十秒内能回滚到正常状态。不少新手上来就炸核心集群,那不是测试,那是给自己裁员找理由。
 混沌工程爆炸半径分级控制示意图
很多人还有个误区:觉得测就要把所有能想到的故障都测一遍。其实不是。它的目标从来不是覆盖所有故障,是验证你设计的容错机制真的能用。你说你做了限流,那就测一把,看看超过阈值之后是不是真的只切流不宕机,不是把整个集群拖死。你说你做了异地多活,那就切一次主流量试试,看看是不是真的能在几分钟内切过去,用户无感知。这些写在架构文档里不算数,测过了才算数。
从可用性到业务韧性:下一个方向在哪
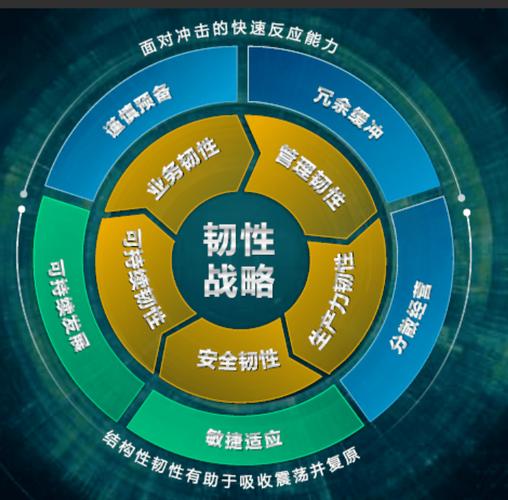 从可用性到业务韧性:下一个方向在哪
最早它只是用来测基础设施层面的故障:服务器宕机、网络延迟、硬盘损坏、数据库连接超时。现在已经慢慢延伸到业务层面了。
举个例子,大促的时候商品详情页会调用第三方广告接口拉取推广信息,很多架构设计里,详情页会等广告接口返回之后再整体渲染。如果广告接口突然挂了,超时五分钟,那整个详情页都打不开,所有流量都卡住,这就是典型的业务层面脆弱点。这种问题,你靠基础设施测试根本测不出来,只有主动模拟第三方接口故障,才能发现。
现在越来越多的团队开始做业务层面的故障测试,验证核心链路在上下游出问题的时候,能不能正常运转。哪怕少了一个非核心模块,核心交易能不能正常走,用户能不能正常下单付款,这个才是真正的业务韧性。
但也要看到新的风险。现在很多公司把测试做成了KPI,要求每个月必须炸多少次节点,出多少份测试报告,结果为了完成指标,全测的都是无关痛痒的边缘节点,核心路径从来不敢碰,怕出事担责任。说白了就是走形式,钱花了,人招了,什么问题都没发现,纯纯的面子工程。
还有数据安全的风险。测试过程中模拟故障,很容易出现数据错乱,甚至把测试数据混入生产环境,或者带出用户的敏感信息,这些都是要提前做隔离,做权限控制的,不少团队没注意这点,测完故障,又出来数据安全问题,捡了芝麻丢了西瓜。
说到底,它本质是一种思维方式:永远不要相信你的系统永远不会坏,永远不要抱着侥幸心理等故障找上门。主动在安全范围内引爆小问题,才能避免不可挽回的大崩溃。这件事,从来都不是大厂的专属玩具,只要你的系统开始变得复杂,这种反脆弱的思路,就比堆十台机器还管用。