云原生可观测性:别拿概念当落地的遮羞布
前阵子跟做运维的老陈吃烧烤,酒过三巡他拍着桌子吐槽,老板听了厂商销售画饼,花了八十万上全套云原生可观测性,结果上个月核心支付出问题,一帮人对着一堆花花绿绿的图表盯了一个半小时,还是靠老陈翻了十年前搜日志的本事才找到问题。
钱花了,活干了,概念凑齐了,就是不好用。这不是当下绝大多数团队做云原生可观测性的现状吗?
凑齐三大支柱,不代表你做对了云原生可观测性
现在随便搜一篇相关的文章,开口就是云原生可观测性三大支柱:指标、日志、链路追踪。好像你把Prometheus、Grafana、OpenTelemetry、ELK这套栈搭起来,你就功德圆满了。
说实话,真不是这么回事。
我见过一个二十多人的创业团队,为了凑齐三大支柱,开发停了半个月的新需求给所有老业务加埋点,好不容易把链路都打通了,结果发现只要流量一上来,观测采样数据就能吃掉业务集群15%的CPU,吓得他们赶紧把采样率降到1%,降完之后发现一半的链路都断了,出问题还是找不到。
还有更离谱的,老板要求必须做统一观测,团队硬着头皮把三个集群的数据都汇到一起,结果存储成本三个月翻了六倍,删历史日志都不敢删,怕合规出问题,就这样白白砸钱进去。
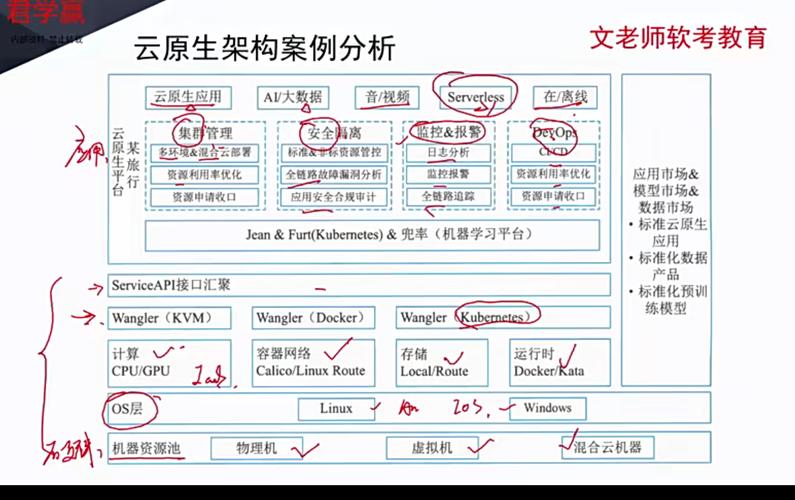 云原生可观测性三大支柱落地错误架构图
很多人从一开始就搞错了方向。云原生可观测性的本质,不是让你把三大支柱凑齐给老板看PPT,是让你在系统出问题的时候,能快速定位根因,减少宕机时间,少加班少背锅。
你花了大几十万,最后还是靠人肉搜日志排障,那这套东西就是一堆没用的垃圾,说破天也没用。
当下云原生可观测性的新玩法,真的解决了老痛点
去年参加CNCF的线下沙龙,听了大厂朋友的分享,才发现现在行业玩法早就变了。之前最痛的痛点是什么?存量服务改代码埋点难啊!一堆老业务,开发团队都换了三波了,谁也不敢随便改代码加埋点,对吧?
现在基于eBPF的零侵入云原生可观测性,直接解决了这个问题。不用改一行业务代码,不用碰应用层,直接从内核层面拿到所有的调用信息、网络数据,部署上去就能用。
我听完当时就觉得,这才是真的解决实际问题的方向啊!之前那些要求你全量改代码埋点的方案,本质就是把成本转嫁给用户,自己赚轻松钱。
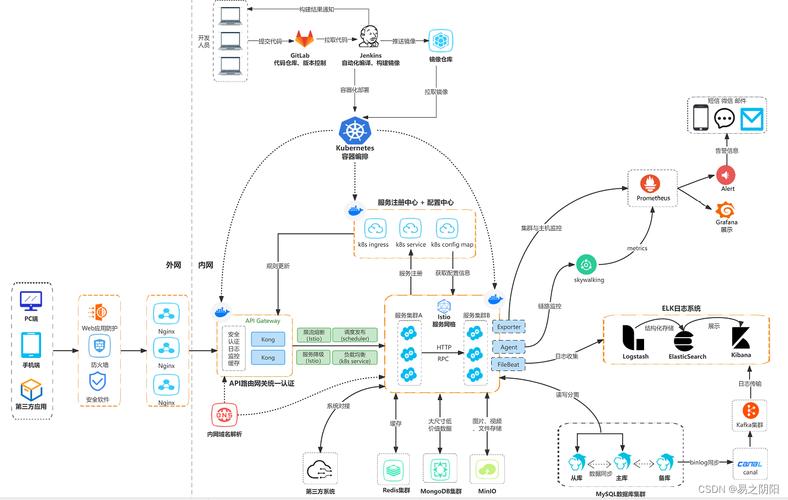 eBPF零侵入云原生可观测性数据流图
不过话说回来,eBPF也不是银弹。它对内核版本要求不低,很多企业还有一堆跑了四五年的老服务器,内核还是3.x的,你敢随便升内核吗?线上业务跑的好好的,升内核出问题谁背锅?所以现在还是新集群用的多,存量老集群还是得慢慢过渡。
还有一个方向我挺意外的,就是AI辅助根因定位。之前我以为就是厂商吹的概念,上个月看腾讯的朋友演示,他们全链路压测出异常,AI十几秒就把关联的异常指标、日志串起来,直接定位到某个第三方服务的超时调用,换人工至少得半个多小时。
CNCF 2024年的最新调研里,已经有超过58%的生产环境在测试AI根因定位了,这个速度真的超出我预期。以后运维排障,真的不用盯着屏幕熬大夜了?想想都爽。
中小团队落地云原生可观测性,别上来就砸钱
 中小团队落地云原生可观测性,别上来就砸钱
我见过太多中小团队,被厂商销售一忽悠,脑子一热就掏几十万上商业版,最后90%的功能都用不上,纯纯浪费钱。
说实话,你一个十几个人的团队,微服务也就二三十个,犯不着追最前沿的概念。先想清楚你最痛的点是什么:你是不是出了问题不知道哪个服务挂了?那先给核心服务加几个关键指标,把核心链路打通,先解决「能找到问题」这个最基础的需求,剩下的慢慢迭代。
现在OpenTelemetry的开源生态已经非常成熟了,绝大多数中小团队的需求,用开源组件搭一套完全够用,成本也就一两台服务器的钱,犯不着给厂商交智商税。
我必须提一句,很多团队踩的最大的坑,就是把可观测性本身做成了复杂度。为了做云原生可观测性,招了三个人专门维护这套系统,每年成本大几十万,最后节省的排障时间都抵不上维护成本,这不是本末倒置吗?
可观测性永远是服务于业务的,不是服务于架构师的KPI,也不是用来凑云原生转型的概念的。你能十分钟定位问题,哪怕你只用了Grafana加ELK,那你就是合格的。你搞了一堆花里胡哨的概念,出问题找两个小时,那就是不及格。
之前还有朋友跟我吹,说我们现在可观测性能看到每一个请求的每一步,全量存储,厉害吧?我就问他,你出问题能比之前快多少?他想了半天说,好像也没快多少,就是看起来好看。哦,那就是老板愿意掏钱做门面,当我没说。
说白了,云原生可观测性不玄乎,就是帮你少背锅少加班的工具。别把它搞成玄学,也别拿概念当遮羞布,能解决问题的,才是好的。