打破墙:近存计算如何重构算力底层逻辑
算力的增速,永远追不上数据的涨势。
这不是最近才有的问题。从芯片诞生第一天起,计算和存储就像两个住在马路两头的工人,要干活就得不停来回跑,路越远,跑的时间越多,干活的时间越少。
被堵死的冯诺依曼瓶颈
当大模型的参数规模从十亿级膨胀到万亿级,这个已经存在半个世纪的问题直接摆到了台面上。原来的架构里,计算单元性能跟着摩尔定律走,每两年翻一番,存储带宽每年才涨不到百分之十,两者的差距越拉越大。
冯诺依曼瓶颈也就是行业常说的存储墙,早不是实验室里的抽象概念,是现在每一块AI加速卡都要直面的死结。有公开测试数据显示,大模型推理过程中,超过80%的功耗消耗在数据搬移上,计算本身消耗的功耗不到两成。
太浪费了。
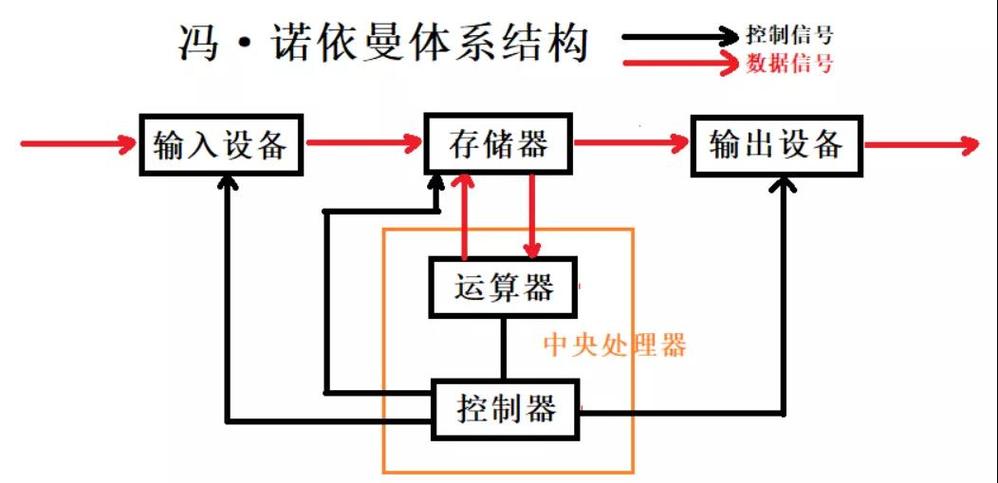 传统冯诺依曼架构存储墙示意图
过去几十年业内也想了很多办法补漏。给计算单元堆更大的缓存,把常用数据放计算旁边,但是缓存成本太高,容量做不大,放得下小参数放不了大模型。换高带宽内存,HBM的带宽比传统GDDR高好几倍,但是哪怕是HBM3,数据还是要穿过多层互联才能到计算单元,延迟和功耗损耗依然降不下来。
既然挪数据太贵,那干脆挪计算。
把计算挪到存储跟前
很多人会把这个方向和存内计算混为一谈,其实两者是完全不同的技术路线。存内计算是直接改存储单元的基本结构,让存储本身承担计算功能,更适合模拟计算等特定场景,通用性和良率一直难解决。
它的核心思路要务实得多:不改变现有成熟存储颗粒的设计,只是把计算单元尽可能靠近存储摆放,通过3D堆叠封装共享同一块高带宽内部通路,省去数据跨芯片远距离搬运的过程。说白了就是转了个弯:原来让数据来找计算,现在让计算凑上去找数据。
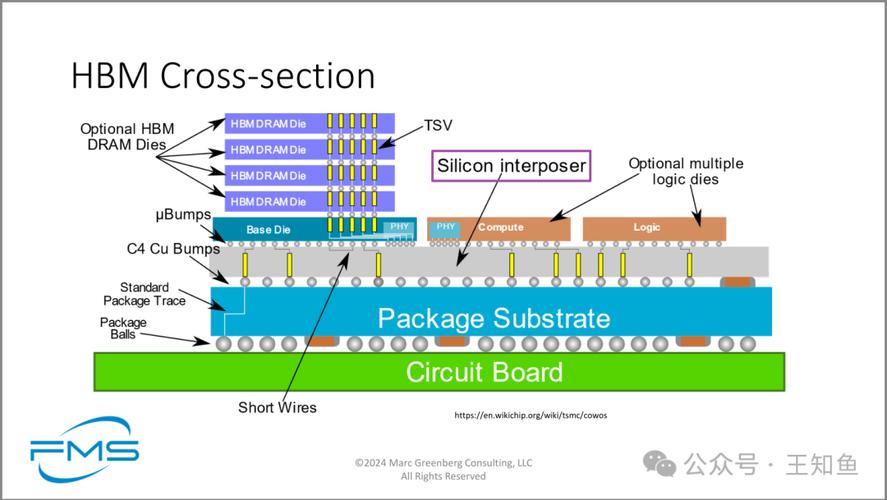 近存计算3D堆叠架构剖面图
现在主流的实现路径分两种。一种是把专用计算单元,比如向量计算、矩阵乘法单元,集成到内存控制器里,数据不用搬出内存颗粒,就在存控完成计算直接输出结果,对原有架构改动小,成本增量低,现在不少边缘AI芯片已经在用这个思路落地。另一种更激进,用3D堆叠把存储层和计算层做在一起,中间用硅通孔互联打通,带宽比传统片外存储高两个数量级,延迟降到原来的十分之一,适合数据中心大模型这类高负载场景。
从已经公开的测试结果看,在向量检索、大模型推理这类高数据密度的场景下,性能能提升3-5倍,功耗直接降一半以上。但必须说清楚,它不是万能的。那种计算密度低、数据碎片化、任务切换频繁的通用场景,它的优势完全发挥不出来,反而会因为额外的计算单元推高成本,得不偿失。
落地还要过几道坎
 落地还要过几道坎
第一道坎是软件适配。现在从操作系统到上层应用,整个软件栈都是给传统分离架构写的,数据分配、调度、缓存一致性的逻辑全是基于冯诺依曼架构设计的。换架构就要重构整个软件栈,这个工程量不是一两家厂商能扛下来的。现在能落地的方案,都是针对特定场景做定制化改造,比如只把向量计算这块迁移过来,其他部分还是沿用原来的逻辑,本质上是一种妥协的过渡方案。
第二道坎是良率和成本。3D堆叠本身的良率就比传统2D芯片低,一层出问题,整个堆叠芯片都报废,多加一层计算单元,良率至少掉十个百分点,成本直接往上跳。现在一颗HBM3存储颗粒的成本已经上百美元,加一层计算单元,成本翻一番都打不住,目前只有数据中心能扛住这个成本,消费级、车载芯片根本用不起。
第三道坎是多核心一致性。多个计算单元同时访问同一块近存的时候,数据一致性怎么保证?传统的缓存一致性协议跑在高带宽近存上,一致性协议本身的开销会比原来大很多,搞不好性能提升全被协议开销吃掉,白忙活一场。
说实话,现在行业里吹得太凶,很多人把它当成拯救算力危机的万能解药,其实远不是这么回事。它就是针对存储墙问题的一个针对性解法,只适配特定场景,至少未来十年内,都不可能完全取代传统冯诺依曼架构。
不过话说回来,摩尔定律已经摸到物理瓶颈,算力需求还在每年翻几倍往上涨,原来的路越走越窄,总得有人往新方向蹚一蹚。现在已经有不少头部芯片厂商在做量产级试点,最先落地的肯定是向量数据库、大模型推理这类对带宽延迟极度敏感的场景,接下来可能会延伸到自动驾驶实时计算这些领域。
至于能不能走到通用计算那一步,现在谁也说不准。芯片架构的迭代,从来都是一步步磨出来的,从灵光一现的想法到大规模量产,少说得十年八年。至少现在,那堵堵了我们几十年的墙,终于被撬开了一道新口子。