打破冯诺依曼墙:存算一体架构为什么是下一代算力破局点
去年帮朋友调一个端侧大模型,功耗卡死活降不下来,风扇转得像起飞,手摸芯片能烫得缩回去。那时候第一次真切感觉到,我们用了七十多年的老架构,真的撞到墙了。
冯诺依曼瓶颈的本质:数据搬运的功耗死结
现在所有人都在说AI算力不够,大部分人把希望堆在摩尔定律续命,堆在更先进的工艺上。很少有人想过,现有架构的天生缺陷,才是卡住功耗和速度的核心。
传统冯诺依曼体系里,计算和存储是完全分开的两个模块。计算单元要拿数据,必须通过总线从存储单元调过来,算完再送回去。这个过程里,绝大部分功耗都花在了数据搬运上,和计算本身没关系。
小参数时代没问题,参数总共才几兆,来回搬也费不了多少电。现在呢?端侧AI模型动不动就是几个G,云端更是千亿参数起步。每一次运算都要搬几千次数据,功耗堆到离谱,速度还上不去。
这是死结。靠堆工艺缩小晶体管,解决不了架构本身的问题。
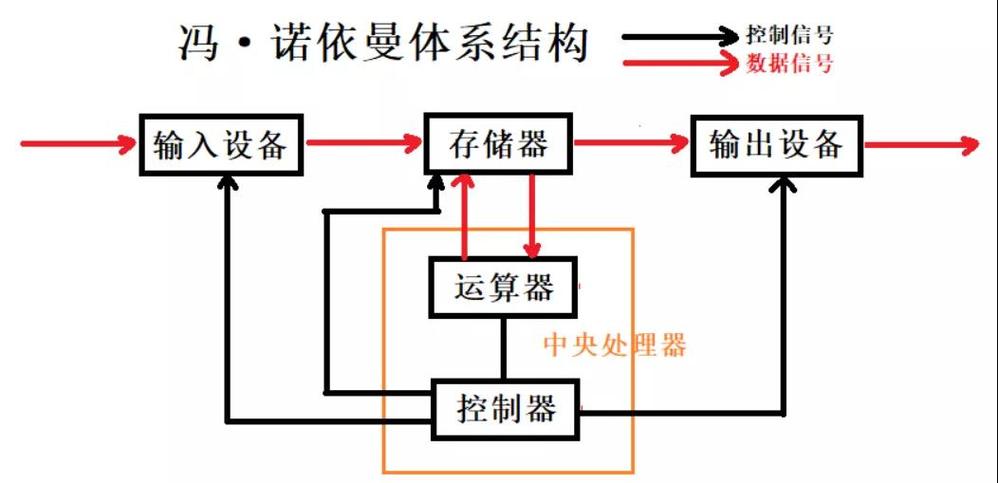 冯诺依曼架构数据搬运路径示意图
新架构的思路说穿了也简单:让存储本身具备计算能力。不用搬数据了,直接在存储里面把算做完,自然就省了绝大部分功耗,速度也能提上去。这就是我们说的核心方向。
不同技术路线的账,得掰碎了算
现在路线撕得厉害,没人敢说哪条一定能成。每个路线都有自己的适用场景,也绕不开的天生缺陷。
按实现方式分,有模拟存算和数字存算两条大方向。模拟存算利用欧姆定律、基尔霍夫定律直接做乘加运算,刚好AI推理百分之九十以上都是乘加,一步出结果,效率拉满,功耗能降到传统架构的十分之一以下。但问题也很明显,模拟器件的干扰大,精度低,大部分只能做到4-8比特,做不了高精度计算,更扛不住训练要求。
数字存算刚好反过来,精度和传统CMOS兼容,稳定性好,但是面积大,计算效率远不如模拟,很多时候省下来的功耗还不够补面积增加的消耗。之前见过某团队做的全数字存算芯片,功耗比同性能模拟方案高了五倍,完全丢掉了核心优势。
按存储介质分,现在主流的有SRAM、RRAM、DRAM三条路。SRAM和现有工艺兼容性最好,速度快,但是密度低,做不了大存储,只能端侧放小模型。RRAM密度高,能做超大容量存算,适合放更大的模型参数,但是良率一直上不去,器件一致性差,坏块问题到现在都没完全解决,很多实验室样品看着漂亮,一量产就拉胯。DRAM存算近几年才起来,利用DRAM本身的特性做计算,密度比SRAM高,比RRAM成熟,但是读写干扰问题还在优化。
说实话,我见过太多创业公司拿PPT吹路线,一说量产良率就开始打哈哈,绕来绕去不说具体数字。这个领域现在还没到哪条路线通吃的地步。
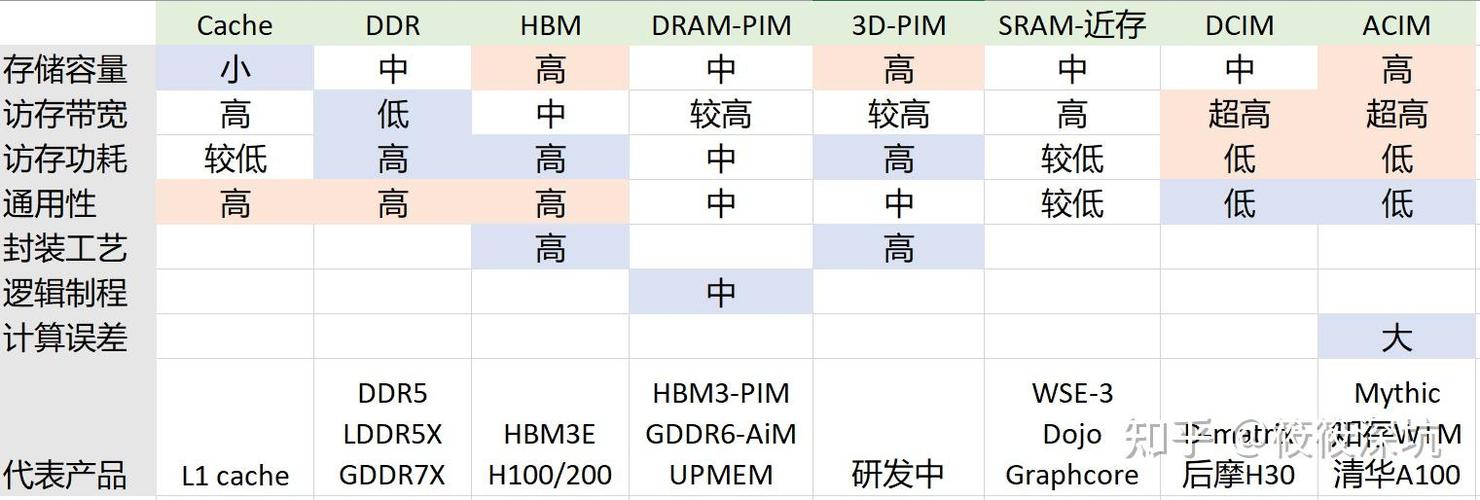 不同介质存算单元性能参数对比图
应用边界在哪?别什么锅都往里面装
 应用边界在哪?别什么锅都往里面装
现在资本吹得太狠,仿佛这个新架构能解决所有算力问题,马上就要取代CPU GPU了。哪有这么神。
它有自己明确的适用边界,越界了根本玩不转。比如现在的云端大模型训练,就完全扛不住。训练需要高精度浮点运算,需要反复迭代修改参数,现有存算方案的精度根本达不到,也支持不了这么灵活的运算逻辑。现在能落地的,都是低功耗端侧AI推理场景:智能手表的AI降噪,家用监控的人形检测,TWS耳机的语音唤醒,汽车的辅助驾驶感知,这些场景对精度要求不高,对功耗和体积卡得严,刚好对上优势。
就算在适合的场景里,也有绕不开的风险。现在很多所谓的新项目,就是把原来的内存改个设计,换个名字就出来圈钱,核心的计算效率提升根本达不到宣传的数字。还有工具链的问题,现在所有的AI模型都是基于传统架构训练优化的,要迁移到新架构上,需要重新适配量化,很多模型迁移之后精度掉得离谱,这个适配成本到现在都没人能算清楚。
不过话说回来,它确实给算力卡脖子的当下开了新口子。未来十年里,它不会取代现有的冯诺依曼架构,会变成异构计算里的一块拼图:需要低功耗推理的时候用它做加速,需要通用计算、高精度训练的时候还是用传统CPU GPU。
我们找了几十年的冯诺依曼瓶颈破局方案,这一次,终于摸到了可以落地的方向。剩下的,就是给产业一点时间,慢慢磨工艺,磨良率,磨工具链。急不来。