黑盒拆开给你看:模型可解释性的迷思与破局
打开任何一个机器学习会议的征文列表,一半以上的方向都能沾点黑盒解释的边。各路方案满天飞,拍胸脯打包票的人很多,真能落地解决实际问题的很少。
为什么没人敢拍胸脯说自己搞定了
我们常说模型是黑盒,到底黑在哪。参数少的线性模型,逻辑回归,系数摆出来,每个特征的权重清清楚楚,看起来透明。可你要是抓单个样本问,这个样本的预测结果,到底是哪几个特征最终拍板的,依然说不清楚。特征之间的交互效应,非线性的关联,早就把权重稀释得不成样子。
更别说现在百亿千亿参数的大模型,神经元之间的连接万亿级,谁能把每一次预测的激活路径理清楚?说实话,连模型训练的时候,参数更新都有大量随机扰动,最终学到的规律很多都是隐式的,连训练它的工程师都不知道它到底记住了什么。
 大模型黑盒决策路径示意图
很多人说,我们可以做模型蒸馏,把大模型的知识蒸馏到小模型里,小模型可解释不就行了?这个思路听起来顺畅,实际呢,蒸馏出来的小模型只是拟合了大模型的输出,不是还原了大模型的逻辑,差之毫厘谬以千里。
举个真实的例子,某头部车企做自动驾驶决策,把大模型蒸馏到小模型部署在车上,路测的时候发现,大模型能躲开的不规则障碍物,小模型躲不开,解释出来的原因也完全对不上。本质上就是蒸馏丢失了核心的隐式规律,解释出来的东西都是错的。
别把局部解释当全局真相
现在工业界用得最多的LIME、SHAP,本质上都是局部可解释方法。它们做的事情,就是针对某一个样本,扰动输入,看输出怎么变,最后算出每个特征对这个样本输出的贡献值。
局部可解释只能回答单个样本的“是什么导致了这个结果”,回答不了“模型到底学到了什么规律”这个全局问题。更麻烦的是,这种方法天生就有无法避免的偏差。最常见的就是特征共线性场景,两个特征高度相关,方法会随机把贡献分配给其中一个,最终得到的解释完全背离真实逻辑。
比如做信贷风险预测,“近三个月逾期次数”和“近三个月征信查询次数”本身就是高度正相关,一个用户逾期次数多,查询次数自然也多。SHAP可能会把90%的风险贡献算给查询次数,而真实的核心因素其实是逾期次数。你拿着这个解释去做业务调整,只会把风控规则改得越来越歪。
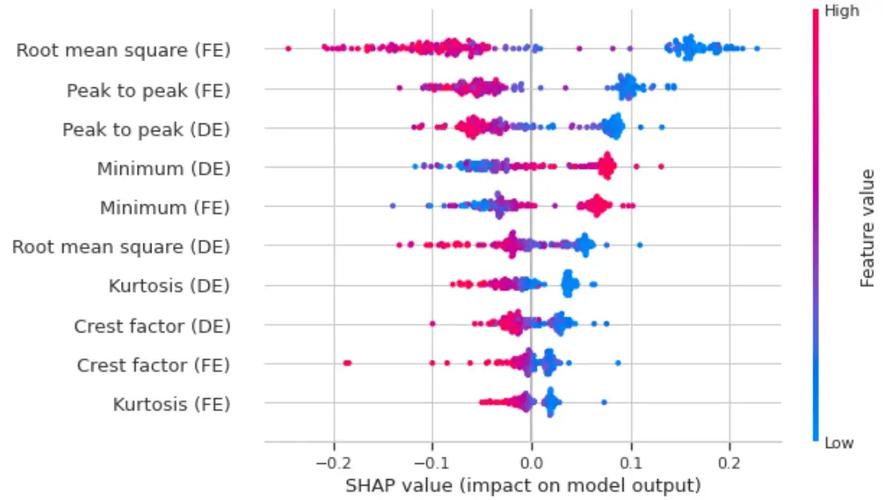 SHAP特征贡献值共线性偏差示例图
不过话说回来,就算没有共线性,局部解释也解决不了因果问题。你看到特征A对这个样本的贡献高,不代表特征A就是导致预测结果的原因,很可能只是它和真正的因果特征挨得近,沾了光。不少发顶会的方法,拿到工业界跑一遍,连数据集换了结果都不对,说白了就是刷榜刷出来的花架子。
工业界要的从来不是100%透明
 工业界要的从来不是100%透明
产学研的脱节,在这个方向上体现得淋漓尽致。学术界拼了命做更准的解释指标,追更高的分数,可工业界压根不需要完全透明的模型。你给银行做风控模型,监管要的是“出现不良贷款的时候,你能说清楚为什么放这笔贷”,用户要的是“我申请信用卡被拒,你能告诉我哪里不符合要求”,没人要你把整个模型的参数、所有决策逻辑全打印出来。
更多时候,工业界要的可解释,本质上是合规需求,是责任界定,不是真的要把黑盒拆穿。当然,这里也有很尴尬的应用边界。你模型真的学到了隐式的歧视性规则,你敢解释出来吗?招聘模型,学到了“候选人年龄超过35岁,得分降低”,信贷模型学到了“某地区的用户违约率高,直接降分”,这些规则模型确实能学得到,你能把这个解释公开吗?不能,这就是风险。解释出来就是歧视性问题,吃罚单吃到饱。不解释,又不符合合规要求,进不去监管要求高的行业。这就是目前大多数团队遇到的死结。
还有一个更隐蔽的风险:错误的解释比没有解释更可怕。如果你拿到一个错误的特征贡献,你会误以为自己懂了模型的行为,进而放松对模型的监控,等到出了问题再回头看,早就积累了大量的错误决策,根本没法回头。
未来的方向其实很清晰,没必要死磕“后处理解释黑盒”这条路。要么从设计模型的时候就走可解释的路线,比如一些表格数据场景,用本身结构就透明的广义加性模型,替代黑盒树模型,既能保持精度,又天生可解释。要么就反过来,大模型场景下,让大模型自己生成符合人类认知的解释,再做人工校验,满足合规要求就行,不用强求还原真实决策逻辑。
黑盒就是黑盒。没人能把千亿参数的黑盒完全拆开,我们也不需要完全拆开。能解决手头的问题,够了。