大模型爱胡说八道?检索增强生成是真救星还是伪概念
上个月帮朋友做新能源项目的招投标文件,用大模型梳理行业合规要求,结果出来三个查无此人的行业标准。差点坑得他标书作废。
这种事你肯定也遇到过对吧?用大模型干点正经事,最怕它张口就来,脸不红心不跳地瞎编。
有人说,上检索增强生成啊,这不就能治大模型瞎说了吗?
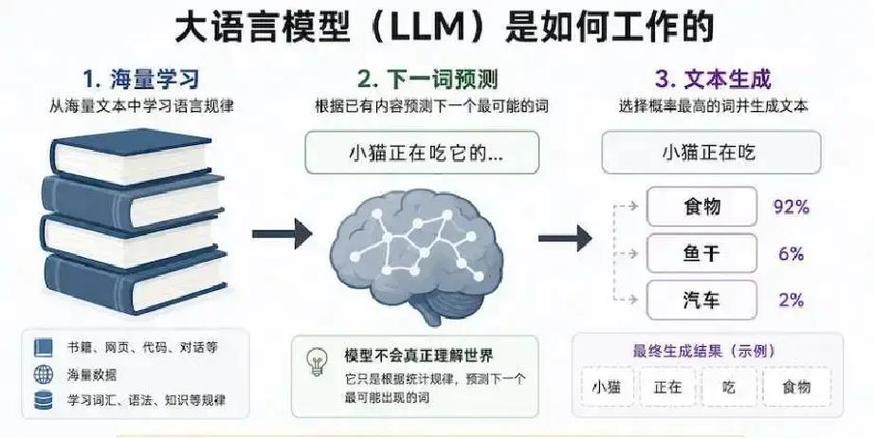 大模型为啥天生改不了瞎编的毛病
你得先搞懂根在哪。大模型本质是干嘛的?猜下一个字。从训练的第一天开始,它的任务就是根据上文,拼出概率最大的下一个字。
它所有的知识,都锁在训练完成那一刻的参数里。训练数据截止到2023年12月,那2024年出的新政策、新法规,它半个字都不知道。
要是你问的是你公司自己的内部数据?上个月刚写完的新品说明书,部门Q3的预算表,训练数据里连你公司叫啥都不知道,它不瞎编才怪。
有人说,把新数据塞进去重新训不行吗?太贵了啊。动则几百万几千万的训练成本,中小公司扛得住?就算你训完了,明天又出新数据了,你再训一遍?
就算你不差钱,上下文窗口就那么大,你把一万篇文档全塞进去,token费算下来,问一次问题几十块,谁用得起?
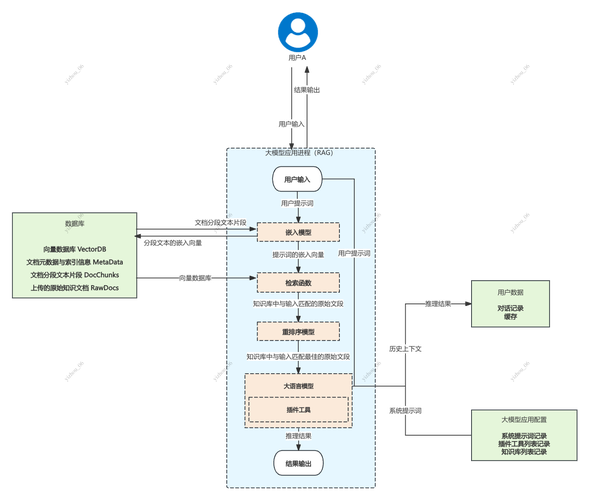 检索增强生成RAG完整工作流程图
这个逻辑是不是特别好懂?说白了就是开卷考试。原来大模型是闭卷,全靠脑子背,背不住就蒙。现在开卷允许你带参考资料,做题前先翻到正确的页码,照着抄要点,当然错的少多了。
说实话,它能火到今天,最大的优势就是便宜灵活。不用重新训练大模型,只要你更新知识库,就能实时得到最新的回答,成本只有微调的几十分之一,对大部分想落地大模型的企业来说,这门槛一下就下来了。
我见过不少做企业内部知识库的,原来想做个问答机器人,报预算百万起,现在搭个基础的检索增强生成服务,几万块就能上线先用着,不合适再调,试错成本低太多了。
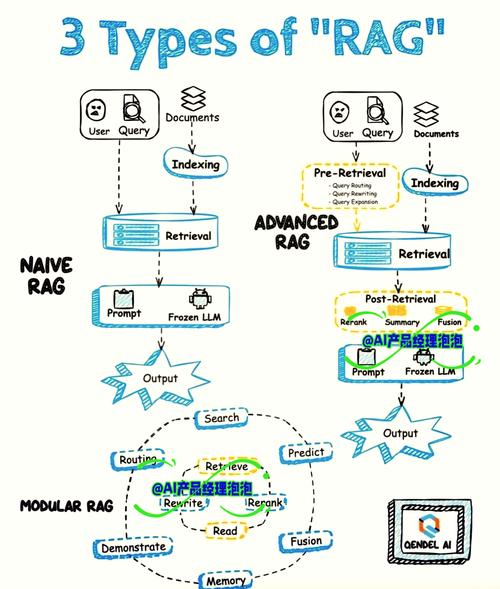 检索增强生成文档切分错误案例图
第二个误区,很多人说检索增强生成能代替微调,不对。它俩解决的根本不是一个问题。检索增强生成是给大模型补知识,你让它知道你家有什么产品,最新的政策是什么,它干这个在行。你要是想改大模型的说话风格,让它按照你家的业务逻辑回答问题,比如你要求它所有回答必须分点,必须符合客服的话术要求,那还是得微调,RAG改不了大模型本身的能力。
还有一个误区,觉得上了RAG大模型就肯定不会瞎编了。哪有这么好的事?你原始资料本身就错了,它当然给你错的回答,垃圾进垃圾出,放哪都适用。就算你资料对,检索对,大模型引用的时候还是有可能张冠李戴,只是概率比原来低很多而已。
不过话说回来,检索增强生成已经算是这两年大模型落地领域,最实在的一个技术了。它不是什么能推翻一切的革命性创新,就是一个刚刚好解决了当下痛点的方案:解决了大模型知识过时、私有数据接入成本高的问题,又不用你花大价钱训模型,对大部分企业来说,这就够了。
你要是现在正愁怎么把自己的私有数据喂给大模型用,又不想花大价钱,那真可以试试搭个RAG玩玩,只是别忘了提前把你的资料理清楚,别像我一样,踩完切分的坑再踩检索的坑,折腾好几天。
大模型为啥天生改不了瞎编的毛病
大模型为啥天生改不了瞎编的毛病
你得先搞懂根在哪。大模型本质是干嘛的?猜下一个字。从训练的第一天开始,它的任务就是根据上文,拼出概率最大的下一个字。
它所有的知识,都锁在训练完成那一刻的参数里。训练数据截止到2023年12月,那2024年出的新政策、新法规,它半个字都不知道。
要是你问的是你公司自己的内部数据?上个月刚写完的新品说明书,部门Q3的预算表,训练数据里连你公司叫啥都不知道,它不瞎编才怪。
有人说,把新数据塞进去重新训不行吗?太贵了啊。动则几百万几千万的训练成本,中小公司扛得住?就算你训完了,明天又出新数据了,你再训一遍?
就算你不差钱,上下文窗口就那么大,你把一万篇文档全塞进去,token费算下来,问一次问题几十块,谁用得起?
检索增强生成到底是怎么干活的
说白了,检索增强生成就是给大模型装了个活的外接知识库,还配了个专门找资料的小助理。 不用改大模型本身的参数,也不用把所有资料全塞给大模型,流程非常简单。我给你掰扯掰扯: 第一步,你把所有要用的资料,不管是内部文档、最新新闻还是行业数据库,全切成合适大小的小块,再把每一块转成计算机能读懂的向量,存进专门的向量数据库。 第二步,用户提问题,先把问题也转成同一个空间的向量,去向量数据库里捞,把和问题最相关的那几块资料找出来。 第三步,把「用户的问题」加上「捞出来的参考资料」拼在一起,喂给大模型,让大模型照着资料写回答。检索增强生成RAG完整工作流程图
这个逻辑是不是特别好懂?说白了就是开卷考试。原来大模型是闭卷,全靠脑子背,背不住就蒙。现在开卷允许你带参考资料,做题前先翻到正确的页码,照着抄要点,当然错的少多了。
说实话,它能火到今天,最大的优势就是便宜灵活。不用重新训练大模型,只要你更新知识库,就能实时得到最新的回答,成本只有微调的几十分之一,对大部分想落地大模型的企业来说,这门槛一下就下来了。
我见过不少做企业内部知识库的,原来想做个问答机器人,报预算百万起,现在搭个基础的检索增强生成服务,几万块就能上线先用着,不合适再调,试错成本低太多了。
别神化,检索增强生成的坑比你想的多
我上个月帮朋友调内部知识库,踩了整整一周的坑,最大的感受就是,很多人把它吹成万能解药,实际上它解决不了所有问题,甚至一不小心就掉坑里。 第一个坑就是检索错了。你问的是今年Q3的预算,结果向量检索把去年Q3的预算给捞出来了,大模型再厉害,照着错的资料回答,能对吗? 我那次踩的坑更离谱,切分文档的时候用了固定长度切分,把「禁止在私人电脑登录企业微信」这句话切成了两半,前半块的内容截出来就是「允许员工在私人设备...」,用户一检索刚好捞到这块,大模型直接回答可以登录,差点搞出信息安全事故。检索增强生成文档切分错误案例图
第二个误区,很多人说检索增强生成能代替微调,不对。它俩解决的根本不是一个问题。检索增强生成是给大模型补知识,你让它知道你家有什么产品,最新的政策是什么,它干这个在行。你要是想改大模型的说话风格,让它按照你家的业务逻辑回答问题,比如你要求它所有回答必须分点,必须符合客服的话术要求,那还是得微调,RAG改不了大模型本身的能力。
还有一个误区,觉得上了RAG大模型就肯定不会瞎编了。哪有这么好的事?你原始资料本身就错了,它当然给你错的回答,垃圾进垃圾出,放哪都适用。就算你资料对,检索对,大模型引用的时候还是有可能张冠李戴,只是概率比原来低很多而已。
不过话说回来,检索增强生成已经算是这两年大模型落地领域,最实在的一个技术了。它不是什么能推翻一切的革命性创新,就是一个刚刚好解决了当下痛点的方案:解决了大模型知识过时、私有数据接入成本高的问题,又不用你花大价钱训模型,对大部分企业来说,这就够了。
你要是现在正愁怎么把自己的私有数据喂给大模型用,又不想花大价钱,那真可以试试搭个RAG玩玩,只是别忘了提前把你的资料理清楚,别像我一样,踩完切分的坑再踩检索的坑,折腾好几天。