看懂大模型的下半场:多模态对齐到底是什么
前阵子跟大厂AI实验室的朋友吃饭,他吐槽说现在招人,十个面试说做过多模态的,八个答不上多模态对齐到底要做什么。
张口就是“把文本和图像特征映射到同一个向量空间”。
呵,这话没错,但只对了十分之一。
你理解的多模态对齐,早就过时了
最早的多模态对齐确实就是这么做的。CLIP出来那会,大家玩对比学习,同个内容的图文特征往近拉,不同内容的往远推,最后所有模态的特征都能塞进同一个空间,随便哪个模态都能搜另一个模态的内容,这不就是对齐嘛。
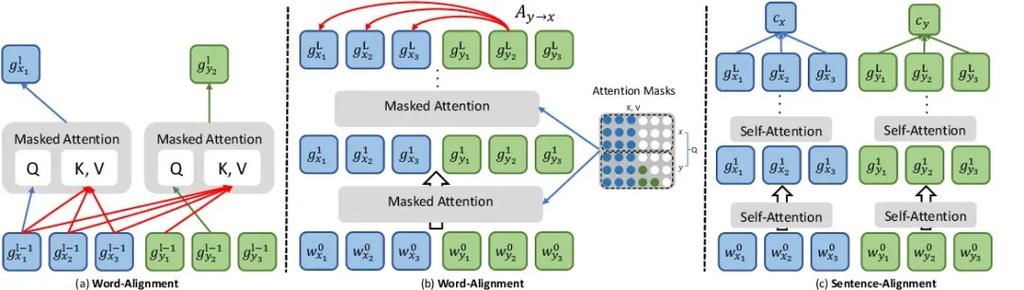 CLIP对比学习多模态特征对齐示意图
放到现在大模型时代,这套逻辑早就不够用了。
你拿GPT-4V试一次就懂。你拍一张你家猫趴在你键盘上的图,跟它说“这货又打扰我赶方案,帮我写个吐槽的朋友圈文案”,它要做的仅仅是把猫和键盘的特征跟文字对齐吗?
它要对齐图里猫欠揍的状态,对齐你文字里的吐槽情绪,对齐朋友圈的社交语境,最后还要把这些揉成符合你语气的文案输出。这一整套认知层面的匹配,才是现在说的多模态对齐。哪里是拼个特征空间那么简单。
说白了,早年对齐是为了“能检索”,现在对齐是为了“能理解”。差着好几个量级呢。
现在多模态对齐,到底卡在哪了
说实话,现在开源的多模态模型一抓一大把,真能打实战的没几个。别说跟GPT-4V比,好好看懂一张带箭头的复杂流程图都费劲。
核心卡两个地方。第一个就是细粒度语义对齐。
我举个例子,你给模型一张图,上面三个杯子放桌子左边,红、蓝、半红半蓝各一个。问它“红杯子和蓝杯子中间那个杯子是什么颜色”,现在百分之七八十的模型都会答错。
再难一点,给一张聊天截图,问它“倒数第二句里的‘它’指的是什么”,错误率直接飙到百分之九十以上。为什么?位置、指代、上下文这些细节,靠大规模粗粒度的预训练对齐根本拉不回来,稍不留神就偏了。
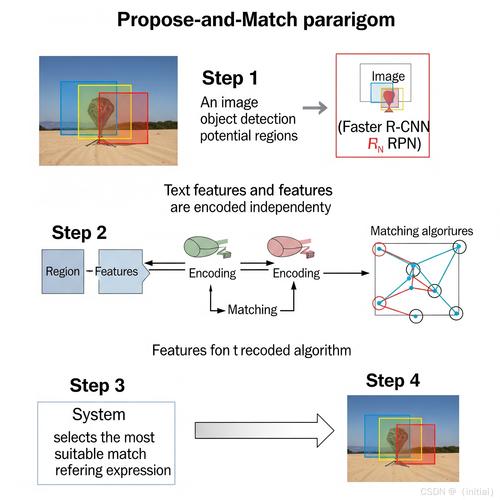 大模型多模态细粒度对齐错误案例图
第二个坑就是动态意图对齐。很多人用多模态产品都遇见过这种情况:先发一张火锅的图,再补一句“就在我家楼下,你猜人均多少”,模型非要跟你扯火锅的起源发展,完全get不到你要干嘛。
它对齐了图文的表层特征,没对齐你说话的真实意图啊。
不过话说回来,这两年进展真的快。我上个月测国内几个头部大厂最新的多模态版本,拿满是小字的PPT截图,让它摘出第三页第二段的核心观点,居然十次能对八九次,放两年前想都不敢想。
多模态对齐才是大模型落地的真门槛
 多模态对齐才是大模型落地的真门槛
现在所有人都喊大模型要落地,要做行业应用,可是绕来绕去绕不开多模态对齐。
做医疗AI,你要对齐CT影像、病历文本、医生口头问诊的记录,不对齐能出准确的诊断参考吗?不能。
做工业质检,你要对齐摄像头拍的零件图、工程师的缺陷标注文本、过往的维修记录,不对齐能准确识别缺陷吗?不能。
做K12教育AI,学生画了个错的电路图,写了半对的解题步骤,你要对齐图里的线路错误,对齐学生写的步骤,还要对齐学生想问的问题,不对齐能做个性化辅导吗?更不能。
之前大家卷参数,卷到现在万亿参数都出来了,再往上卷成本已经扛不住了。接下来拼什么?拼数据?拼微调框架?其实都不如拼多模态对齐的能力。
参数再大,对齐做不好,给你图你看错细节,给你语音你接不上意图,用户用一次就再也不用了。现在市面上多少所谓的多模态大模型,就是套了个CLIP的预训练权重,微调几十万条图文对就敢出来吹“全场景覆盖”,真用起来连身份证正反面都分不清楚,骗投资人可以,骗用户不好使。
我前阵子接触一个做养老AI的创业团队,做出来的机器人能帮老人拍血压计的读数,自动整理成周报发给社区医生,还能提醒老人按时吃药,核心就是把血压计的图像读数、老人的健康档案文本、语音对话的意图,三个模态对齐做到了99%以上的准确率,现在已经进了十几个社区,老人用着都说好。这才是真落地,比那些吹得天花乱坠的概念靠谱一万倍。
其实往远了想,人类的认知本身就是一个多模态对齐的过程。我们看见苹果,摸到它的硬度,尝到它的甜味,听到别人叫它“苹果”,自然就把所有信息对齐到同一个认知标签下,AI现在学的,不就是这套最基础也最核心的本事吗?
再过三年回头看,现在卷参数的热闹都是铺垫。真正能拉开差距的,就是多模态对齐的功力。你说呢?