挤出来的算力:大模型推理优化的破局实践
训练出大模型只是第一步。把模型塞到算力不够大的服务器,塞进手机车机,还要让用户点一下就能出结果,这才是真的落地。很多团队堆了几个月训出模型,一看推理成本,一个月的云服务费能烧掉小团队大半年的预算,直接卡在这动不了。
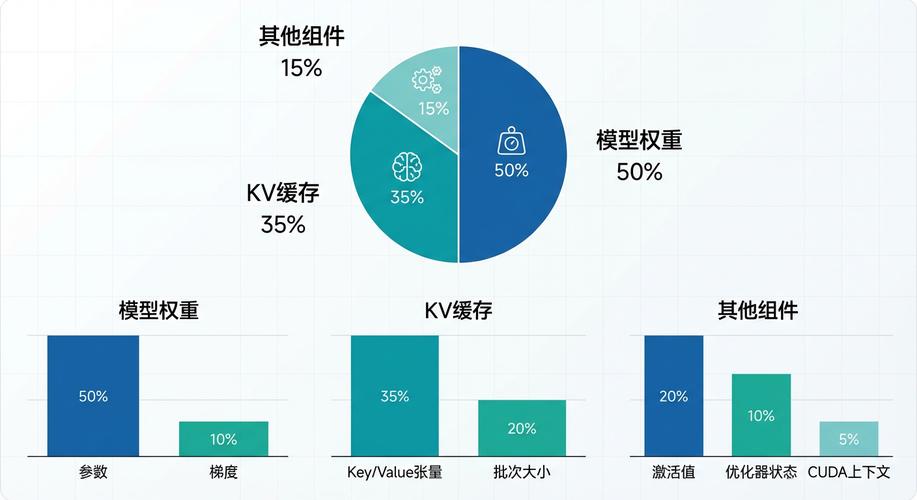 大模型推理部署显存占用对比图
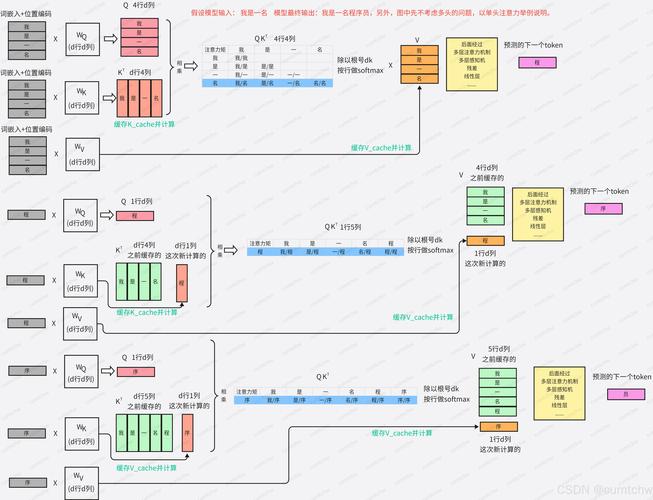 大模型KV缓存分页优化架构图
 真实业务里踩过的坑
现在大部分优化方法的效果,都是在标准基准数据集上测出来的,拿到自己的业务场景,效果可能差一半都不止。比如你做电商智能客服,9成以上的用户输入都不到100token,那些针对128k长上下文做的优化,对你来说完全没用,白瞎了好几个工程师折腾半个月的功夫。
还有人盯着吞吐量优化,觉得单位时间出更多token就是好,但是如果你做的是交互式对话,要求单请求的低延迟,批量推理提升吞吐量的方法反而会让每个用户都等更久,完全搞错了方向。
再比如,很多团队一上来就给模型剪枝量化,不管模型多大。1B参数以下的小模型,本身体积就小,剪完压缩率上去了,速度没提多少,精度掉了好几个点,完全是赔本买卖。还有现在很多端侧推理的宣传,吹得神乎其神,说能跑7B甚至更大的模型,能跑是能跑,生成一个token要半秒,聊十句就得等一分钟,手机还烫得拿不住,根本没法用。
 接下来的方向
现在多数人都盯着模型结构本身做优化,要么剪枝要么量化,其实系统层和硬件层的结合还有很多空间没挖。比如不同的推理芯片,访存特性完全不一样,针对NPU的并行特性做算子重排,就能再提一成多的速度,很多团队还没做透。
还有动态自适应优化,别搞一刀切。同一个服务里,有短文本对话,也有长文档分析,给短文本用全精度保证速度和精度,给长文本自动开量化压缩显存,根据请求的任务类型自动切策略,比固定一种方法划算得多。
说实话,没有哪一种优化方法能通吃所有场景。落地的时候先算清楚自己的核心需求:是省成本降显存,还是提速度降延迟,还是必须保精度?对着需求选方法,别为了刷指标瞎折腾。很多时候,适合自己业务的,就是最好的。
落地的第一道坎在哪
生成式推理的逻辑,和训练完全不一样。训练是批量喂数据,卡满算力就行,推理是一个请求接一个请求,还要逐token生成,每一步都要访存,对延迟和显存的要求苛刻得多。现在多数大模型的参数量都在百亿级别,就算是云端部署,一张消费级显卡也塞不下完整的模型权重。更别说长上下文场景,128k的上下文窗口,光是kv缓存就能占掉近10GB的显存,比模型本身占的还多。谁也不想对着转圈圈的加载图标发呆三分钟。对ToC产品来说,超过两秒的延迟,一半用户直接走了。大模型推理部署显存占用对比图
几个经过验证的务实方向
现在大家用得最多的是量化,说白了就是用更低比特的数代替原来的32位浮点数,砍显存体积立竿见影。但不是所有量化都能用。早期的均匀量化,对大模型来说掉点掉的厉害,4比特量化出来的模型,生成内容前言不搭后语。现在的按权重重要性量化,比如AWQ、GPTQ,核心思路就是给重要的权重保留更高精度,不重要的直接压,这样一来,7B模型INT4量化后,显存砍到四分之一,精度损失不到1个百分点,大部分生成场景都能用。但反过来说,如果是百亿参数以上的稀疏大模型,AWQ的压缩收益就远不如针对分布优化的SqueezeLLM,选错方法等于白折腾。 再讲kv缓存优化,这是很多新手容易忽略的点。生成式推理每出一个新token,都要把之前所有token的key和value存下来,不然就得重新计算,上下文越长,缓存占的显存占用越高。现在主流的解法是分页缓存,把不常用的冷缓存挪到CPU内存,要用的时候再换进显存,能把缓存的显存占用砍一半还多。也有团队直接给kv缓存做量化,大部分场景下误差可以忽略,但如果你做的是法律条文检索、医疗文档分析这种对准确性要求极高的场景,kv量化一定要慎⽤,稍微丢一点信息就可能错判关键内容。 还有投机解码,这个trick挺巧妙,用一个小模型先快速生成候选token,再让大模型只做验证修正,能把推理速度提一倍多。但边界很清晰:如果小模型和大模型的能力差太大,比如小模型没见过专业领域的语料,生成的候选token错漏百出,大模型修正的时间反而比从头生成还长,得不偿失。大模型KV缓存分页优化架构图
真实业务里踩过的坑
真实业务里踩过的坑
现在大部分优化方法的效果,都是在标准基准数据集上测出来的,拿到自己的业务场景,效果可能差一半都不止。比如你做电商智能客服,9成以上的用户输入都不到100token,那些针对128k长上下文做的优化,对你来说完全没用,白瞎了好几个工程师折腾半个月的功夫。
还有人盯着吞吐量优化,觉得单位时间出更多token就是好,但是如果你做的是交互式对话,要求单请求的低延迟,批量推理提升吞吐量的方法反而会让每个用户都等更久,完全搞错了方向。
再比如,很多团队一上来就给模型剪枝量化,不管模型多大。1B参数以下的小模型,本身体积就小,剪完压缩率上去了,速度没提多少,精度掉了好几个点,完全是赔本买卖。还有现在很多端侧推理的宣传,吹得神乎其神,说能跑7B甚至更大的模型,能跑是能跑,生成一个token要半秒,聊十句就得等一分钟,手机还烫得拿不住,根本没法用。
接下来的方向
接下来的方向
现在多数人都盯着模型结构本身做优化,要么剪枝要么量化,其实系统层和硬件层的结合还有很多空间没挖。比如不同的推理芯片,访存特性完全不一样,针对NPU的并行特性做算子重排,就能再提一成多的速度,很多团队还没做透。
还有动态自适应优化,别搞一刀切。同一个服务里,有短文本对话,也有长文档分析,给短文本用全精度保证速度和精度,给长文本自动开量化压缩显存,根据请求的任务类型自动切策略,比固定一种方法划算得多。
说实话,没有哪一种优化方法能通吃所有场景。落地的时候先算清楚自己的核心需求:是省成本降显存,还是提速度降延迟,还是必须保精度?对着需求选方法,别为了刷指标瞎折腾。很多时候,适合自己业务的,就是最好的。