强化学习技术:从出圈到落地,它才是AI真正的破局点
你还记得2016年AlphaGo赢李世石那局吗?我当时挤在实验室的二手显示器前,看着屏幕上那步人类棋手想都想不到的“神之一手”,后脖子都发凉。那是我第一次真切感受到,强化学习技术能搞出多大的动静。
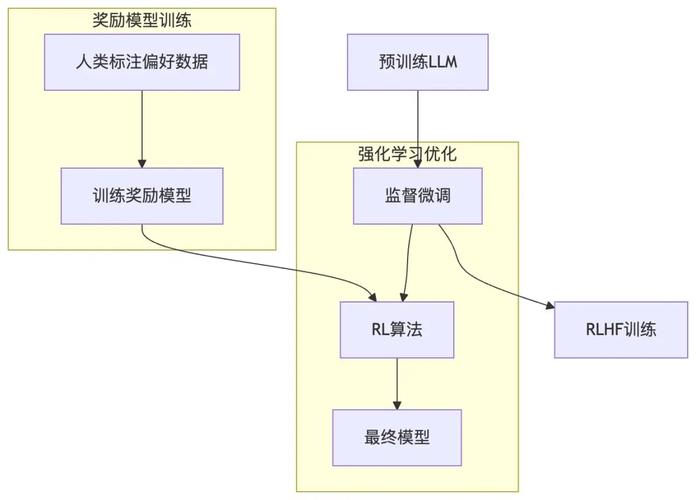 监督学习与强化学习训练流程对比图
这两年大模型火透了,很多人提起强化学习,第一反应就是ChatGPT背后的RLHF,也就是基于人类反馈的强化学习。好像强化学习就是大模型的一个附属工具。这话真委屈了强化学习。人家早在上世纪就有了完整的理论框架,沉寂了几十年,才等到现在算力起来,重新出圈。
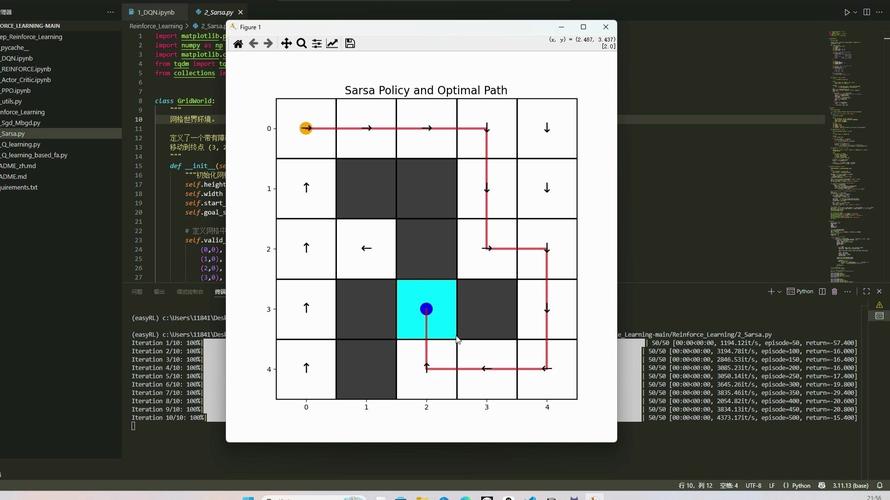 DeepMind Atari游戏强化学习训练结果图
现在你看那些能做复杂动作的机器人,哪个不是大模型预训练加强化学习调策略?老路走不通了,新的路子一下子就打开了。
 闷声发财,现在产业里强化学习技术赚翻了
很多人天天盯着RLHF那点事,说强化学习就是给大模型对齐的工具。其实人家在产业里,早就闷声发大财好多年了。
就说大家天天用的互联网推荐系统,你刷短视频刷信息流,哪来这么准的推荐?头部大厂现在核心的动态排序模块,基本都换强化学习了。原来的协同过滤、深度学习都是静态的,拿历史数据训完就不变了,可用户的喜好是会变的啊,今天喜欢看猫,明天可能想看球赛。强化学习能实时和用户交互,点了赞就多推同类,划走了就调整,转化率轻轻松松涨三到五个点,这可都是直接算进营收里的真金白银。
还有能源电网调度,现在风电光伏占比越来越高,发电功率看天吃饭,忽高忽低,怎么调储能、调火电,平衡整个电网的负荷?原来靠老工程师靠着经验拍板,误差大,浪费多。现在用强化学习模型,实时根据发电数据调整,能比人工调度降低两到三个点的耗煤成本,一个省级电网一年下来能省好几个亿,这是什么概念?
我去年跑产业调研,去过深圳一家做智能仓储的创业公司,他们用强化学习做AGV机器人的路径调度,整个仓库几十上百个机器人同时跑,完全不会堵,比原来传统的A*算法效率高了18%,一个大仓一天能多拣四千多单,老板请我们吃饭的时候说,当初投那点调模型的钱,三个月就赚回来了。
不过话说回来,强化学习现在也不是完美的。样本效率还是低,哪怕有大模型加持,训一个复杂场景的模型,成本还是不少。还有可解释性的问题,你问它为什么这么调度,它说不出来,所以在金融、医疗这种对可解释性要求极高的领域,落地还是慢。
但架不住方向对啊。大模型把AI的“脑子”给装满了,把世界知识都给了AI,可AI要真的走出屏幕,去真实世界干活,去解决动态的、未知的问题,还是得靠强化学习这套“试错进化”的逻辑。
你说对不对?
别被教科书忽悠,强化学习技术根儿上就不一样
现在很多入门科普都把强化学习归为机器学习的一个分支,和监督学习、无监督学习放一块列知识点。说直白点,这就是在误导人。 监督学习是啥?拿标好标准答案的数据喂,你给猫标猫,给狗标狗,模型照着背规律就行。无监督学习是自己在一堆数据里找相似,凑堆儿。 强化学习呢?它根本不吃你给的标准答案。你把一个智能体扔到环境里,告诉它什么行为能拿奖励,剩下的,它自己试。摔了撞了拿不到奖励,它自己调整参数。对了就多拿奖励,它就记住这个路子。 就像小孩学走路,你能拿着教案教他每一步脚踝要发多少力吗?不可能。摔几次,疼了,他自然就摸出怎么平衡了。这个逻辑,和监督学习从根儿上就是两码事。监督学习与强化学习训练流程对比图
这两年大模型火透了,很多人提起强化学习,第一反应就是ChatGPT背后的RLHF,也就是基于人类反馈的强化学习。好像强化学习就是大模型的一个附属工具。这话真委屈了强化学习。人家早在上世纪就有了完整的理论框架,沉寂了几十年,才等到现在算力起来,重新出圈。
从游戏破局到产业落地,踩过的坑能绕硅谷三圈
最早让强化学习出圈的,还是DeepMind那批人玩Atari游戏。十几年前,他们让强化学习智能体自己玩打砖块、赛车这些老游戏,没给任何玩法教程,就告诉它得分高拿奖励,死了扣分。结果玩了几千万局,出来的智能体能把人类顶尖玩家打蒙,得分甩出去好几倍。 当时整个业内都疯了,说这就是通用AI的起点啊,所有人都扎进去搞。结果没两年,热情就被冷水浇灭了。为什么?一出游戏,到真实场景就拉胯。 游戏里的规则多清晰啊。吃一个金币加100分,碰到怪物掉一条命,奖励函数明明白白写在那里。真实世界呢?你让智能体开车,怎么给奖励?不压线给一分?开慢了也算对?开快了就算错?碰到突发情况闯红灯避让行人,你罚它还是奖励它? 当年我同实验室的师兄,硕士课题做机械臂抓取,调奖励函数调了三个月。每天对着屏幕改参数,改一次训一天,出来结果不对再改。头发一把一把掉,最后勉强能在仿真环境抓到东西,拿到真实机器上一跑,偏出去五厘米,直接把杯子碰地上碎了。你说闹心不闹心。 这种坑踩多了,大家才慢慢摸出门路。原来纯从零开始的强化学习,根本扛不住真实世界的复杂。直到后来大模型预训练出来了,才把最大的那个坑填上——用大模型预训练好的世界认知给强化学习打基础,不用让智能体从零开始瞎摸,样本效率一下子提了几十倍。DeepMind Atari游戏强化学习训练结果图
现在你看那些能做复杂动作的机器人,哪个不是大模型预训练加强化学习调策略?老路走不通了,新的路子一下子就打开了。
闷声发财,现在产业里强化学习技术赚翻了
闷声发财,现在产业里强化学习技术赚翻了
很多人天天盯着RLHF那点事,说强化学习就是给大模型对齐的工具。其实人家在产业里,早就闷声发大财好多年了。
就说大家天天用的互联网推荐系统,你刷短视频刷信息流,哪来这么准的推荐?头部大厂现在核心的动态排序模块,基本都换强化学习了。原来的协同过滤、深度学习都是静态的,拿历史数据训完就不变了,可用户的喜好是会变的啊,今天喜欢看猫,明天可能想看球赛。强化学习能实时和用户交互,点了赞就多推同类,划走了就调整,转化率轻轻松松涨三到五个点,这可都是直接算进营收里的真金白银。
还有能源电网调度,现在风电光伏占比越来越高,发电功率看天吃饭,忽高忽低,怎么调储能、调火电,平衡整个电网的负荷?原来靠老工程师靠着经验拍板,误差大,浪费多。现在用强化学习模型,实时根据发电数据调整,能比人工调度降低两到三个点的耗煤成本,一个省级电网一年下来能省好几个亿,这是什么概念?
我去年跑产业调研,去过深圳一家做智能仓储的创业公司,他们用强化学习做AGV机器人的路径调度,整个仓库几十上百个机器人同时跑,完全不会堵,比原来传统的A*算法效率高了18%,一个大仓一天能多拣四千多单,老板请我们吃饭的时候说,当初投那点调模型的钱,三个月就赚回来了。
不过话说回来,强化学习现在也不是完美的。样本效率还是低,哪怕有大模型加持,训一个复杂场景的模型,成本还是不少。还有可解释性的问题,你问它为什么这么调度,它说不出来,所以在金融、医疗这种对可解释性要求极高的领域,落地还是慢。
但架不住方向对啊。大模型把AI的“脑子”给装满了,把世界知识都给了AI,可AI要真的走出屏幕,去真实世界干活,去解决动态的、未知的问题,还是得靠强化学习这套“试错进化”的逻辑。
你说对不对?