自然语言处理:那些你天天在用,却不知道的科研突破
昨天我清理手机输入法词库,突然发现它居然能猜出我接下来要打一整句话,连我上周跟朋友说要去的那家隐在老巷里的糖水铺名字都能拼对。
我愣了。
十年前接触自然语言处理的时候,哪敢想这事儿?
很多人听着“自然语言处理”五个字玄乎得不行,其实你刷的短视频自动字幕、跟智能音箱聊天、发微信的输入法联想、甚至网购时跟AI客服对线,全是它在背后撑着。
 早期自然语言处理规则引擎代码截图
那时候学界吵得不可开交,规则派和统计派各不退让。统计派就是攒一大堆语料库,算词和词之间的共现概率,哪个组合概率高就选哪个。
从九十年代到零几年,统计派慢慢占了上风,可效果也就那样,中文分词正确率能摸到80%,都能去顶会发论文了。你要是那时候用智能手机输入法,打错字连猜都猜不对,对吧?
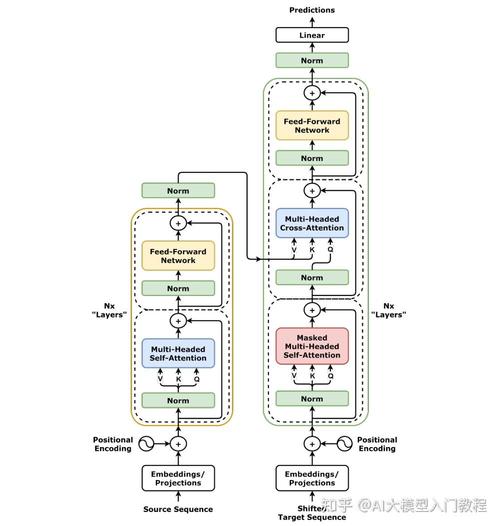 Transformer注意力机制结构示意图
不过话说回来,这十年自然语言处理的进展真的快到吓人。五年前去开ACL,就是自然语言处理方向的顶会,那时候大家还在讨论怎么给BERT做微调提升分类效果,今年再去,全是大模型对齐、多模态自然语言理解、小样本低资源学习,好多新名词我都没听过,感觉自己像个刚进实验室的大一新生。
最有意思的是,之前自然语言处理全是躲在实验室发论文,现在半年就能落地到普通人的生活里。前阵子我用国内某大模型帮我改简历,它居然能把我写得颠三倒四的项目经历顺得清清楚楚,还能自动突出匹配岗位的优势,比我前几年花八百块找猎头改得还好,真的惊掉下巴。
 大火之后,自然语言处理还有哪些坑要填
别觉得现在大模型火出圈,自然语言处理就啥问题都解决了,坑多着呢。
第一个就是领域专业知识的准确沉淀问题。你让大模型写个普通的新媒体文案没问题,你让它帮你整理一篇符合临床规范的医学论文摘要,或者帮你分析一份带隐藏条款的法律判决书,它动不动就瞎编内容,俗称“幻觉”,对吧?因为它本质是靠语料概率生成文字,并没有真的“读懂”领域内的硬性规则。
前阵子我看中科院软件所的一篇最新成果,他们做了一个领域自然语言处理的自适应微调框架,能让大模型只用不到一千份标注的领域数据,就能学到准确的专业知识,现在已经在司法文书分析场景落地了,准确率比直接用通用大模型高了快20个百分点,这才是真的能落地的科研突破,不是蹭风口炒概念。
第二个绕不开的问题就是低资源语言的处理困境。现在所有头部大模型,全都是围着中文、英语转,国内很多少数民族语言,还有亚非拉很多小国家的语言,根本没有足够的标注语料训练模型。我前两年认识一个做少数民族文字信息化的老教授,他说他做了十年维吾尔语的自然语言处理模型,效果还不如中文GPT模型零样本能力的十分之一,说的时候真的挺无奈的。不过最近这两年跨语言迁移技术发展很快,已经能把低资源语言的处理效果提上来很多,希望再过几年,这些小众语言也能用上好用的自然语言处理工具。
说句吐槽,现在好多行业里的人,啥项目都往大模型和自然语言处理上蹭,本来一个简单的客服问答,用个几万参数的微调模型就能跑得好好的,非要上个百亿参数的通用大模型,成本翻了几十倍,用户体验一点提升都没有,说白了就是割投资人的热度钱,真的挺没劲的。
我做自然语言处理相关的工作快十五年了,看着这个领域从没人愿意投钱的冷门方向,变成现在全行业抢着进场的香饽饽,感慨真的很多。
早年我们申请几十万的项目经费,改十几遍本子都中不了,现在随便一个刚毕业的学生凑个团队做自然语言处理创业,就能拿几个亿的融资,变化快得让人反应不过来。
但是话说回来,不管风口怎么变,真正解决问题的科研,才是能留下来的。当年做统计自然语言处理的那群前辈,没人追着炒热度,他们攒出来的第一个大规模中文标注语料库,现在还在用来训练大大小小的模型,这就是功劳。
昨天跟我当年的博导吃饭,他说他读博的时候,最大的梦想就是做一个能真正听懂人话的机器,当年写在博士论文封底的猜想,现在变成了人人口袋里都能用的工具。
你说神奇不神奇?
早年的自然语言处理,真的像教鹦鹉说话
那时候哪有什么大模型啊,全靠语言学专家一条一条手写规则。比如你要识别“我吃苹果”里谁是动作发出者谁是被吃的,得写好几百条逻辑判断,换个语序“苹果被我吃了”,整个逻辑全乱,又得推翻了重新写。 我当年帮导师做一个中文分词的小项目,就为了分清“南京市长江大桥”到底该切成“南京 市长 江大桥”还是“南京市 长江 大桥”,整整熬了三个大夜,头都熬秃了。 说实话,那时候做自然语言处理,真的是拿着小块积木搭摩天楼,搭到第十层就塌,看不到任何能到顶的希望。早期自然语言处理规则引擎代码截图
那时候学界吵得不可开交,规则派和统计派各不退让。统计派就是攒一大堆语料库,算词和词之间的共现概率,哪个组合概率高就选哪个。
从九十年代到零几年,统计派慢慢占了上风,可效果也就那样,中文分词正确率能摸到80%,都能去顶会发论文了。你要是那时候用智能手机输入法,打错字连猜都猜不对,对吧?
Transformer出来之后,整个自然语言处理界天翻地覆
2017年谷歌那篇《Attention Is All You Need》发出来的时候,我刚博士毕业在互联网公司混项目,整个圈子直接炸了。 一开始不少老专家还没当回事,不就是个新的神经网络结构吗?结果不到两年,BERT出来,直接把所有自然语言处理任务的现有最优成绩刷了个遍,当时所有人都傻了。 说白了,Transformer的核心就是注意力机制,它能牢牢抓住一句话里不同词之间的关联,不管两个词隔得有多远,都能准确对上。不像之前的循环神经网络,隔个十几个词,早就忘了前面说的是什么了。 举个例子,“我把水杯放在桌子上,它现在满了”,早年的模型根本搞不清“它”指的是水杯还是桌子,现在随便一个普通大模型都能一秒分清楚,这就是差距。Transformer注意力机制结构示意图
不过话说回来,这十年自然语言处理的进展真的快到吓人。五年前去开ACL,就是自然语言处理方向的顶会,那时候大家还在讨论怎么给BERT做微调提升分类效果,今年再去,全是大模型对齐、多模态自然语言理解、小样本低资源学习,好多新名词我都没听过,感觉自己像个刚进实验室的大一新生。
最有意思的是,之前自然语言处理全是躲在实验室发论文,现在半年就能落地到普通人的生活里。前阵子我用国内某大模型帮我改简历,它居然能把我写得颠三倒四的项目经历顺得清清楚楚,还能自动突出匹配岗位的优势,比我前几年花八百块找猎头改得还好,真的惊掉下巴。
大火之后,自然语言处理还有哪些坑要填
大火之后,自然语言处理还有哪些坑要填
别觉得现在大模型火出圈,自然语言处理就啥问题都解决了,坑多着呢。
第一个就是领域专业知识的准确沉淀问题。你让大模型写个普通的新媒体文案没问题,你让它帮你整理一篇符合临床规范的医学论文摘要,或者帮你分析一份带隐藏条款的法律判决书,它动不动就瞎编内容,俗称“幻觉”,对吧?因为它本质是靠语料概率生成文字,并没有真的“读懂”领域内的硬性规则。
前阵子我看中科院软件所的一篇最新成果,他们做了一个领域自然语言处理的自适应微调框架,能让大模型只用不到一千份标注的领域数据,就能学到准确的专业知识,现在已经在司法文书分析场景落地了,准确率比直接用通用大模型高了快20个百分点,这才是真的能落地的科研突破,不是蹭风口炒概念。
第二个绕不开的问题就是低资源语言的处理困境。现在所有头部大模型,全都是围着中文、英语转,国内很多少数民族语言,还有亚非拉很多小国家的语言,根本没有足够的标注语料训练模型。我前两年认识一个做少数民族文字信息化的老教授,他说他做了十年维吾尔语的自然语言处理模型,效果还不如中文GPT模型零样本能力的十分之一,说的时候真的挺无奈的。不过最近这两年跨语言迁移技术发展很快,已经能把低资源语言的处理效果提上来很多,希望再过几年,这些小众语言也能用上好用的自然语言处理工具。
说句吐槽,现在好多行业里的人,啥项目都往大模型和自然语言处理上蹭,本来一个简单的客服问答,用个几万参数的微调模型就能跑得好好的,非要上个百亿参数的通用大模型,成本翻了几十倍,用户体验一点提升都没有,说白了就是割投资人的热度钱,真的挺没劲的。
我做自然语言处理相关的工作快十五年了,看着这个领域从没人愿意投钱的冷门方向,变成现在全行业抢着进场的香饽饽,感慨真的很多。
早年我们申请几十万的项目经费,改十几遍本子都中不了,现在随便一个刚毕业的学生凑个团队做自然语言处理创业,就能拿几个亿的融资,变化快得让人反应不过来。
但是话说回来,不管风口怎么变,真正解决问题的科研,才是能留下来的。当年做统计自然语言处理的那群前辈,没人追着炒热度,他们攒出来的第一个大规模中文标注语料库,现在还在用来训练大大小小的模型,这就是功劳。
昨天跟我当年的博导吃饭,他说他读博的时候,最大的梦想就是做一个能真正听懂人话的机器,当年写在博士论文封底的猜想,现在变成了人人口袋里都能用的工具。
你说神奇不神奇?