被神化也被误解:当下深度学习技术的真实面相
刷抖音的推荐刚好推给你想吃的火锅,AI画图一键出你要的氛围感大片,医院拍CT帮医生筛早期结节……走到哪都能听到深度学习这四个字。好像只要沾上这五个字,啥问题都能解决。
吹得太神了。也误解得太深了。
现在深度学习技术,早就不是堆参数堆算力了
最早AlexNet横空出世那会,大家比的是谁层数多,谁训练数据大。后来GPT出来,更是掀起了参数竞赛,十亿不够百亿,百亿不够千亿,仿佛参数堆上去,智能自然就来了。
这两年风向变了。
不信你翻最近三年NeurIPS、CVPR的接收论文,超过三成都是讲怎么把大模型做小,怎么提升参数利用率。把百亿参数的模型压缩到手机端,还能保留原模型90%以上的精度,这种成果比任何一个新的大模型都更受工业界欢迎。
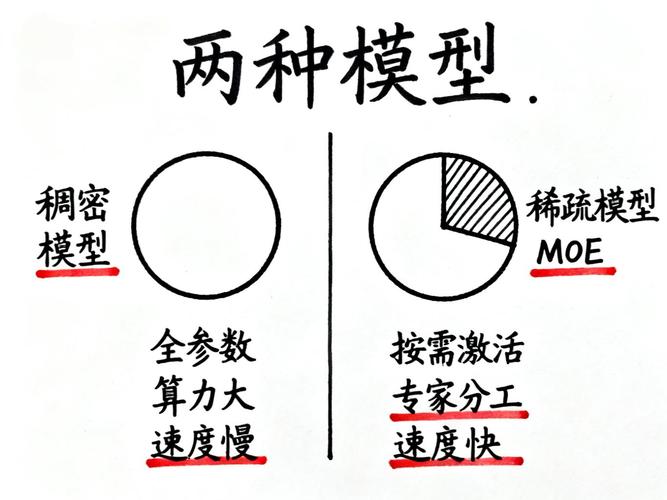 深度学习大模型稀疏化参数对比图
说实话,之前我也觉得,反正云计算越来越便宜,堆就完了。直到去年帮一个做智能门锁的朋友做方案,才被狠狠打了脸。门锁那点可怜的芯片算力,连100M的空间都挤不出来,你拿千亿大模型有什么用?还不是得老老实实抠每一个参数的利用率,把没用的权重剪掉,把重复的特征提取层合并。
哦对了,现在有个方向叫神经架构搜索(NAS),说白了就是让AI自己搜最合适的小模型结构,搜出来的结果比人类设计师调大半年出来的效果还好,参数量还能减一半。这个方向才是真正能让深度学习落地到千家万户的干货啊。
网上天天吹GPT5,吹通用人工智能,其实百分之八十的行业要的不是能写散文的大模型,是能放进嵌入式设备、一块钱成本的芯片就能跑的深度学习。对吧?
深度学习技术落地最头疼的坑,九成的人都想不到
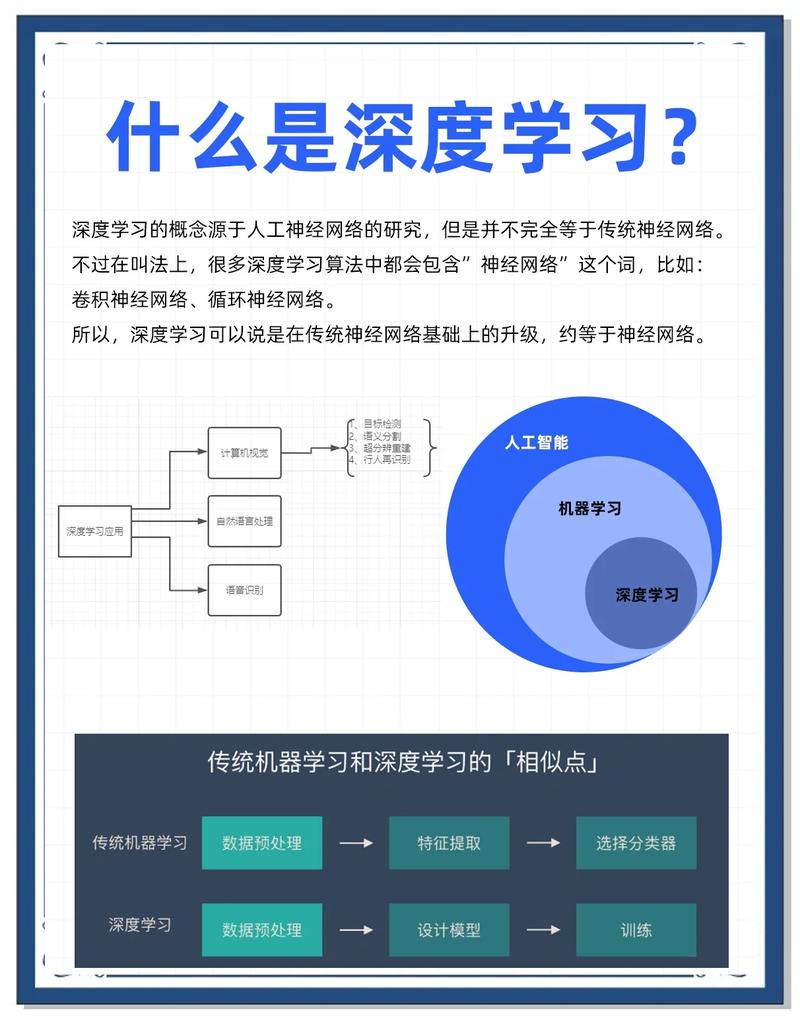 深度学习技术落地最头疼的坑,九成的人都想不到
很多外行觉得,深度学习不就是找几个人标数据,搭个模型训一训,上线就能用了?
差远了。最大的坑,叫分布偏移。什么意思?你训一个人脸识别模型,训练集全是光线充足、拍得清晰的正脸,结果一拿到高铁站用,阴天、戴口罩、路人歪着脖子赶路拍出来的脸,准确率直接掉二十个点。这就是训练数据和真实场景的分布偏移,能直接把一个在实验室里刷榜刷到99%的模型,变成废铁。
之前看过美团无人配送团队发的技术博客,他们在北京训的路况识别模型,拿到深圳一上线直接歇菜。因为南方阴天多,空气湿度大,路牌的整体亮度、对比度和北京完全不一样,模型根本认不出。光调分布偏移就调了三个多月,才勉强能用。
还有个绕不开的坑就是数据隐私。现在不管是国内的个人信息保护法还是欧盟的GDPR,你都不能随便拿用户的原始数据训模型。所以这两年联邦学习才这么火,说白了就是各个合作方各自在本地训模型,只传参数梯度,不传原始用户数据,既用到了多方的数据增量,又不碰隐私红线,简直是为落地量身定做的方向。
不过话说回来,联邦学习现在也有自己的问题。不同节点的数据质量差太多,训出来的模型效果反而不如集中训练的,还有安全风险,高手能从梯度里反推原始用户数据,这个坑现在还没填完。
还有个很现实的问题,就是可解释性。很多人吹深度学习端到端解决一切,真到要负责任的场景,比如银行批贷款、医院开诊断,你总不能说“AI说不行就是不行”吧?得说出个一二三吧?所以现在很多成熟的落地方案,都是深度学习加传统机器学习的组合:用深度学习做复杂的用户行为、影像特征提取,再用传统的逻辑回归、评分卡做最终决策,既吃到了深度学习的能力,又保留了传统模型可解释的优点,这不比端到端硬卷香?
下一个爆发点,深度学习技术往哪走?
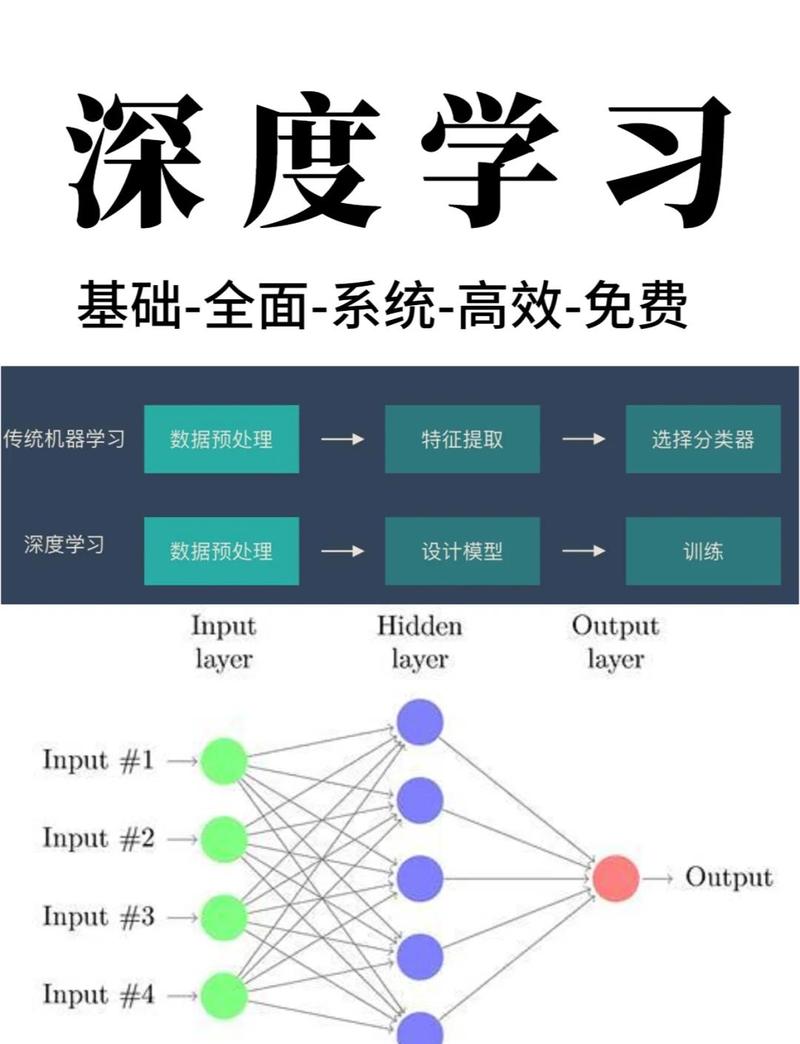 下一个爆发点,深度学习技术往哪走?
最近半年跟几个做基础研究和工业落地的朋友聊天,大家都不盯着纯参数卷了,有两个方向我特别看好,大概率会在未来三五年落地爆发。
第一个就是垂直领域的多模态深度学习,不是那种啥都能做的通用大模型,是专门针对某个行业打磨的。比如专门给骨科做的多模态诊断模型,能同时读CT影像、看过往病历、分析检验报告,输出诊断结果,现在已经有好几家三甲医院在用了,比原来单模态的模型准确率高了快十五个百分点,真的能帮医生省一半的读片时间,减轻不少负担。
第二个就是因果深度学习。现在大部分深度学习都是学关联,就是“看到A就想到B”,不是真的懂A为什么会导致B。比如模型看医院里的病人比街上多,就能得出“医院会导致生病”的荒谬结论,这就是只学关联不学因果的问题。因果深度学习就是要让模型学会从数据里找因果关系,而不是停留在关联统计。
上个月听一个顶会的线上分享,有团队用因果深度学习做抗癌药物的候选化合物筛选,原来筛一遍要一年多,现在能直接把候选范围缩小三分之二,时间缩到三个月,已经有好几个候选药进入临床阶段了。这种进展,比发十篇大模型的论文都有价值。
很多人说深度学习已经摸到瓶颈了,卷不动了。我看根本不是。只是原来那种靠堆参数堆算力堆出来的泡沫破了,接下来是真正沉到各个行业,解决真问题,往基础理论挖深的时代来了。
你身边有什么离谱的深度学习落地坑吗?可以聊聊。