微服务架构设计:科研平台从单体到云原生的踩坑笔记
凌晨三点,实验室的冻电镜数据处理队列又堵了。老周盯着监控图骂了一句:这单体应用,改一行代码全组停摆。真的受够了。
这不是段子。很多科研平台一开始都是单体:一个 Django 或 Spring Boot,背后挂着 PostgreSQL 和几个共享 GPU。发论文够用。可一旦样本量从几百涨到几十万,问题就像雨后蘑菇——冒个不停。编译慢、部署慌、扩缩容靠手、回滚靠祈祷。于是大家开始聊微服务架构设计。但先别急,科研场景的微服务,真不是把电商那套复制过来就完事。
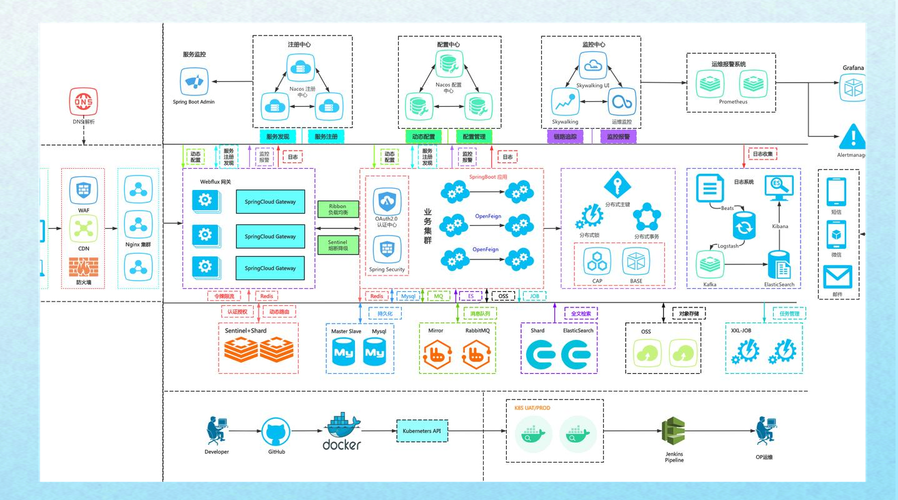 科研云平台微服务架构领域边界拆分示意图
先别急着拆:科研软件和互联网业务根本不是一回事
互联网业务可以接受最终一致,科研数据却常常要求可复现、可追溯、可审计。你说这能一样吗?差远了。一个基因测序流程,从原始 FASTQ 到变异 VCF,中间任何一步换了镜像版本,结果都可能漂移。微服务架构设计在这里的第一原则不是“拆得小”,而是把数据边界和计算边界钉死。
怎么拆?我见过按团队拆的,也见过按数据阶段拆的。按团队拆,康威定律会教你做人:服务边界就是组织沟通边界,组与组甩锅,接口就烂。按数据阶段拆更稳:样本接收、质控、比对、变异检测、注释、AI 打分、报告生成。每个阶段一个服务,或者一组服务。别一上来整 50 个微服务——那是分布式单体,不是架构升级,是运维自残。
还有粒度。一个服务多大?我的经验:能由一个 3 到 5 人小组独立负责,并且有明确输入输出契约,就算合适。科研项目编制少,别硬套“两个披萨团队”。有时候模块化单体更香。真的。
通讯、数据、算力:微服务架构设计里最容易被忽视的三根柱子
先说通讯。REST+JSON 上手快,但在高通量数据流水线里,序列化开销能把 CPU 吃光。gRPC 和 Protobuf 更合适,尤其是服务间传大数组、张量、特征向量。异步呢?Kafka、Pulsar、NATS 都行。关键不是选哪个,而是别让同步调用链拉太长。A 调 B,B 调 C,C 调 D,D 挂了你全挂。这叫雪崩。加超时、重试退避、熔断、舱壁隔离。老四样,管用。
服务网格这几年很热。Istio、Linkerd 把流量治理下沉到 Sidecar。好处明显:mTLS、灰度、遥测,不用改业务代码。可 Sidecar 也吃资源,延迟多一跳。2024 年以后,eBPF 方案起来了,Cilium Service Mesh 这类绕过用户态代理,性能和可观测性都更顺。不过别为了时髦硬上。小集群,先 API 网关加 OTel 也能活。
数据这块,最怕“每个服务一个数据库”被教条化。科研里,元数据、样本、文件、作业、结果之间关系复杂。硬拆库,跨服务事务能把你逼疯。我的建议:在线事务用 PostgreSQL 按 schema 隔离,重数据放对象存储,血缘和元数据用独立服务管。需要跨服务一致性,上 Saga 或 Outbox,别搞两阶段提交硬扛。对象存储用 S3 兼容接口,版本控制打开,配合内容寻址。这样复现实验时,镜像 digest + 数据版本 + 代码 commit,三件套齐活。
算力调度是科研微服务的命门。K8s 原生调度 GPU 不够细,多租户、拓扑感知、Gang Scheduling 得靠 Volcano、Kueue 这类批调度器。在线推理服务用 Triton、vLLM,离线批处理用 Argo Workflows 或 Nextflow。别把两种负载塞进同一个微服务。一个要低延迟,一个要吞吐,打架。
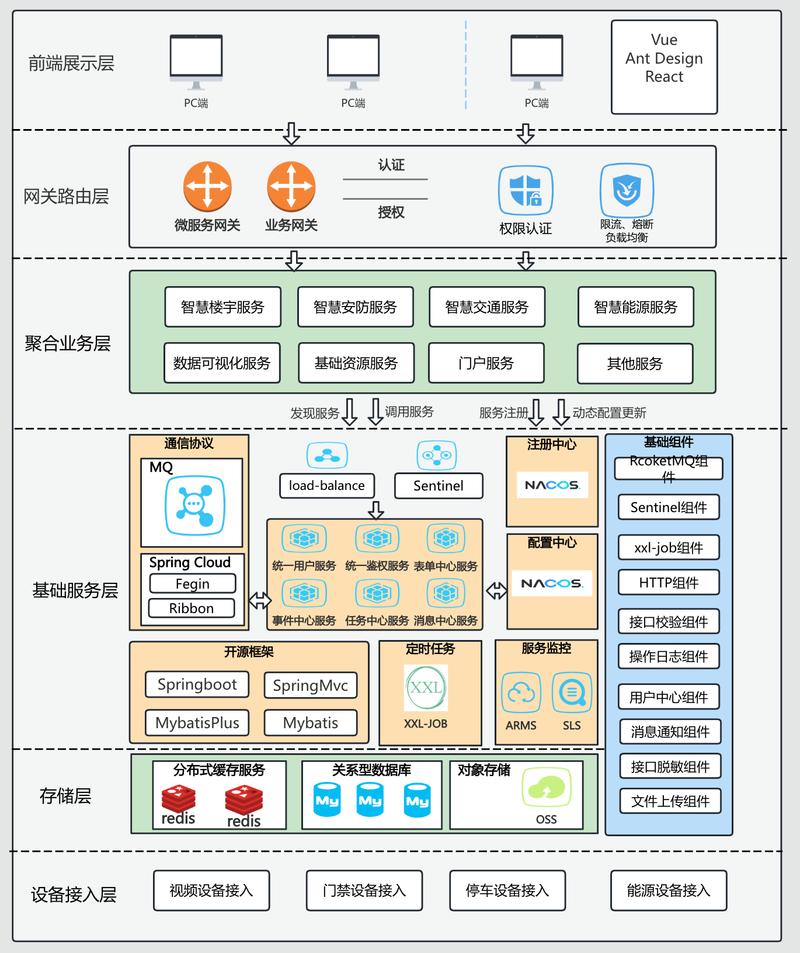 科研计算平台微服务GPU调度与数据血缘追踪架构图
别把微服务做成分布式单体:治理和组织的现实打法
微服务架构设计最讽刺的地方在于:拆服务容易,管契约难。接口一改,下游全炸。所以要有 API 网关、版本策略、契约测试。Pact 这类工具能提前抓不兼容。CI/CD 走 GitOps,Argo CD 拉配置,镜像签名,SBOM 生成。别小看这些,科研软件被供应链攻击,哭都来不及。
可观测性必须前置。不是等出事才装 Prometheus。OpenTelemetry 统一埋点,trace、metrics、logs 三路合一。链路追踪能告诉你:这次比对慢,是调度排队,还是对象存储限流,还是某个 Python 服务 GC 抖动。先有可观测性,再谈拆分。否则你只是把单体黑盒切成一堆黑盒。
组织上,平台工程越来越重要。内部开发者平台把 K8s、流水线、密钥、配额封装成自助服务。Backstage 做门户,Crossplane 管云资源。科研机构 IT 人手少,更要把重复劳动平台化。不然每个课题组都自己搭一套,最后变成微服务泥潭。对了,成本也要看。服务数量翻倍,账单不一定线性,但值班电话肯定线性。
一个可落地的科研微服务架构设计参考
 一个可落地的科研微服务架构设计参考
假设你要搭一个多组学分析平台。可以这么切:
接入层:API 网关 + OIDC 认证 + 配额限流。所有外部请求从这里进。
编排层:Temporal 或 Argo Workflows 管长流程。样本进、任务出,状态可查,失败可重试。
计算服务:CPU 池和 GPU 池分开。每个工具容器化,镜像 digest 固定。输入输出走对象存储,别在服务间传大文件。
数据服务:元数据服务、血缘服务、对象存储网关。血缘记录“谁在什么时候用哪个版本生了什么”。
AI 服务:模型推理独立部署,vLLM 或 Triton。模型版本、权重哈希、推理参数都入库。
可观测与治理:OTel Collector、Prometheus、Grafana、Jaeger。服务网格可以先不上,但 mTLS 和网络策略要有。
迁移策略呢?绞杀者模式。新功能做成微服务,老单体慢慢掏空。别搞大爆炸重写。我见过太多团队重写两年,最后原地解散。科研等不起。
老周后来把单体拆成七个服务,队列不堵了。可月底账单涨了 40%。他问我值不值。我说:看产出。如果一周能多跑两轮实验,多投一篇论文,那就值。如果只是架构图好看,不值。微服务架构设计不是银弹。先问数据边界,再问团队边界,最后才是技术边界。嗯,就这样。