路由表说谎的那个凌晨:网络强国技术保障的几根硬骨头
手机在床头柜上震。
凌晨两点十七分,值班群里蹦出一行字:某省递归解析成功率掉了三成,起来看看。
我光脚踩在地板上开电脑。第一反应是被人打满了——QPS 冲顶,谁在刷。抓包一看,不是。是应答变慢了,慢得诡异。60 毫秒,120,300。像是有人在中途把信封拆开、又原样粘回去。
那天最后定位到一台老设备的时钟飘了。对,就是时钟。跟域名、跟带宽、跟防火墙策略八竿子打不着的那个东西。
这事我记了很久。它特别能说明一个道理:所谓网络强国技术保障,很多时候不在那些被反复讲的地方,而在你从来没想过去看一眼的角落。
互联网没有总调度台,它靠互相喊话
 互联网没有总调度台,它靠互相喊话
先聊路由。因为它才是那个凌晨真正的凶手。
很多人以为互联网有个中枢,像铁路调度中心,谁去哪儿都听指挥。没有的。它更像一群人在漆黑的操场上互相喊:我这儿能到 1.2.3.0 这一段,走我这儿近。旁边的听见了,转个头再喊给别人。
这套喊话的协议叫 BGP。负责喊话的这些“人”,叫自治系统,业内简称 AS,全球几万个。规模不小吧?但规则糙得吓人——我默认你说的是真的。你喊“这个网段归我”,我就记下来,然后转发给邻居。中间没有任何身份核验。
这儿得分开两件事:一个是数据面,就是马路上跑的车;一个是控制面,是红绿灯和路牌。你车再好、路再宽,路牌被人半夜换掉,整条路就直接通向沟里。
2008 年那次事故就是这么来的。某国一家运营商本来想在国内屏蔽一个视频网站,结果手一滑,把“我这儿离那个网站最近”这句话广播了出去。全球流量哗地灌进来,那边扛不住,外面的人也就登不上了。折腾了几个小时才收场。
那是十几年前。后来呢?后来还是能出。某家社交巨头全球瘫掉六个小时,根子也在控制面——不是服务器炸了,是告诉全世界“怎么找到我”的那条路,被自己人撤了。
车没坏,路牌没了。
光“通”不够,还得“信得过”
所以技术保障这活儿,其实分两层。
一层是通。带宽够不够、冗余有没有、光缆被挖断之后多久能倒换。这是大家最熟的,也最容易考核,买设备堆资源就行。
另一层是信。你查到的东西是不是真的,你连上的对端是不是它自称的那个,你收到的包有没有被人半路摸过。这一层不出事的时候完全无感,一出事就是塌方式。
路由这块,业界给的解药叫 RPKI。说白了一句话:给网段发身份证。谁合法持有哪段地址,提前在体系里登记一份声明,别人收到路由广播时回头一比对,对不上就丢掉。
听起来挺朴素,落地却磨了很多年。全球部署到现在也没到“人人都用”的程度,原因不复杂——
一是链子太长。发证机构、登记库、缓存服务器、路由器上的校验模块,任何一环卡住,全网跟着抖。
二是误伤的代价比被攻击还大。校验规则配错一点,合法的前缀被当成假的丢掉,那边就直接从互联网上消失了。这种事真发生过,不止一次。
所以你看,安全这东西往往不是“加个锁”那么简单,它是在给一个已经跑起来的庞然大物动手术,还得保证它别停。
 BGP路由RPKI源验证部署架构示意图
域名那边也类似。DNSSEC 解决的问题是“我收到的解析结果有没有被人改过”,原理是给每条记录签名。加密的 DNS 传输解决的是“中间那个环节能不能看见我在查什么”。
但这两样都有代价。签名意味着响应包体积变大,超了 UDP 的限制就得走 TCP,吞吐和时延都受影响。加密呢,运维人员看不见内容了,可故障排查偏偏就靠看内容。安全和可观测,天生有点别扭。
没有免费的安全。这句话我想说三遍。
时间这根柱子,没人愿意承认它重要
绕回开头那台飘了的时钟。
为什么时钟一歪,解析就慢?因为很多协议里,时间戳是拿来判重、判序、判有效期的。时间对不上,缓存就不敢用,得回源头问;源头一忙,整个链路就慢下来。
再往大了说:证书有有效期,时间错了直接判无效;身份认证协议要求双方时钟偏差不能超过几分钟,超了就拒绝;交易系统的先后顺序要靠精确时间戳定;电网里那些同步相量测量装置,全靠统一时标才拼得出全网状态;5G 的上下行时隙切换,也是踩着时钟走的。
这些场景有个共同点——平时谁都不提,一旦断了就是系统性事故。
而它们的时间从哪来?大部分来自天上的导航卫星。问题是,卫星信号到地面已经很弱了,压制、欺骗都不算难事。你手机导航突然跳到几公里外,那还是小事;要是某个基础设施的授时接收机被喂了假信号,后果自己想。
所以正经的做法是叠好几层:卫星授时做常态,本地铯钟或铷钟做守时,地面光纤做时间传递,PTP 协议做局内分发。不把鸡蛋放在一个篮子里,这话放这儿特别对。
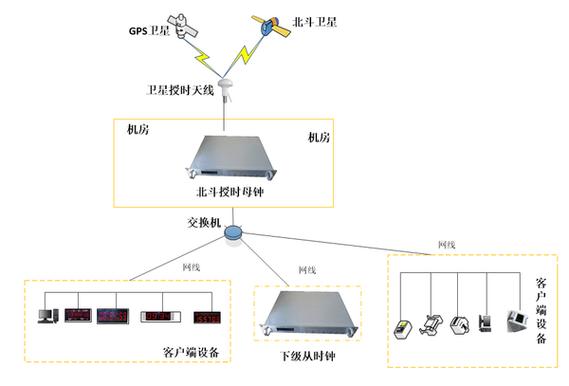 北斗卫星导航授时与地面铯原子钟时间同步系统图
“换了国产的”不等于安全,这事得说清楚
我见过不少项目,把国产化当成安全工作的终点。设备换成自家的了,评审过了,散会。
这不太成立。
先说硬件。一台交换机拆开,交换芯片、光模块、PHY、电源管理芯片,来源可能五湖四海。整机贴谁的标签,和里面每一颗料来自哪儿,是两码事。
再说软件。现在这套体系是层层叠出来的——操作系统、运行时、几十上百个开源依赖。任何一个被投毒,你在最上层做多少加固都白搭。所以业界才推 SBOM,也就是软件物料清单,把“这台设备里到底装了哪些组件、什么版本”列清楚。听着繁琐,但真出事的时候,你能不能在半小时内回答“我们有多少台设备用了这个有问题的库”,差别巨大。
还有固件。带外管理口、基板管理控制器,这些小东西权限高、关注少,是典型的盲区。它们平时不参与业务,可一旦被控,你上面所有的安全策略都成了摆设。
顺便说一句,合规也不等于安全。等保测评是把底线画出来,告诉你哪些不能不做。及格线不等于天花板——真攻击你的人,从来不看你的测评报告。
方案很漂亮,为什么总落不了地
这几年我参与过几次演练,最深的感受是:技术方案本身往往不难,难的是它得嵌进一个已经跑着的复杂系统里,还要有人在深夜三点接得住。
举几个具体的别扭之处。
一是成本与收益不同步。安全投入的回报是“没出事”,这是种很难写进汇报的东西。而带宽扩容、机房翻新,立竿见影。预算永远是有限的,天平往哪边倒,不用我说。
二是分布式系统的连锁反应。你以为改的是自己家的一台路由器,实际上可能影响几百个下游。所以变更管理、灰度发布、回滚预案,这些看着不酷的流程,才是真正的保命绳。
三是人的问题最难治。凌晨两点半,一个人迷迷糊糊敲错一行配置,能让整片区域掉线。技术手段能拦住一部分,剩下的靠演练、靠肌肉记忆、靠有人愿意再核对一遍。
还有个常被忽略的:冗余不等于可靠。两条光缆走同一个管道井,一条被挖断,另一条也悬。两台设备接同一个电源,一个空开跳了,两台一起哑。这种“伪冗余”在现实里多得数不清,只有真断一次才知道。
那怎么办?我的看法是别追求一步到位。先把看得见的短板补上——监控告警、变更流程、关键链路的地理分离、授时的备份源。再往深里做协议层面的加固,做供应链的盘点。
顺序错了,容易花钱买心安。
最后说点实在的
 最后说点实在的
网络强国技术保障这个词,听着宏大。但你把它拆开,落到地上,其实就是一堆很具体的事:
一条路由广播有没有人核验;一条解析记录有没有签名;一台设备的时钟准不准;一份组件清单全不全;一条光缆是不是真的走了另一条路;以及——半夜爬起来的那个人,手里有没有一份写得清楚的预案。
这些东西没有一样能靠买买买解决,也没有一样能靠一次演练验收完。它们是日复一日磨出来的,是监控曲线上那条贴着基线的平稳,是没有人打电话的安静夜晚。
我们值班的人有个私下的说法:最好的工作成果,就是什么都不知道。
用户刷不出页面,会骂。用户顺顺利利刷出页面,没人会夸。可正是这堆看不见的、枯燥的、偶尔让人懊恼到拍桌子的活儿,撑着一整个网络在跑。
至于我那张凌晨两点的截图,现在还留在手机里。不是为了怀旧,是提醒自己——越是底座的东西,越没人替你看一眼。
得自己看。