看不见的预警:状态监测技术如何改写工业运维逻辑
设备坏了再修。
到点不管好坏拆了修。
现在多了一种选择:在故障萌芽的时候就揪出来。
从事后抢修到预判故障的底层逻辑变化
早年国内工业领域的运维逻辑,核心围绕两个模式转:故障维修和计划维修。前者是坏了才动,生产线停一天,损失可能抵得上十台设备的钱。后者是到固定周期就拆机检修,哪怕设备状态好好的,也要拆开检查,白白浪费工时和备件钱。
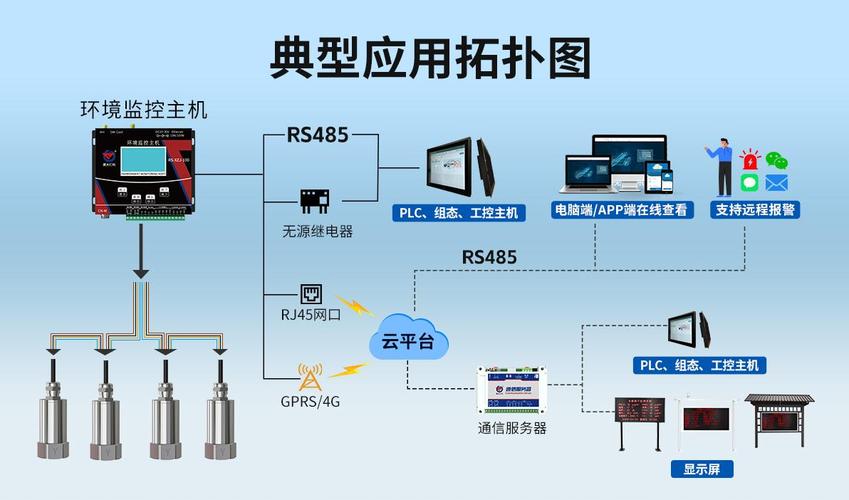 工业风机振动状态监测传感器布局图
大部分从业者容易把它和普通工业数据采集混为一谈。普通采集大多是存下数据,出了问题再调出来溯源。它的核心是动态比对:实时提取设备运行参数的特征,和预设的健康基线做对比,只要参数偏移超出允许范围,就触发预警。
别小看这个差异。去年接触过一个长三角的化工企业,花了上百万上了整套系统,投产半年还是出了泵轴断裂的事故,停产三天损失过千万。查原因才发现,乙方做方案的时候,直接拿设备厂商给的空载参数当健康基线,忽略了这家工厂常年满负荷运行,本身的基线就比空载参数高出30%。早期微小偏移根本触发不了报警,等偏移大到触发阈值,已经来不及了。
好多做方案的不会说这个。只说能预警能降本,闭口不谈基线要根据每台设备的实际运行场景调整。说白了,就是拿通用方案套所有场景,不出事才怪。
当下落地最难的三道坎
第一个坎,是工业现场的信噪比太低。厂子里电机转、焊机焊、变频柜随处都是,电磁干扰、机械噪音混在一起,你测到的振动信号里,一大半都是没用的噪音。早期故障的特征就像大海里的一根针,捞不出来,预警就是空谈。
现在不少吹得神乎其神的AI模型,都是拿实验室里干净的故障样本训出来的,放到真实现场,噪音一盖,准确率直接掉一半都不止。
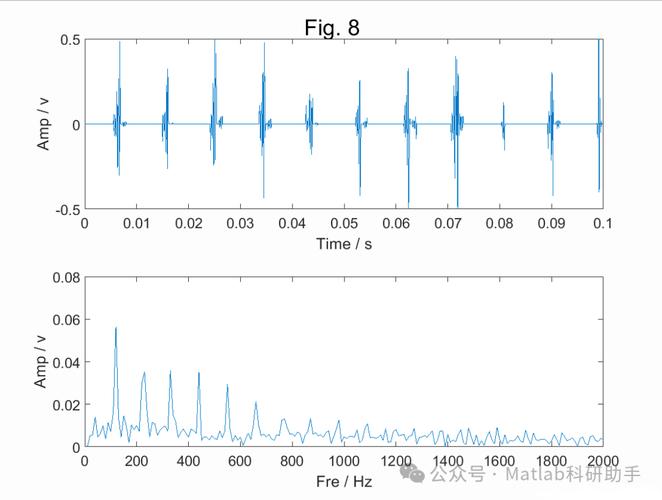 工业电机滚动轴承早期故障特征频谱图
第二个坎,是罕见故障的样本缺口。大型核心设备一辈子都未必出一次主轴断裂、定子烧毁这种大故障,哪来的足够样本训练模型?无监督学习现在还不成熟,生成模型造出来的假样本,和真实故障的特征差着十万八千里,根本用不了。
第三个坎,是一线的信任壁垒。干了二三十年的老运维,摸一摸外壳就知道震得对不对,听一听声音就晓得哪里不对,你给他一个屏幕上飘的红箭头,他凭啥信?说实话,这也不能全怪人家固执。市面上大部分系统误报率能到七成以上,十次报警七次是错的,天天喊狼来了,真狼来了谁当回事?好多工厂花大价钱上了系统,最后还是放着落灰,继续靠老师傅摸岗,就是这个原因。
应用边界在哪,不是所有设备都适合
 应用边界在哪,不是所有设备都适合
现在行业里有种风气,好像什么设备都要往上套。其实哪有这么神奇。什么样的设备值得上?核心就是一句话:停机损失远高于部署成本。比如电厂的汽轮机组、化工的连续反应釜、风电的风机叶片,停一天损失几十万,部署一套系统才十几万,当然划算。
那什么样的不值得?工厂角落备用的小型电机,坏了换一个才八百块,你给它装一套传感器加网关就要三千块,就算提前三天预警,也省不下钱,纯纯的浪费。很多做推广的不会说这个边界,只算能省多少钱,不算花了多少钱。
现在能看到的趋势,是往轻量化走。不用给每台设备额外装一堆传感器,直接挖工厂原有PLC系统里已经采集到的电流、温度、压力数据,提取故障特征就能做预警,成本能降到原来的十分之一,中小工厂也用得起。
但风险也不能不提。所有运行数据都传到云端,核心设备的运行参数就是工厂的核心机密,一旦泄露,损失不可估量。还有网络安全风险,如果黑客篡改了报警阈值,该报警的时候不报警,很容易引发重大安全事故。这些都是现在没人提,但未来必须解决的问题。
还有一点必须说透,它只是个预警工具,不是决策工具。系统报警只是告诉你这个位置可能有异常,要不要停机、什么时候停,还是要结合生产计划、备件库存、订单交付统筹安排,不能系统一报警就直接拉闸,那造成的损失,谁来承担?
这个领域还在爬坡,没有万能方案。每台设备的工况不一样,每一家工厂的需求不一样,能落地的都是磨出来的,不是拿通用方案拼出来的。