破解联邦学习中的非独立同分布:为什么它是行业落地最大拦路虎
很多人吹联邦学习是隐私计算的未来,能打破数据孤岛,我每次都想问一句:非独立同分布的坑,你填上了吗?
实话讲,现在90%公开的联邦学习Demo效果都好看,一到真实场景上线,准确率哗哗往下掉,十个有九个栽在这上面。
什么是联邦学习里的非独立同分布(Non-IID)?说白了就是,参与训练的每个客户端手里的数据,长的都不一样。
联邦学习的初衷是大家一起训模型,又不用把自己的数据交出来,保护隐私。可理想很丰满,现实是,没人能要求各个机构的数据都按同一个概率分布出。
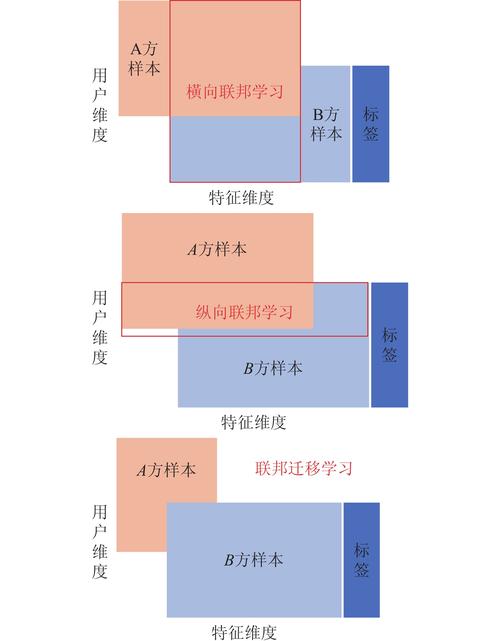 联邦学习独立同分布与非独立同分布数据对比图
更坑的是非独立同分布还分好几种,标签偏移、特征偏移、概念偏移,每一种坑长得都不一样,哪有一种万能药能通治?
说实话,我见过不少创业公司做项目,客户提了非独立同分布的问题,他们拿个改了正则的老方法凑数,上线效果不行,就怪客户数据质量差,脸都不要了。
不过话说回来,这几年业界也摸出不少靠谱的路子,不是完全没法解。
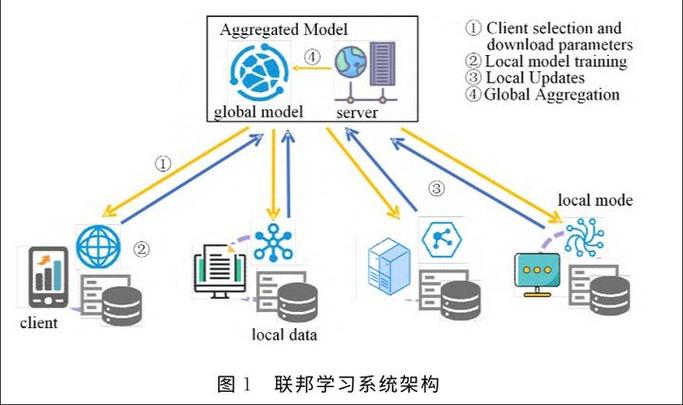 个性化联邦学习处理非独立同分布结构图
这三个方向各有优劣,个性化联邦改模型最小,最容易落地;梯度修正几乎不用改原有流程,适合现成的项目;聚类适合客户端多的场景,比如几百家中小机构联合建模的情况。
去年开始联邦大模型火了之后,这个方向又有新进展,大家都在把LoRA和个性化联邦结合,每个客户端训自己的LoRA适配器,既不用动大模型主干,又能适配本地Non-IID数据,效果还不错,最近落地项目用的越来越多。
 落地时一定要避开的几个坑
我接触过不少创业团队,拿着论文的方法就敢去给客户做项目,最后踩坑踩得稀烂,说几个最常见的。
第一个坑,拿模拟非IID当真实非IID。很多论文里的实验,是把一份IID数据集切分成几块,故意造标签不均匀,就说这是非IID。可真实场景的Non-IID,不光是标签不均匀,还有特征分布不一样,概念漂移,每个客户端数据量差几百倍,还有长尾,模拟出来的效果和真实场景差十万八千里。
之前有个团队给医院做糖尿病预测联邦模型,公开数据集模拟出来AUC0.91,一接入三家真实医院的数据,直接掉到0.76,就是这个原因。
第二个坑,为了效果牺牲通信效率。很多方法为了对齐分布,要求每个客户端每次传很多额外参数,联邦学习很多场景是跨机构跨网通信,带宽本来就卡,你加这么多参数,训练一次要跑一天,客户根本用不起。
第三个坑,过度适配反而掉效果。有些团队为了迁就Non-IID,给每个客户端做过度个性化,最后全局模型根本没吃到多机构数据的红利,效果还不如单个客户端自己训,完全违背了联邦学习的初衷。
现在联邦学习走了这么多年,从概念热落到落地挣钱,核心要解决的问题早就不是隐私保护够不够安全了——安全方案已经成熟了,现在最大的瓶颈就是效果,而效果问题,一半以上来自联邦学习中的非独立同分布。
谁能把这个问题真的解决好,适配真实场景的五花八门的数据分布,谁就能在接下来的隐私计算赛道抢到肉吃。不然吹再多概念,也只能拿拿项目经费,做不了能挣钱的落地产品。
为什么非独立同分布能卡死整个模型?
联邦学习的核心步骤是「本地训模型,上传梯度,聚合成全局模型」。这个步骤从根上就依赖一个假设:所有本地数据都是独立同分布的,梯度方向都指向全局最优点。 一旦数据是非独立同分布,每个客户端算出来的梯度方向,全歪了。 举个最常见的落地场景:全国十家银行联合训反欺诈模型。北方银行的欺诈案例大多是网贷套现,南方银行的欺诈多是跨境盗刷,标签分布差十万八千里,算出来的梯度方向能对吗?聚合出来的全局模型,放到任何一家银行用,效果都不如银行自己训的小模型,这不搞笑吗? 很多实验室拿论文数据做实验,故意把数据切成IID的分块,跑出来准确率95%吹上天,真到落地,碰到真实的Non-IID数据,准确率直接掉20个点都不稀奇。联邦学习独立同分布与非独立同分布数据对比图
更坑的是非独立同分布还分好几种,标签偏移、特征偏移、概念偏移,每一种坑长得都不一样,哪有一种万能药能通治?
说实话,我见过不少创业公司做项目,客户提了非独立同分布的问题,他们拿个改了正则的老方法凑数,上线效果不行,就怪客户数据质量差,脸都不要了。
不过话说回来,这几年业界也摸出不少靠谱的路子,不是完全没法解。
现在主流的解决思路都有哪些?
我整理了现在落地最多的三个方向,个个都是踩坑踩出来的经验。 第一个方向是个性化联邦,说白了就是放弃「所有客户端用同一个全局模型」的执念。共享底层的通用特征提取主干,每个客户端自己训一个适配本地数据的输出头。全局聚合只聚主干,不聚头,这样既吃到了多机构的数据红利,又能适配每个机构自己的数据分布。 这个思路现在落地最多,不管是金融还是医疗,用了之后准确率基本都能拉回来10个点左右,性价比很高。 第二个方向是梯度修正,就是在聚合梯度的时候,不直接平均加权,按照每个客户端数据分布和全局分布的差异,调整权重。分布偏差大的梯度,给小权重;偏差小的给大权重,避免歪梯度把整个全局模型带偏。 还有人用对抗训练生成对齐分布的本地数据,相当于给数据少分布偏的客户端补数据,效果也不错,就是计算量会大一点。 第三个方向是客户端聚类,把数据分布差不多的客户端聚成一组,组内先聚合,再聚合成全局模型,避免差异太大的梯度互相干扰。个性化联邦学习处理非独立同分布结构图
这三个方向各有优劣,个性化联邦改模型最小,最容易落地;梯度修正几乎不用改原有流程,适合现成的项目;聚类适合客户端多的场景,比如几百家中小机构联合建模的情况。
去年开始联邦大模型火了之后,这个方向又有新进展,大家都在把LoRA和个性化联邦结合,每个客户端训自己的LoRA适配器,既不用动大模型主干,又能适配本地Non-IID数据,效果还不错,最近落地项目用的越来越多。
落地时一定要避开的几个坑
落地时一定要避开的几个坑
我接触过不少创业团队,拿着论文的方法就敢去给客户做项目,最后踩坑踩得稀烂,说几个最常见的。
第一个坑,拿模拟非IID当真实非IID。很多论文里的实验,是把一份IID数据集切分成几块,故意造标签不均匀,就说这是非IID。可真实场景的Non-IID,不光是标签不均匀,还有特征分布不一样,概念漂移,每个客户端数据量差几百倍,还有长尾,模拟出来的效果和真实场景差十万八千里。
之前有个团队给医院做糖尿病预测联邦模型,公开数据集模拟出来AUC0.91,一接入三家真实医院的数据,直接掉到0.76,就是这个原因。
第二个坑,为了效果牺牲通信效率。很多方法为了对齐分布,要求每个客户端每次传很多额外参数,联邦学习很多场景是跨机构跨网通信,带宽本来就卡,你加这么多参数,训练一次要跑一天,客户根本用不起。
第三个坑,过度适配反而掉效果。有些团队为了迁就Non-IID,给每个客户端做过度个性化,最后全局模型根本没吃到多机构数据的红利,效果还不如单个客户端自己训,完全违背了联邦学习的初衷。
现在联邦学习走了这么多年,从概念热落到落地挣钱,核心要解决的问题早就不是隐私保护够不够安全了——安全方案已经成熟了,现在最大的瓶颈就是效果,而效果问题,一半以上来自联邦学习中的非独立同分布。
谁能把这个问题真的解决好,适配真实场景的五花八门的数据分布,谁就能在接下来的隐私计算赛道抢到肉吃。不然吹再多概念,也只能拿拿项目经费,做不了能挣钱的落地产品。