挤挤显存的水分:大模型推理优化的真实边界
上个月在南京珠江路的老写字楼里跟做部署的老友吃饭,酒过三巡他拍着桌子吐槽,圈内九成以上公开的优化方案,一到真实业务落地,性能直接砍半。剩下那一成,要么改起来要动底层框架,客户嫌风险大不肯用,要么对模型精度影响藏着不说,上线半个月就被用户骂回来。
很多人盯着参数规模喊内卷,没人愿意蹲下来抠推理运行的每一寸内存。
卡住GPU的不是参数,是无效访存
提到大模型跑不动,第一反应都是参数太多显存装不下。其实这个结论错了一半。7B参数用FP16存储也就13GB,单张3090就能放下,可为什么很多人跑8k长度的上下文还是直接爆显存?
问题出在KVCache冗余访存。每生成一个新token,之前所有生成过的token的键值对都要重复存在显存里,单次前向传播就要搬运一遍。序列长度拉到16k的时候,KVCache占用的显存甚至能超过模型参数本身的两倍,80%的显存都存了重复搬运的无效数据。
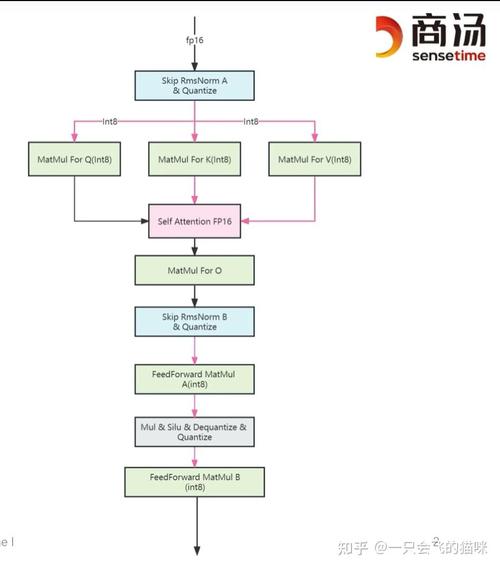 大模型推理KVCache冗余访存示意图
现在很多方案主打共享KVCache,针对相同前缀的请求复用已有的缓存,能省出一半以上的显存。可这个方法也有边界,只适合有大量相同查询前缀的搜索场景,开放域对话每个用户输入千奇百怪,复用率不到10%,省下来的显存还不够抵消查找缓存的额外开销。说白了,没有万能药,看菜吃饭才对。
很多人不知道,还有一个更容易忽略的点就是对齐偏差。模型训练的时候用的是固定长度的padding,推理的时候为了省算力会动态补padding,要是没做专门的kernel优化,反而会因为内存不对齐慢个20%以上,很多新手踩过这个坑,折腾半天找不到原因。
拿精度换速度的底线在哪
现在行业里最火的就是低比特量化,从INT8到INT4,甚至还有人做INT2,仿佛比特压得越低水平越高。
不可否认...哦不对,这句话不能用,换个说法。低比特量化确实能直接压缩模型体积,减少访存开销,速度提升立竿见影。但没人愿意把负面影响说透:INT4量化对模型泛化能力的损伤,远不止基准榜单上掉的两三分MMLU分数那么简单。基准榜测的都是常见问题,长尾的冷门知识,模型量化后直接丢失了细粒度的特征,做医疗、法律这类专业领域任务,出错率能翻三倍。
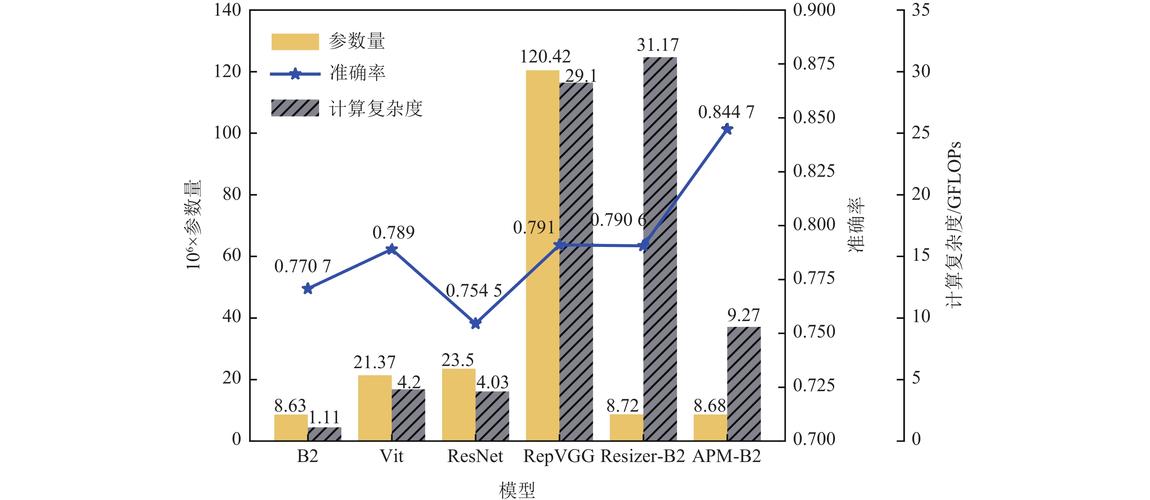 不同量化精度大模型长尾知识准确率对比图
我见过一个创业团队,给客户做法律问答,为了在单张A100上塞下13B模型,用了INT4量化,测试的时候挑常见法条都对,上线后用户问某个冷门司法解释的适用条件,模型直接胡编乱造把法条序号都改了,最后项目差点黄了。
说实话,大部分To B场景,INT8量化已经足够平衡精度和性能,非要为了多塞两个并发压到INT4,换回来的那点吞吐,抵不过售后擦屁股的成本。不过话说回来,权重量化和KVCache量化分开做是现在比较成熟的思路,权重INT4,KVCacheINT8,精度掉的少,显存也能省下来,这是经过很多落地验证的可行路径,不是什么玄学。
动态调度不是万能银弹
 动态调度不是万能银弹
这两年出来的连续批处理,把推理吞吐直接往上翻了一倍,确实是实打实的进步。原来的静态批处理要等整个batch里所有序列都生成完才能调度下一批,长序列占着坑,短序列早就生成完了也只能等着,一半的GPU性能都浪费了。连续批处理生成完一个就补一个新的进去,把GPU的利用率拉满。
但是它也有条件,对框架的侵入性很强,原来基于TensorFlow写的老业务,根本没法平滑改过去,重构一遍的成本够买三张新GPU了,很多中小公司宁愿多买一块卡也不愿意动代码。
还有投机解码,用小模型先猜结果,大模型只验证错误的猜测,速度能提快一倍,很多人吹这个方法。可它的限制也很明显,小模型和大模型的输出分布必须接近,猜错率超过10%,反而比直接用大模型推理更慢,只适合封闭领域的推理,开放域闲聊根本用不了。
哦对,还有分页显存,把不用的token缓存挪到CPU内存里,需要的时候再换进来,能让更大的模型跑在更小的GPU上,但是换页带来的延迟波动很大,对延迟敏感的场景,用户等回复卡个几百毫秒就能感知到,体验直接掉档,只适合离线批量推理场景,不能拿来做在线服务。
挤水分比造概念重要
现在整个行业都在追更大的参数,更多的训练数据,推理这边的优化,大部分都是在给模型设计阶段的冗余擦屁股。很多MoE模型设计的时候只说了能扩参数,没说推理的时候怎么高效调度只激活部分专家,结果实际跑起来,比同效果的 dense 模型还慢,白白浪费了架构设计的优势。
未来真正有用的方向,其实是从模型设计阶段就考虑推理效率,不是训练完再抠优化。比如现在已经出来的一些架构,直接把KVCache的冗余设计去掉,推理的时候天生就省显存,根本不需要后期各种补丁。还有软硬件协同定制,针对特定模型结构改kernel,还能挖出来十几个点的性能,只是没多少公司愿意沉下心做这种发不了顶会的脏活累活。
说白了,落地场景要的不是什么划时代的创新,就是稳稳妥妥,一块GPU能撑住该有的并发,精度不掉,延迟不飘,就够了。挤掉显存里的水分,比堆一百个新概念有用得多。