别等机房冒烟才想起填坑:靠谱的灾备技术方案到底该怎么搭
前阵子帮一个做生鲜电商的老朋友擦屁股。618大促当天,核心服务器硬盘全挂,之前找小作坊做的备份,存到同机房另一块硬盘里,一起烧了。整整三天没法接单,直接亏掉半年利润。
他说当时觉得灾备就是花冤枉钱,能用就行。这下好了,能用变成“没命”。
别被厂商忽悠:现在没有通用的灾备技术方案
很多外行以为,灾备不就是把数据拷一份存起来吗?哪有那么多讲究。
真不是。你做餐饮零售和做银行证券,需求能一样吗?你小公司十来个人和上市公司万人规模,成本承受力能一样吗?
现在市面上的方案,本质上就分两类,对应完全不同的场景。
一类是数据级灾备,说白了就是只给你存数据,服务器挂了,你得自己重新搭环境、重新配置,慢慢把数据导回去。恢复时间少则几小时多则一两天,成本很低,一年几千块就能搞定,适合中小公司的非核心业务,或者数据量极大的冷数据存储。
另一类是应用级灾备,更夸张点就是现在说的双活架构。主站点挂了,备用站点几秒就能切过去,用户根本感觉不到服务断了。RTO能做到秒级,RPO接近0,几乎不丢数据。但成本贵啊,相当于你要再搭一套一模一样的运行环境,带宽、存储、服务器全都翻倍,一年几十万上百万都是常态,只适合核心交易业务,比如电商大促、银行支付、在线医疗这种。
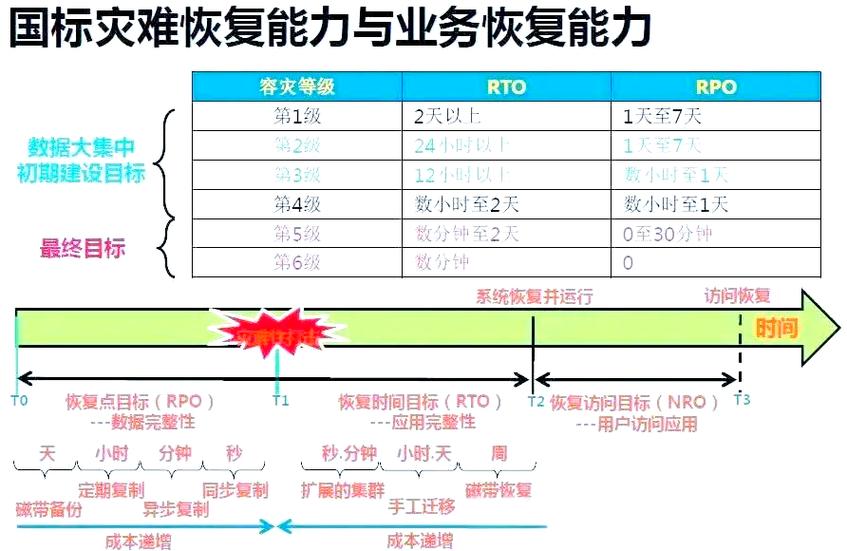 主流灾备技术方案RTO RPO对比表
说实话,我见过九成以上的中小公司,被厂商忽悠着买了最贵的双活方案,一年掏几十万养着,十年都用不上一次,纯纯交智商税。也见过不少大意的公司,图便宜买了冷备,真出事儿了,恢复三天,直接把公司拖死。
选方案第一步,先搞清楚你自己能接受:最多停服务几个小时?最多能丢多久的数据?对着指标选,别被概念忽悠。
云迁半道,大多数人的灾备技术方案都错了
这两年九成企业都在迁云,原来那套本地机房灾备的逻辑,早就不适用了。很多人以为,云厂商自带了多可用区、自动备份,我就不用再做灾备了对吧?
大错特错。
去年有个做在线教育的客户,把所有课程数据都存在阿里云的OSS上,开了多AZ冗余,就觉得万无一失了。结果运维新手误操作,把整个存储桶给删了,又没开版本控制,找云厂商,云厂商说我们只保基础设施,数据误删你自己负责,最后花了几十万找数据恢复公司,还是找不回三成付费课程,直接影响续报率。
现在主流的云原生灾备技术方案,其实核心就两个关键点。第一,你的备份不能和生产数据放在同一个云账号同一个区域,更不能给生产环境读写权限。不然勒索病毒打进来,连你备份一起加密,你哭都没地方哭。第二,K8s跑的容器业务,不能只备份数据,还要备份整个集群的配置、镜像、存储卷,不然你恢复了数据,服务起不来,还是白搭。
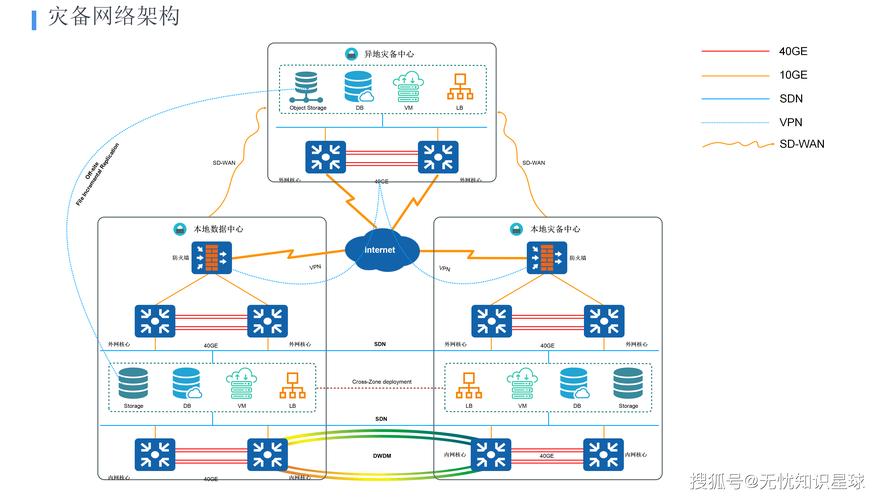 企业云原生灾备隔离架构示意图
不过话说回来,云原生灾备也不是越复杂越好。很多人做方案的时候,非要把所有数据都实时同步到灾备站点,一年下来带宽成本都能吓死你。其实完全可以做分层:核心交易数据做实时同步,非核心的用户上传内容做定时异步同步,冷数据直接存离线对象存储,成本直接降六成以上,完全不影响可用性。
做灾备技术方案,90%的人都会漏掉这三个细节
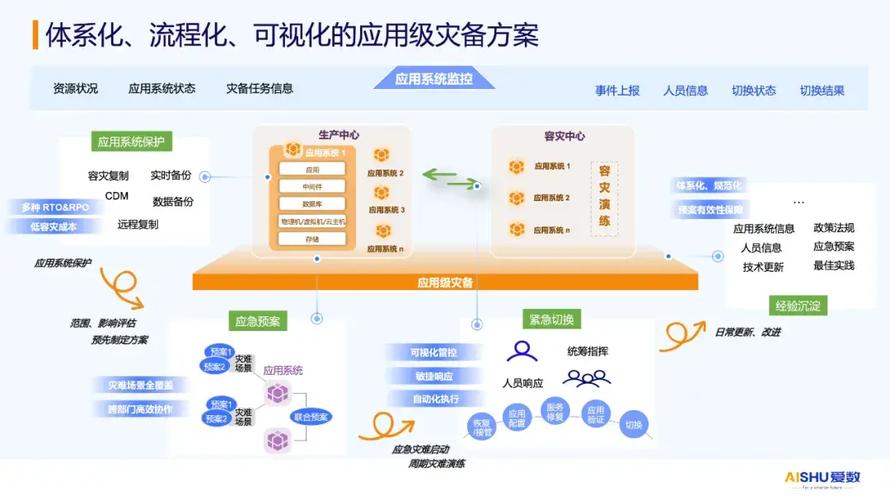 做灾备技术方案,90%的人都会漏掉这三个细节
我见过太多方案,写在PPT上完美无缺,真出事儿了全掉链子,问题大多出在细节上。
第一个,灾备演练不是走形式。我接触过的企业里,超过七成做了灾备之后,一年都不练一次。有的备份存了三五年,拿出来恢复才发现,介质坏了,同步中断了大半年没人知道,一半数据都丢了。还有的演练就是找几个人开个会走个过场,真切流量才发现,灾备站点带宽不够,承载不了峰值业务,切过去还是瘫。
我给客户做方案的时候都会要求,至少半年全量演练一次,小规模故障演练一季度一次。花不了几天时间,真出事儿了能救你命。
第二个,一定要留物理隔离的离线备份。现在勒索病毒太凶了,你本地备份、云上备份连网的,基本都逃不过,入侵之后第一件事就是给你加密所有连网的备份。你留一份离线的,每周更新一次,哪怕所有在线数据都被锁了,掏出离线备份就能恢复,最多丢一周数据,不至于整个公司被赎金绑架。
第三个,合规要求一定要提前嵌到方案里。金融、医疗、政务这些行业,要求数据必须存放在指定区域,还得留至少三年的历史记录,你做方案的时候不注意,把灾备存到境外,或者存到不合规的云厂商,被查到直接罚到破产,这锅谁背?
说实话,灾备这东西,本质上就是买个保险。你可能十年用不上一次,但只要用上一次,赚的就比你十年花的成本多得多。别等机房冒烟、数据全丢了,才想起自己的灾备技术方案,原来是个漏风的筛子。到那时候,真的晚了。