高效能计算平台:被低估的算力创新隐形底座
上个月去苏州参加一个算力峰会,跟一个做AI大模型训练的团队吃饭,他们吐槽了三个小时。什么?抢不到算力卡就算了。好不容易排到,存个训练数据要等半天,跑个 ablation 实验,平台卡半天出结果,半个月时间一半都在等。这不就是现在绝大多数科研团队、创业公司的现状吗?对吧?大家都在喊缺算力,但很多人没意识到,你手里已经有的算力,至少一半都被浪费了。浪费在哪里?烂在调度混乱、适配不好的旧集群里。能把闲置算力挖出来、把每一张卡的性能榨干的,才是真的高效能计算平台。
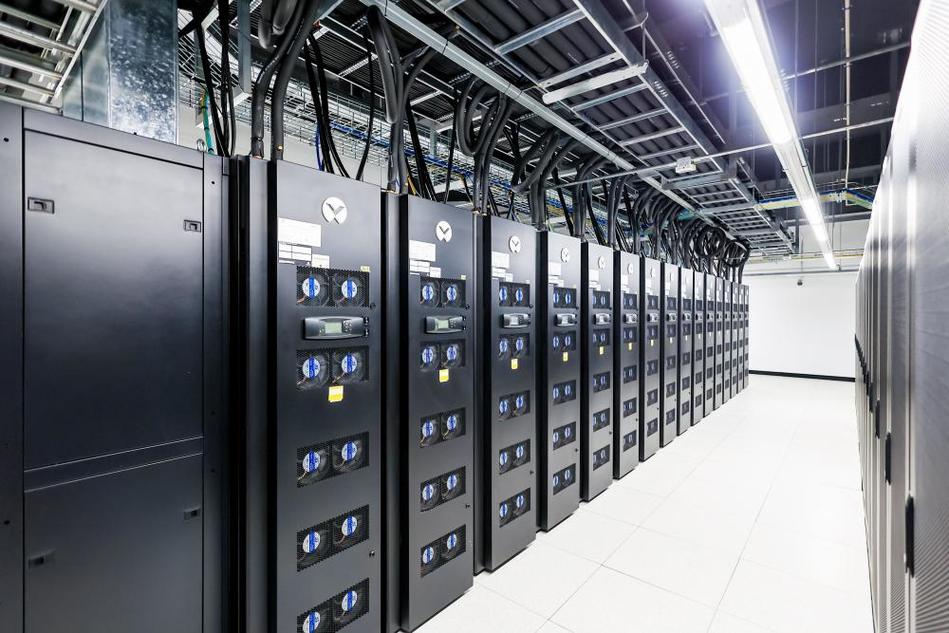 企业级高效能计算平台GPU集群部署实拍
高效能的核心,从来不是硬件数量,而是软硬件协同的系统优化。举个最直观的例子,现在训练千亿参数大模型,需要跨几十上百个节点通信,很多普通集群没有做网络拓扑优化,通信延迟就能吃掉一半的性能,100张卡跑出来的效果,还不如人家优化好的60张卡。你说亏不亏?高效能计算平台会提前做通信流水优化,把计算和通信重叠起来,还会根据任务类型自动调度就近的算力节点,能把整体有效算力拉到80%以上。说实话,现在全球GPU都缺成这样,把现有硬件的效能提一倍,不比再去抢一倍的硬件划算?
 生信科研人员用高效能计算平台分析蛋白质结构场景
不过话说回来,最让我惊喜的还是对国产异构芯片的适配能力。前两年很多团队换国产芯片,要改大半年代码,性能还上不去。现在成熟的高效能计算平台已经做好了全栈适配,不管你用NV的卡还是国产的GPU、NPU,平台统一调度,开发者几乎不用改代码就能直接跑,性能损失能控制在5%以内。这对想要自主可控的团队来说,真的是解决了大问题。还有小团队,现在十几个人的AI创业公司,不用自己花几个亿搭集群,直接租云上的高效能计算平台,按使用量付费,就能训出自己的行业大模型。放在三年前,谁敢想?对吧?
我上个月还碰到一个做天文观测的团队,他们每天接收到几P的观测数据,原来要花一个多月才能处理完一遍引力波观测数据,现在用定制化的高效能计算平台,一周就能跑完,已经发现了三个以前漏掉的疑似信号。这种速度提升,真的是直接推动科研进展,说它改写了科研节奏都不为过。
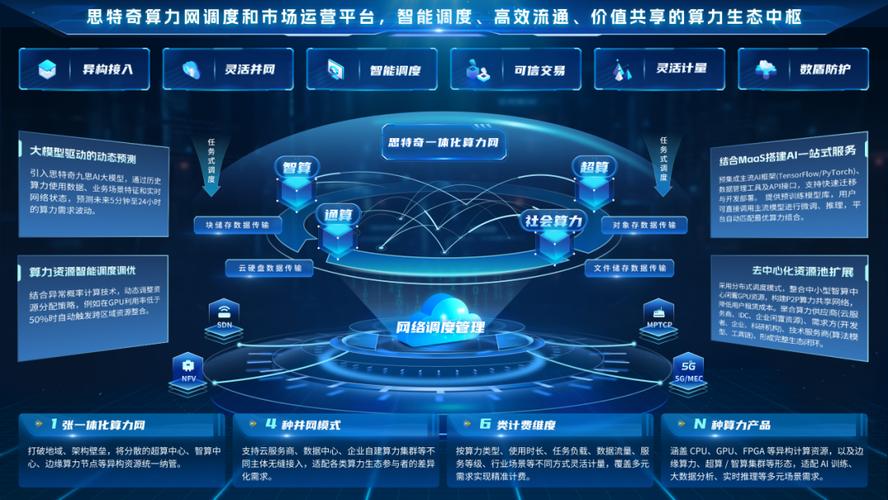 高效能计算平台的下一个增长点在哪
现在大模型往多模态走,参数越来越大,气候模拟、核物理模拟这些科研任务对算力的需求也在成倍涨,光靠堆硬件根本追不上需求。高效能计算平台接下来的空间还大得很。
第一个方向肯定是跟全国一体化算力网绑定,把东中西部分散的闲置算力,通过高效能平台统一调度。比如东部算力紧张,电价还贵,西部有很多靠绿电发的闲置算力,平台能自动把对延迟不敏感的训练任务调度过去,价格便宜一半,性能还不打折扣。现在甘肃、贵州的算力枢纽已经在试了,效果比很多人预想的好。
第二个方向就是领域定制化。现在很多平台都喊着“通用全能”,其实通用就意味着中庸,很多细分场景发挥不出最大性能。未来肯定会出现给生信做的、给大模型训练做的、给气候模拟做的定制化高效能平台,把每一分性能都榨出来。
还有就是绿色高效能,现在算力的碳排放已经占全球的2%左右了,再涨下去谁都扛不住。高效能计算平台通过优化调度、提高利用率,能把单位算力的能耗降30%以上,这个价值真的不比挖新矿小。
我见过很多科研人员,原来一半的工作时间不是在做实验写论文,是在排队等算力,是在修集群找bug。现在高效能计算平台把这些时间省出来,让他们把精力花在真正创新的地方。很多人现在只盯着新出了什么芯片,显卡涨了还是跌了,却忘了,把现有算力的潜力挖出来,才是当下解决算力荒最划算的路径。这不就是高效能计算平台真正的意义吗?
别把堆硬件等同于高效能计算平台
很多人对这个东西的误解太深了。以为拉一屋子H100,插满网线,就是高效能计算平台了?大错特错。我之前听某985高校计算中心的老师吐槽,学校花了四千万建集群,第一年的平均利用率不到18%。各个课题组抢资源,做大模型的占着几十张卡半年不挪窝,做小分子模拟的小项目排一个月都排不上,闲的时候过半硬件都在空载。说白了,就是没有好的平台调度,一堆硬件就是一堆废铁。企业级高效能计算平台GPU集群部署实拍
高效能的核心,从来不是硬件数量,而是软硬件协同的系统优化。举个最直观的例子,现在训练千亿参数大模型,需要跨几十上百个节点通信,很多普通集群没有做网络拓扑优化,通信延迟就能吃掉一半的性能,100张卡跑出来的效果,还不如人家优化好的60张卡。你说亏不亏?高效能计算平台会提前做通信流水优化,把计算和通信重叠起来,还会根据任务类型自动调度就近的算力节点,能把整体有效算力拉到80%以上。说实话,现在全球GPU都缺成这样,把现有硬件的效能提一倍,不比再去抢一倍的硬件划算?
现在的高效能计算平台,已经卷到了什么程度
放在五年前,高效能计算平台还是顶尖实验室和互联网大厂的专利,普通人碰都碰不到。现在不一样了,整个行业都卷出花了。不管是公有云厂商,还是国家队的算力枢纽,都在把这个东西往普惠了做。我之前跟国内某云的算力团队聊,他们给一家做药物研发的公司做过适配,原来跑一次分子动力学模拟,用普通集群要72小时,换了优化后的高效能计算平台,8个小时就出结果。成本还降了三分之一。这个速度对新药研发来说是什么概念?等于上市时间可能提前大半年,能省几个亿的成本。生信科研人员用高效能计算平台分析蛋白质结构场景
不过话说回来,最让我惊喜的还是对国产异构芯片的适配能力。前两年很多团队换国产芯片,要改大半年代码,性能还上不去。现在成熟的高效能计算平台已经做好了全栈适配,不管你用NV的卡还是国产的GPU、NPU,平台统一调度,开发者几乎不用改代码就能直接跑,性能损失能控制在5%以内。这对想要自主可控的团队来说,真的是解决了大问题。还有小团队,现在十几个人的AI创业公司,不用自己花几个亿搭集群,直接租云上的高效能计算平台,按使用量付费,就能训出自己的行业大模型。放在三年前,谁敢想?对吧?
我上个月还碰到一个做天文观测的团队,他们每天接收到几P的观测数据,原来要花一个多月才能处理完一遍引力波观测数据,现在用定制化的高效能计算平台,一周就能跑完,已经发现了三个以前漏掉的疑似信号。这种速度提升,真的是直接推动科研进展,说它改写了科研节奏都不为过。
高效能计算平台的下一个增长点在哪
高效能计算平台的下一个增长点在哪
现在大模型往多模态走,参数越来越大,气候模拟、核物理模拟这些科研任务对算力的需求也在成倍涨,光靠堆硬件根本追不上需求。高效能计算平台接下来的空间还大得很。
第一个方向肯定是跟全国一体化算力网绑定,把东中西部分散的闲置算力,通过高效能平台统一调度。比如东部算力紧张,电价还贵,西部有很多靠绿电发的闲置算力,平台能自动把对延迟不敏感的训练任务调度过去,价格便宜一半,性能还不打折扣。现在甘肃、贵州的算力枢纽已经在试了,效果比很多人预想的好。
第二个方向就是领域定制化。现在很多平台都喊着“通用全能”,其实通用就意味着中庸,很多细分场景发挥不出最大性能。未来肯定会出现给生信做的、给大模型训练做的、给气候模拟做的定制化高效能平台,把每一分性能都榨出来。
还有就是绿色高效能,现在算力的碳排放已经占全球的2%左右了,再涨下去谁都扛不住。高效能计算平台通过优化调度、提高利用率,能把单位算力的能耗降30%以上,这个价值真的不比挖新矿小。
我见过很多科研人员,原来一半的工作时间不是在做实验写论文,是在排队等算力,是在修集群找bug。现在高效能计算平台把这些时间省出来,让他们把精力花在真正创新的地方。很多人现在只盯着新出了什么芯片,显卡涨了还是跌了,却忘了,把现有算力的潜力挖出来,才是当下解决算力荒最划算的路径。这不就是高效能计算平台真正的意义吗?