大模型总瞎编:检索增强生成到底解决了什么问题
上周跟客户对接内部知识库项目,出事了。客户老板现场提问,去年新上线的供应商准入流程是什么,之前调的大模型张嘴就来,说的还是五年前旧版本,把老板说得脸黑得像锅底。
这事儿不是个例。但凡你想把大模型用到企业内部,第一个绕不开的问题就是幻觉。大模型的知识都锁在训练好的参数里,训练结束那一刻,知识就已经过期了。要是碰上新出的政策、公司内部的文档,没见过的内容,它只能靠着概率拼单词,拼着拼着就成了瞎编。
这时候大家最先想到的方案,就是检索增强生成,也就是圈内常说的RAG。说白了就是给大模型装个外接的活知识库,让它回答之前先翻书,找对了内容再说话。
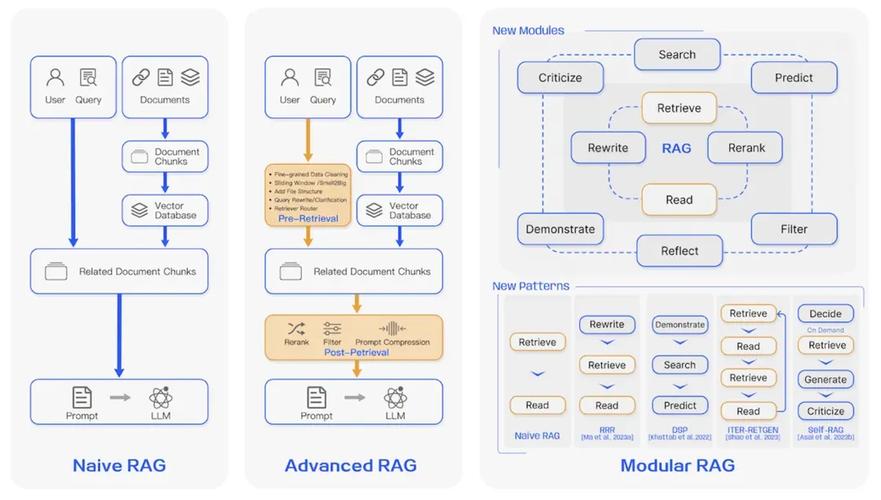 原生大模型与RAG生成效果对比图
说白了,原生大模型的知识是死的,改一次成本极高。而企业需要的知识是活的,天天都在变,这个矛盾原生大模型解决不了。检索增强生成的核心优势,就是不用改大模型本身的参数,就能随时给它更新知识,成本还低,刚好戳中了这个痛点。
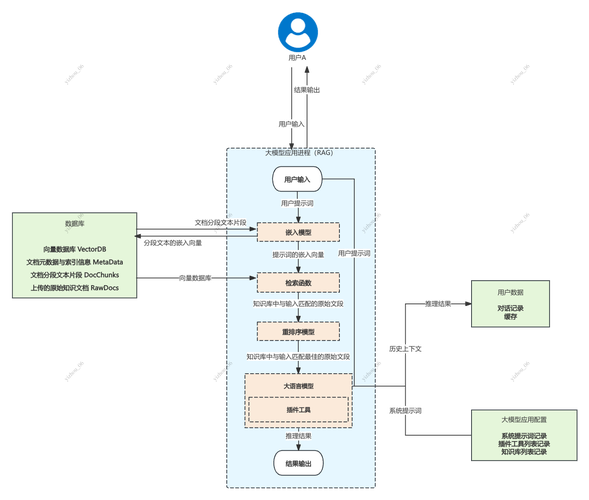 检索增强生成RAG三步工作流程图
不过话说回来,很多人刚接触RAG,总觉得这是最近两年才出来的天顶星技术。其实真不是,检索这玩意儿,搜索引擎做了二十年了,语义向量也搞了十多年,只不过之前没有大模型能把检索到的零散内容整合成流畅的自然回答,现在刚好把两者拼在一起,解决了大模型瞎编的痛点而已。别吹得太神。
 用检索增强生成,最容易踩哪些隐形坑?
我经手过五六个RAG落地项目,见过的坑比你吃过的米饭还多。说几个最常见的,给大家提个醒。
第一个坑,文本切分太随便。切得太长,大模型prompt放不下,就算放得下,一堆无关内容混进去,大模型找不到重点。切得太碎,好好一段完整的内容被切成好几段,语义都砍没了。比如说员工手册里写“加班超过三小时可调换调休,加班超过八小时按双倍工资计算”,你一刀切在中间,检索出来只有前半句,大模型自然就会答错。
第二个坑,召回准确率不够。切分对了,检索出来的内容不对,也是白搭。很多人图省事,用了免费开源的通用向量模型,语义匹配差十万八千里。用户问“试用期离职需要提前几天打招呼”,结果检索出来一堆正式员工离职的流程,根本没提试用期的事,你让大模型怎么答对?现在很多人吹RAG效果好,其实大部分功夫都花在优化召回准确率上,这才是核心,不是什么花里胡哨的架构。
第三个坑,也是最大的误区:以为RAG能完全消灭幻觉。真不是。RAG只是大幅降低幻觉概率,不是彻底消灭。检索出来的内容本身错了,大模型肯定跟着错。就算检索对了九段,混进去一段错的,大模型也有可能抓错重点。有些大模型不听话,你明明让它只说给定资料里的内容,它非要蹦出来自己参数里记的旧知识,该瞎编还是瞎编。
说实话,我见过不下十个项目,上来就整多模态检索、层级RAG一堆花活,结果最基础的切分和召回准确率连80%都不到,最后上线效果烂得一塌糊涂,钱都打了水漂。
现在检索增强生成确实是大模型落地最成熟的方案,企业内部知识库问答、合规客服、医疗文献查询、时事新闻总结,这些场景都用得好好的。我之前做的一个律所项目,把过往十多年的判决书都做成RAG库,律师找案例只要输入问题,几分钟就能拿到整理好的相关案例,比之前自己翻档案室效率高几十倍,准确率也够。
但RAG也不是万能的,不是什么场景都要插一脚。你要让大模型写创意小说,想怎么编就怎么编,要RAG干嘛?多此一举。你要让大模型做复杂数学推理、逻辑推导,外部知识帮不上太多,RAG也没用。还有人觉得RAG完全不用花钱,零成本落地,也不对,做好RAG也要调切分规则、调向量模型、调prompt,还要维护向量数据库的增量更新,每天加新内容,该花的精力还是要花。
现在圈内动不动就吹这个新架构那个新模型,好像不用新技术就落伍了。其实落地到具体场景,能便宜、稳定解决问题的就是好方案。检索增强生成刚好踩中了大多数企业落地大模型的核心痛点:要准、要便宜、要能随时更新知识,不用折腾大模型本身。它不完美,但足够好用。对吧。
为啥原生大模型解决不了的事,检索增强生成能行?
有人说,那我把新资料拿去重新微调大模型不行吗?你试试。一个中等参数的大模型,微调一次,算力成本小几万出去。你公司每周更新几十份内部文档、项目资料,总不能每周调一次吧?疯了吧。 还有人说,那我把所有资料都塞进prompt给大模型看不行吗?现在不是有百万token上下文吗?哦,百万token是能塞,你算算账,一次推理输入十万个token,成本是输入一千个的十倍,公司一天几千次问答,一个月下来算力账单能吓死人。更何况,你塞一堆不相关的内容进去,大模型反而会抓不住重点,该错还是错。原生大模型与RAG生成效果对比图
说白了,原生大模型的知识是死的,改一次成本极高。而企业需要的知识是活的,天天都在变,这个矛盾原生大模型解决不了。检索增强生成的核心优势,就是不用改大模型本身的参数,就能随时给它更新知识,成本还低,刚好戳中了这个痛点。
检索增强生成到底是怎么跑通的?
说出来你可能不信,原理真的简单到离谱,完全不是什么玄乎的黑科技。 整个流程分成前后两步,第一步提前做,不用每次问答都折腾。你先把所有要用到的资料,不管是Word、PDF还是网页,都转成纯文本,再切成一小块一小块的,每块几百个token,不会太长也不会太短。再把每一块文本转成向量嵌入——说白了就是把文字转换成一串能比大小的数字,语义越像的文本,数字串越接近。转完之后全存在专门的向量数据库里,这一步就完事了。 等真的有人问问题,流程也很顺。第一步不是直接扔给大模型,是先把问题也转成向量,去向量数据库里捞,捞出和问题语义最接近的那几个文本块——这些就是和问题相关的资料了。 最后一步,把问题、还有捞出来的相关资料,拼在一起放进prompt里,告诉大模型:就按着我给你的这些资料回答,不许说资料里没有的东西。然后大模型输出流畅的回答,整个流程结束。 说白了,就是分工。大模型擅长组织语言,把零散的信息整成通顺的话,那就让它干这个。找正确相关内容这件事,交给专门的检索模块。就像开卷考试,你先翻书找到正确知识点,再整理成答案写上去,比闭卷靠脑子瞎记准多了。检索增强生成RAG三步工作流程图
不过话说回来,很多人刚接触RAG,总觉得这是最近两年才出来的天顶星技术。其实真不是,检索这玩意儿,搜索引擎做了二十年了,语义向量也搞了十多年,只不过之前没有大模型能把检索到的零散内容整合成流畅的自然回答,现在刚好把两者拼在一起,解决了大模型瞎编的痛点而已。别吹得太神。
用检索增强生成,最容易踩哪些隐形坑?
用检索增强生成,最容易踩哪些隐形坑?
我经手过五六个RAG落地项目,见过的坑比你吃过的米饭还多。说几个最常见的,给大家提个醒。
第一个坑,文本切分太随便。切得太长,大模型prompt放不下,就算放得下,一堆无关内容混进去,大模型找不到重点。切得太碎,好好一段完整的内容被切成好几段,语义都砍没了。比如说员工手册里写“加班超过三小时可调换调休,加班超过八小时按双倍工资计算”,你一刀切在中间,检索出来只有前半句,大模型自然就会答错。
第二个坑,召回准确率不够。切分对了,检索出来的内容不对,也是白搭。很多人图省事,用了免费开源的通用向量模型,语义匹配差十万八千里。用户问“试用期离职需要提前几天打招呼”,结果检索出来一堆正式员工离职的流程,根本没提试用期的事,你让大模型怎么答对?现在很多人吹RAG效果好,其实大部分功夫都花在优化召回准确率上,这才是核心,不是什么花里胡哨的架构。
第三个坑,也是最大的误区:以为RAG能完全消灭幻觉。真不是。RAG只是大幅降低幻觉概率,不是彻底消灭。检索出来的内容本身错了,大模型肯定跟着错。就算检索对了九段,混进去一段错的,大模型也有可能抓错重点。有些大模型不听话,你明明让它只说给定资料里的内容,它非要蹦出来自己参数里记的旧知识,该瞎编还是瞎编。
说实话,我见过不下十个项目,上来就整多模态检索、层级RAG一堆花活,结果最基础的切分和召回准确率连80%都不到,最后上线效果烂得一塌糊涂,钱都打了水漂。
现在检索增强生成确实是大模型落地最成熟的方案,企业内部知识库问答、合规客服、医疗文献查询、时事新闻总结,这些场景都用得好好的。我之前做的一个律所项目,把过往十多年的判决书都做成RAG库,律师找案例只要输入问题,几分钟就能拿到整理好的相关案例,比之前自己翻档案室效率高几十倍,准确率也够。
但RAG也不是万能的,不是什么场景都要插一脚。你要让大模型写创意小说,想怎么编就怎么编,要RAG干嘛?多此一举。你要让大模型做复杂数学推理、逻辑推导,外部知识帮不上太多,RAG也没用。还有人觉得RAG完全不用花钱,零成本落地,也不对,做好RAG也要调切分规则、调向量模型、调prompt,还要维护向量数据库的增量更新,每天加新内容,该花的精力还是要花。
现在圈内动不动就吹这个新架构那个新模型,好像不用新技术就落伍了。其实落地到具体场景,能便宜、稳定解决问题的就是好方案。检索增强生成刚好踩中了大多数企业落地大模型的核心痛点:要准、要便宜、要能随时更新知识,不用折腾大模型本身。它不完美,但足够好用。对吧。