拆分还是打包:重思微服务架构设计的落地陷阱
九月底在南京玄武湖边的技术小聚,碰到三个做架构的朋友,聊起来全是吐槽。有个从大厂跳去创业公司的,说刚去就接了个烂摊子,前负责人把二十人不到的技术团队,拆出了四十多个服务,改个需求要跨三个库发五个版本,每周大部分时间都在调依赖问题。
大部分人聊起拆分,开口就是领域建模,闭口就是限界上下文,说的头头是道,落地全错。 微服务拆分粒度团队规模对应参考图
反例到处都是。我见过五个人的创业项目,照着大厂的公开方案照搬,拆完服务之后,光是搭K8s集群、搞全链路监控、配CI/CD就花了两个多月,产品核心需求拖了两个月,投资人都快没耐心了。
真的没必要。很多时候,做好内部模块化的单块应用,比上百个细粒度服务好用一万倍。除非你真的碰到了实实在在的瓶颈:同一个模块十几个人改,天天解决合并冲突,上线互相影响,拖慢整个版本节奏,那再拆也不迟。
拆分的本质是解耦协作,不是为了凑架构的热点。很多人搞反了目的。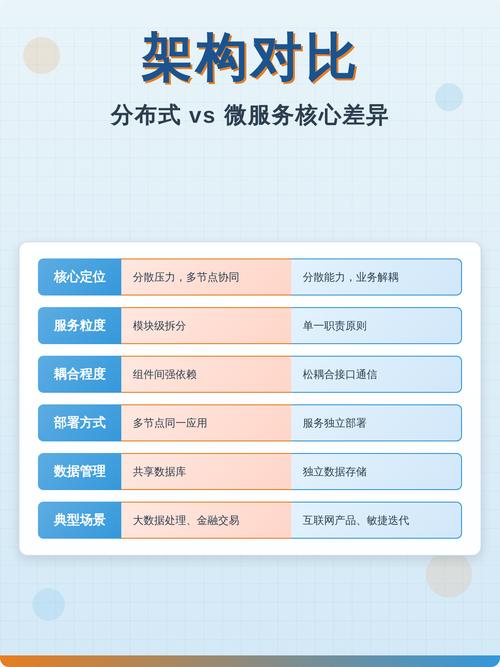 微服务分布式一致性方案选型对比图
不同场景的一致性要求天差地别,别拿一个标准套所有问题。核心的资金交易,必须保证数据准确,但是也要拆分清楚:下单扣库存是核心一致,给用户加积分是次要的,积分晚个三五秒到账,根本没人会在意。你非要把三个操作硬塞进一个分布式事务,纯粹是浪费系统资源,给自己加戏。
能靠最终一致性解决的问题,就别碰强一致性。能用事件溯源加异步补偿搞定的,就别用重量级的强一致协议。这里要划清楚应用边界:核心业务数据绝对不要跨服务拆分,用户的资金账户本来就该放在支付服务里,哪怕逻辑上稍微有点冗余,也比跨服务强一致带来的问题少太多。
我见过不少团队,为了追求所谓的架构纯净性,把核心数据拆的七零八落,最后出了错,对帐对了三天都找不到问题出在哪,钱不对都查不出缺口,苦不堪言。 容错设计,别等雪崩了才补漏洞
分布式系统里,故障是常态。没有任何一个服务能保证永远在线。太多人做设计的时候,只跑通了所有调用都成功的正常流程,就觉得万事大吉,一到线上出点小波动,整个系统全崩。
去年大促前,我帮朋友排查过一个故障:他们的核心交易链路调用了非核心的商品推荐服务,推荐服务依赖的搜索引擎突发故障,推荐接口超时时间居然设了整整三秒,既没有降级也没有隔离,没几分钟,所有Web线程都卡在等待推荐返回,交易请求根本进不来,整个平台直接没法下单,硬生生亏了不少营业额。
隔离比熔断更先做。你哪怕不做复杂的熔断规则,也要先给不同优先级的服务做好资源隔离。核心交易的线程池,绝对不能被非核心的推荐、广告占满。非核心服务挂了,你哪怕给用户返回个默认推荐的空列表,也比整个平台没法交易强一万倍。
太多团队的容错是纸上谈兵,熔断阈值拍脑袋设,上线前从来没做过故障注入测试,从来没模拟过某个服务挂掉的场景,真出问题直接抓瞎。这种事,真的碰一次就够你喝一壶的。
说实话,现在技术圈就爱炒概念,一说就是云原生、服务网格,不管什么规模什么阶段,上来就套,根本不管自己接不接得住。服务网格把治理层抽出来,确实解决了业务开发重复写治理逻辑的问题,但对于十个人以下的小团队,多一层基础设施,就多一层出问题的概率,运维复杂度涨了好几倍,得不偿失。
不过话说回来,架构本来就是解决当下问题的,不是拿来炫技的。你现在产品能不能活过一年都不知道,非要搭一个支持亿级流量的框架,纯属浪费时间。适合自己当前阶段的,才是对的。
大部分人聊起拆分,开口就是领域建模,闭口就是限界上下文,说的头头是道,落地全错。
拆分的尺度,从来不是技术问题
协作边界才是拆分的第一依据。很多人把康威定律用反了,总说组织结构要跟着技术架构调整,可现实是,你的技术拆分必须先匹配现有的协作能力,不然就是自找麻烦。十个人的团队,硬拆出二十个服务,每个人要维护两三个不同的模块,出了问题各说各话,定位问题要拉三个小时的会,研发效率不降才怪。微服务拆分粒度团队规模对应参考图
反例到处都是。我见过五个人的创业项目,照着大厂的公开方案照搬,拆完服务之后,光是搭K8s集群、搞全链路监控、配CI/CD就花了两个多月,产品核心需求拖了两个月,投资人都快没耐心了。真的没必要。很多时候,做好内部模块化的单块应用,比上百个细粒度服务好用一万倍。除非你真的碰到了实实在在的瓶颈:同一个模块十几个人改,天天解决合并冲突,上线互相影响,拖慢整个版本节奏,那再拆也不迟。
拆分的本质是解耦协作,不是为了凑架构的热点。很多人搞反了目的。
分布式一致性,绕不开的权衡
拆分服务之后,第一个要跨的坎就是数据一致性。新手最容易犯的错,就是不管什么场景,都要求全链路强一致。用户改了个昵称,非要所有关联服务立刻同步新昵称,不然就浑身难受,硬套分布式事务把所有相关表都锁一遍,最后接口性能从200ms掉到2000ms,用户用着卡,开发维护也头疼。微服务分布式一致性方案选型对比图
不同场景的一致性要求天差地别,别拿一个标准套所有问题。核心的资金交易,必须保证数据准确,但是也要拆分清楚:下单扣库存是核心一致,给用户加积分是次要的,积分晚个三五秒到账,根本没人会在意。你非要把三个操作硬塞进一个分布式事务,纯粹是浪费系统资源,给自己加戏。能靠最终一致性解决的问题,就别碰强一致性。能用事件溯源加异步补偿搞定的,就别用重量级的强一致协议。这里要划清楚应用边界:核心业务数据绝对不要跨服务拆分,用户的资金账户本来就该放在支付服务里,哪怕逻辑上稍微有点冗余,也比跨服务强一致带来的问题少太多。
我见过不少团队,为了追求所谓的架构纯净性,把核心数据拆的七零八落,最后出了错,对帐对了三天都找不到问题出在哪,钱不对都查不出缺口,苦不堪言。
容错设计,别等雪崩了才补漏洞
容错设计,别等雪崩了才补漏洞
分布式系统里,故障是常态。没有任何一个服务能保证永远在线。太多人做设计的时候,只跑通了所有调用都成功的正常流程,就觉得万事大吉,一到线上出点小波动,整个系统全崩。去年大促前,我帮朋友排查过一个故障:他们的核心交易链路调用了非核心的商品推荐服务,推荐服务依赖的搜索引擎突发故障,推荐接口超时时间居然设了整整三秒,既没有降级也没有隔离,没几分钟,所有Web线程都卡在等待推荐返回,交易请求根本进不来,整个平台直接没法下单,硬生生亏了不少营业额。
隔离比熔断更先做。你哪怕不做复杂的熔断规则,也要先给不同优先级的服务做好资源隔离。核心交易的线程池,绝对不能被非核心的推荐、广告占满。非核心服务挂了,你哪怕给用户返回个默认推荐的空列表,也比整个平台没法交易强一万倍。
太多团队的容错是纸上谈兵,熔断阈值拍脑袋设,上线前从来没做过故障注入测试,从来没模拟过某个服务挂掉的场景,真出问题直接抓瞎。这种事,真的碰一次就够你喝一壶的。
说实话,现在技术圈就爱炒概念,一说就是云原生、服务网格,不管什么规模什么阶段,上来就套,根本不管自己接不接得住。服务网格把治理层抽出来,确实解决了业务开发重复写治理逻辑的问题,但对于十个人以下的小团队,多一层基础设施,就多一层出问题的概率,运维复杂度涨了好几倍,得不偿失。
不过话说回来,架构本来就是解决当下问题的,不是拿来炫技的。你现在产品能不能活过一年都不知道,非要搭一个支持亿级流量的框架,纯属浪费时间。适合自己当前阶段的,才是对的。