量子纠错:量子计算机真正能用的最后一块拼图
去年刷到谷歌悬铃木量子计算机搞出量子优越性的时候,我还在想,这玩意儿离真的能用还有多远? 答案你猜怎么着?差一个量子纠错。
为什么量子计算天生就离不开纠错?
普通计算机的比特,要么是0要么是1,错了就是变了个值,我多存三份,少数服从多数就能改,对吧? 量子比特不一样啊。它靠叠加态吃饭,本身就是个极其脆弱的东西,一点点热扰动、一点点电磁辐射,甚至原子自己的热运动,就能把它的态给搞乱——这行话叫退相干。
哪怕你把整个量子芯片放在接近绝对零度的稀释制冷机里,隔绝了所有能想到的热干扰,只要一个看不见的宇宙射线打过来,整个量子比特的叠加态直接塌缩。之前算的所有东西,全白给。
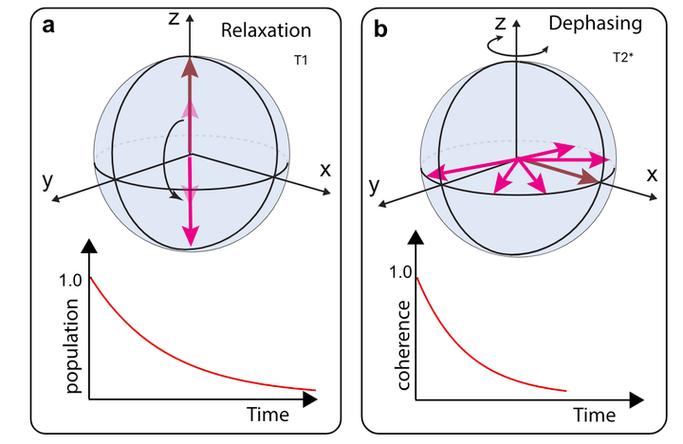 量子比特退相干效应示意图
更坑的是,量子力学有个量子不可克隆定理,你没法像经典纠错那样,直接把量子比特复制个十份八份来投票。所以科学家才想出来,用N个物理量子比特,编码出一个不会那么容易错的逻辑量子比特。
说白了就是,一个人站岗容易走神,一群人轮流互相盯着,谁错了一眼就能看出来。但代价就是,太费物理比特了。早期算出来,要做一个能用的逻辑量子比特,得要上千个物理量子比特堆出来。你想想,那时候全世界最好的量子芯片也就才几百个物理比特,连一个逻辑比特都攒不出来,还谈什么计算?
所以之前那么多喊着“量子优越性”的演示,本质上都是用没有纠错的物理比特跑的,只能算特意设计过的题,稍微复杂一点的实际问题,直接歇菜。
今年吵得火热的量子纠错突破,到底牛在哪?
说实话,量子纠错的理论已经有半个多世纪了,这么多年一直停留在论文和小范围验证里,直到去年,整个领域才炸了一次。
谷歌、哈佛这些团队先后放出成果,人类第一次做到了:纠错后的逻辑量子比特错误率,比单个物理量子比特的错误率还要低。
你品品这个意思。原来我们搞纠错,本来就是为了降低错误,结果之前越纠错越多,因为编码过程本身就会引入新的错误,等于拆东墙补西墙。这次终于做到了,纠错真的有用,我们真的能把错误率降下来了。
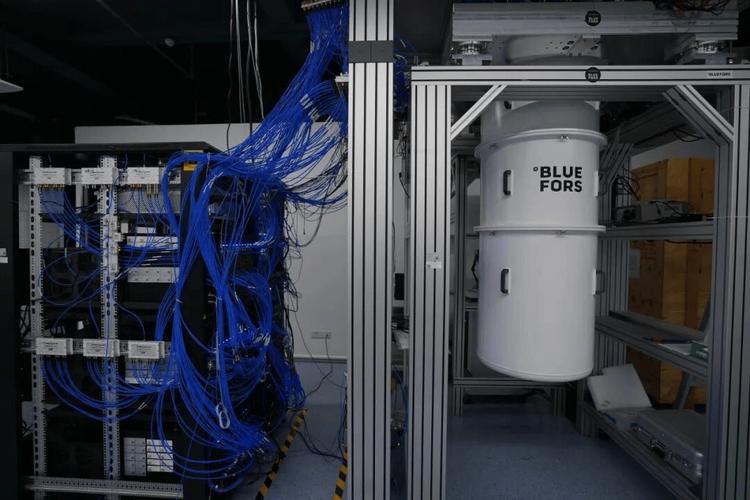 超导量子芯片量子纠错实验平台
这可不是什么小进步,这是整个量子计算从“演示”走向“实用”的第一个里程碑。
不过话说回来,路线之争现在还没结束。走超导路线的IBM、谷歌在使劲堆物理比特,走拓扑量子路线的微软说我天生单个量子比特错误率就低,省好多事。走离子阱路线的 IonQ 说我相干时间长,纠错压力小,你们都靠边站。
不管哪条路,现在都绕不开量子纠错,也都在往这个方向砸钱。去年一年光是量子纠错方向的顶会论文,比前三年加起来都多,可见现在整个行业都把这当成头号突破点了。
我们离能用的纠错量子计算机还有多久?
 我们离能用的纠错量子计算机还有多久?
很多人现在被创投圈的宣传忽悠瘸了,说什么三五年就能颠覆密码学、改变医药行业,那都是吹牛逼。
现在我们才搞定几个逻辑量子比特?一个。对,就一个。你要做能解决实际问题的量子计算,比如模拟一个抗癌药物的分子结构,至少要几千个低错误率的逻辑量子比特,哪怕一个逻辑比特只需要100个物理比特,那就是几十万个物理比特——现在最好的芯片也就才几千个,差两个量级呢。
但你也不用太悲观。进度真的比十年前所有人预想的都快多了。十年前大家说,要做到逻辑错误率低于物理,至少还要二十年,结果去年就做到了。现在还有新的编码方案出来,原来一个逻辑比特要一千个物理,现在新的量子LDPC码,可能一百个就够了,直接把难度砍了一个量级。
现在整个行业的节奏是,硬件堆料每年都在进步,纠错方案也在优化,很多业内大佬都改口了,原来预计2050年才能用上实用纠错量子计算机,现在说,2030年代中后期,就能搞出能解决经典计算机解决不了的问题的纠错量子计算机了。
比如做药物分子模拟,做新材料研发,这些都是经典计算机算不动的活,只要有了几百个纠错后的逻辑量子比特,就能开始试了,不一定非要等到几千几万个。
说白了,量子计算这条路,从费曼提出想法到现在,四十多年了,磕磕绊绊,现在终于走到了最后一关。过了这关,量子计算就真的从实验室里的炫技,变成能改变世界的工具了。
我挺期待的。说不定再过十几年,我们就能靠着纠错量子计算机,搞出能治疗绝症的新药,搞出更高效的新能源材料,谁知道呢?