拆盲盒式的系统稳控:混沌工程为什么不能乱做
从生产事故里长出来的思路
上个月跟南京云原生圈子的一个老哥吃饭,酒过三巡他拍着大腿说去年亏了小几十万,就是瞎折腾乱搞,把生产环境弄挂了两个多小时,给客户赔了钱还挨了总部的骂。
很多人觉得这套思路是近几年云原生火了之后才冒出来的新玩意儿,其实早在上世纪九十年代,就有互联网团队开始故意给系统埋故障找问题了。
当架构从单体拆成几十上百个分布式服务,传统压测的死角就露出来了。压测能测峰值流量能扛住,测不出来某个节点悄悄挂了之后,整个链路会不会连锁崩盘。
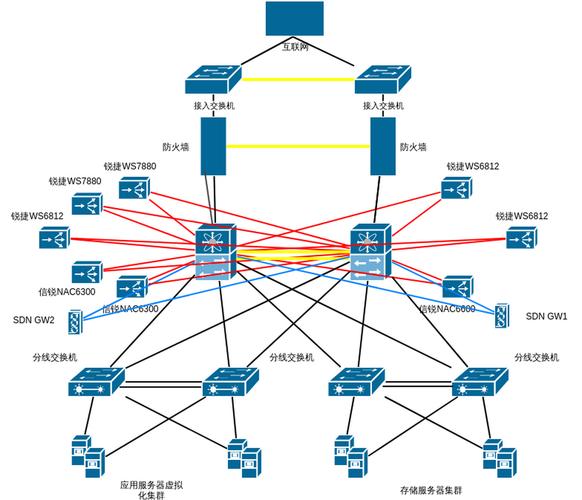 分布式系统单点故障传播路径图
我之前帮一个电商团队做复盘,双十一前压测了一个月,所有指标全绿,结果当天一个缓存节点硬盘故障掉线,所有本该打去缓存的请求直接涌去核心库,没十分钟整个交易链路全挂,大促当天损失几百万。
很多稳定性问题,从来都不是会不会发生的问题,只是什么时候发生的问题。你躲着它,它就会在你最忙的时候找上门。
核心逻辑不是故意搞事
现在市面上最多的误解,就是觉得这套方法就是没事找事,故意炸生产秀技术。
它的核心是通过可控的故障注入,暴露系统设计里的盲区,最终提升系统的韧性,从根上就跟瞎搞不是一回事。所有操作都有清晰的边界和止损机制,没这些前提,碰都不该碰。
开头那个南京老哥的团队,就是典型的反面例子。上来啥准备都没做,直接在预发环境 kill 了核心网关的进程,没想到预发和生产的流量隔离没做干净,异常流量直接飘去生产,把入口带宽打满了,全地区用户都用不了。
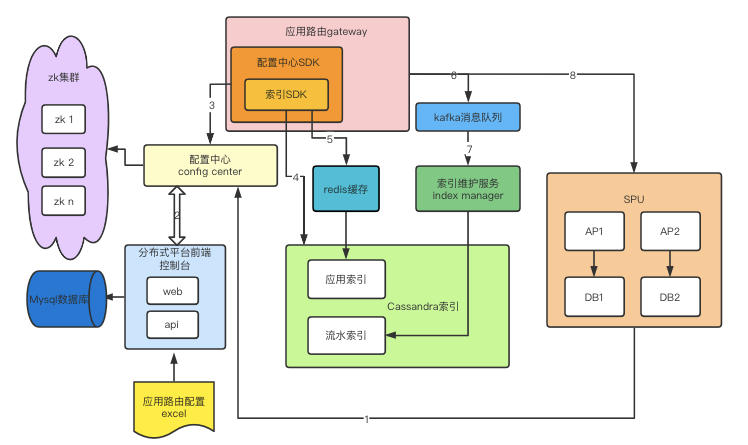 混沌工程故障注入权限隔离架构图
说实话,现在太多公司赶风口,听说这个能提升稳定性,招两个人买个工具就开干,搞出事故又反过来骂这套思路没用,这不扯吗。
整个落地路径里,最核心的约束就是爆炸半径。哪怕你要在生产环境做实验,也要把故障影响锁在极小的范围里,比如只给1%的内部测试流量注入故障,不对普通用户开放,监控全链路挂好,不对一分钟内就能终止实验。
不过话说回来,很多团队做了大半年,其实只做了节点宕机这种最基础的实验,从来没碰过更隐蔽的常见故障:网络延迟升高两百毫秒,数据包随机丢包十分之一,磁盘IO被打满,这些才是线上故障的重灾区。很多系统扛得住单个节点掉线,扛不住三秒的网络延迟——超时配置写错了,一个慢请求占住一个线程,没多久整个线程池就被拖死,全链路阻塞。
应用边界和看不见的风险
 应用边界和看不见的风险
不是所有团队所有系统都适合搞这套。
如果你就是个几万日活的单体应用,服务器也就两三台,折腾这套的人力成本,比真出了故障修一修的成本高多了,完全没必要。再比如金融行业的核心交易系统,对可用性要求是五个九,哪怕你隔离做得再好,出问题的风险和收益也不对等,没必要冒这个险。
还有个非常普遍的误区,就是做完一次全量实验,就觉得万事大吉了。架构是一直在变的,这个月加了三个新服务,改了两次依赖链路,上个月测出来的韧性,这个月可能就没了。真正能用的落地方式,是把小粒度的故障注入嵌到CI/CD流程里,每次发版都测一遍核心链路的容错能力,持续验证,而不是搞一次大的就收工。
还有个看不见的风险,是组织层面的。谁都不想亲手把系统弄挂,哪怕是可控的实验,出了问题万一要背锅呢?很多团队推不下去,根本不是技术问题,是文化问题。要是出了点小问题就扣绩效全组背锅,谁还敢主动碰?只有把出实验故障的追责机制去掉,允许试错,才能真正推得下去。
现在的趋势是自动化,很多云平台都有现成的工具可以一键做故障注入,门槛确实降了很多。但工具只能帮你做注入,不会帮你分析系统的薄弱点,更不会帮你定实验边界,核心还是人对自己系统的理解够不够深。
说白了,这本质上就是给系统做定期体检。你不能啥准备没有就上来开膛破肚,也不能怕出事就从来不体检。找对自己的节奏,框好影响范围,才能真的拿到你想要的稳定性。本来就是帮你找问题的,别反过来把自己搞出大问题,那才是得不偿失。