搞懂云原生可观测性:别再为分布式架构掉头发了
为什么传统监控在云原生架构里彻底失效了
原来做单体应用的时候,服务器就那三五台,核心指标也就CPU、内存、磁盘IO那几个,盯着阈值报警就够了,出了问题登服务器查日志,十有八九能找到。现在不一样啊。微服务拆分完,一次用户请求能串七八上十个服务,容器天天弹性扩缩容,说不定你查问题的时候,出问题的那个容器已经被销毁了。传统监控那套「固定节点拉指标」的逻辑,根本追不上云原生动态调度的节奏。
更坑的是,传统监控解决的都是「已知的未知」——你提前知道要盯这个指标,设了报警,出问题才会告诉你。但云原生里大部分出问题的地方,都是你根本想不到要提前盯的「未知的未知」。比如某个中间件连接池的等待队列,比如网关转发的隐性延迟,比如服务网格的策略冲突…这不扯犊子吗?你都不知道问题会出在这,怎么提前挖好坑等着它?
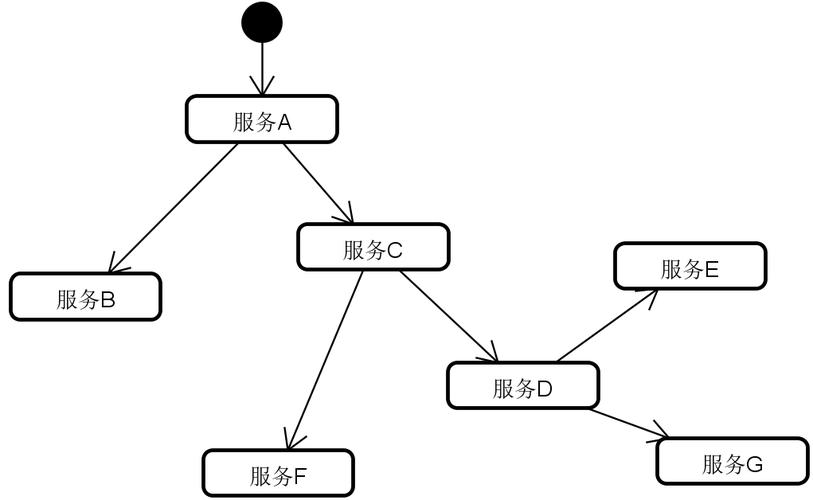 云原生分布式服务请求链路示意图
很多团队踩完这个坑才反应过来,原来云原生不是把应用打包成容器扔去k8s就完事了,看不见摸不着的系统,跟裸奔没区别。
云原生可观测性的核心到底是什么
现在到处都是厂商在吹可观测性,吹得天花乱坠,很多人越看越懵,说白了就是三个数据加一个核心。现在业界公认的可观测性三大支柱:Metrics指标、Logs日志、Traces链路,这三个是基础,但不是凑齐三个就叫可观测性了。
说实话,核心根本不是攒工具,而是不需要提前预埋点,就能随时随地回答你任何关于系统的问题。举个例子,你看到某个接口报错了,不用去猜可能在哪,点一下就能把这次请求从网关入口到数据库返回的全链路拉出来,哪块超时了,哪块打了错误日志,对应节点的资源指标是多少,全给你串在一起。不用你切三个平台,输好几个不同的查询语句拼信息,这才是合格的可观测性。
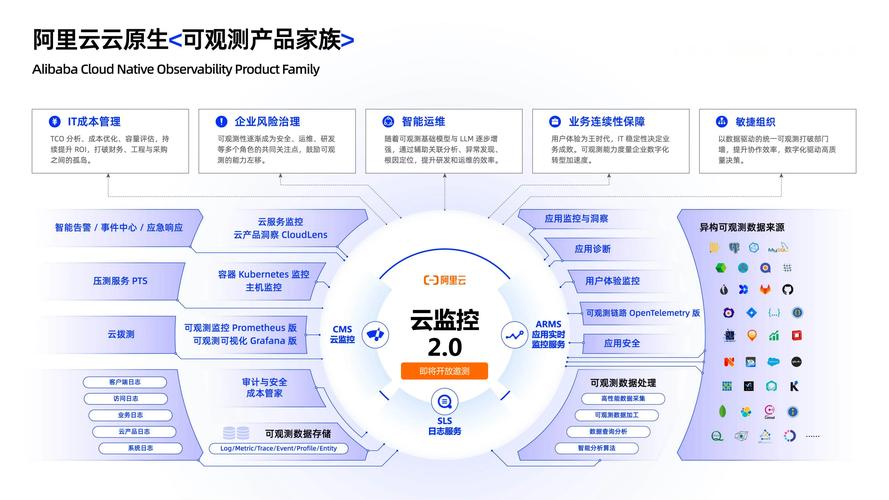 云原生可观测性三支柱数据关联界面图
去年CNCF发布的云原生调查报告里,超过72%的生产级云原生用户把可观测性的建设优先级排在了权限安全前面,你敢信?放在五年前,大家上云原生最先想的是怎么弹性扩容,怎么降低成本,现在上了规模才发现,最疼的就是出了问题找不到根因。
我之前对接过一个做直播电商的客户,去年大促之前压测,所有传统监控指标都显示完全正常,结果一上峰值,整个直播间的下单链路卡成ppt。最后用可观测平台一查,就是某个下游服务的线程池配置得太小,所有请求都堵在排队,之前根本没人想到要把线程池排队长度当成监控指标——这不就是典型的未知的未知吗?要是没可观测性,等你慢慢猜出来问题在哪,大促的流量早就跑光了,损失真的扛不住。
落地云原生可观测性最容易踩的三个坑
 落地云原生可观测性最容易踩的三个坑
现在很多团队都在搭可观测性,十个有八个踩过坑,我整理了最常见的三个,给你们提个醒。
第一个坑,盲目堆工具,不做数据整合。指标用Prometheus,日志用ELK,链路追踪用Jaeger,三个工具各存各的,各玩各的,出了问题你要切三个平台,输不同的查询语句拼信息,折腾半小时还拼不上,钱花了不少,问题还是解决不了,冤不冤?现在OpenTelemetry已经成了事实标准,统一采集统一格式,本来就是帮你解决整合问题的,别再自己攒散件了。
第二个坑,全量采集,把自己成本搞崩。很多人觉得,可观测性就是数据越多越好,所有容器所有接口全量采集,所有日志全存三年,结果不到半年存储就涨了几十T,查询慢到打不开,成本翻了好几倍,最后用不起只能砍一半,等于白搭。说实话,核心链路全量采集,非核心链路按比例采样就够了,真没必要什么都存,遇到问题再临时拉全量也不迟。
第三个坑,只给运维用,不跟开发打通。很多公司把可观测性平台当成运维的监控工具,开发出了问题要找运维开权限要数据,沟通半小时,排障两小时,效率低到发指。本来可观测性就是帮开发快速定位问题,缩短排障时间的,结果搞成了运维的私有工具,完全搞反了方向。开发自己就能查,自己就能定位,这才是可观测性该有的样子。
不过话说回来,现在落地可观测性真的比前几年容易太多了,开源方案成熟,社区资料也多,中小团队不用一开始就买几十万的商业版,基于OpenTelemetry加开源组件搭一套,就能解决绝大多数问题。最近这两年也有很多人在炒AI辅助排障的概念,我看过几个试点,确实能帮你更快定位常见问题,但别太神话,先把基础的三支柱关联做好,就能解决80%的常见问题,剩下的再谈AI不迟。
很多人说云原生是下一代架构,我倒觉得,能不能掌控你的系统,才是真云原生和伪云原生的区别。你养了几百上千个容器,出了问题全靠瞎蒙,那还不如回去跑单体,至少出了问题登服务器就能查。搞对了可观测性,你才能真的享受到云原生的好处,不用天天熬夜排障掉头发。对吧?