打破冯诺依曼墙:存算一体架构的破局与局限
绕不开的原生瓶颈
冯·诺依曼架构从诞生起,就把存储和计算分成了两个独立模块,靠总线连接。过去七十年,这套架构跑的很好,不管是个人电脑还是服务器,都撑过了多轮技术迭代。直到AI大模型的参数体量冲破了原来的平衡。
当大模型参数突破千亿级别后,每次运算需要搬运的数据量是传统计算机视觉任务的上百倍,分离架构下数据跨总线传输的功耗,甚至已经超过了计算本身消耗的功耗。这就是业内说的内存墙。除此之外,单位算力的功耗已经摸到了硅基芯片的物理极限,再往下堆计算核,功耗高到数据中心的散热系统都扛不住,这就是功耗墙。
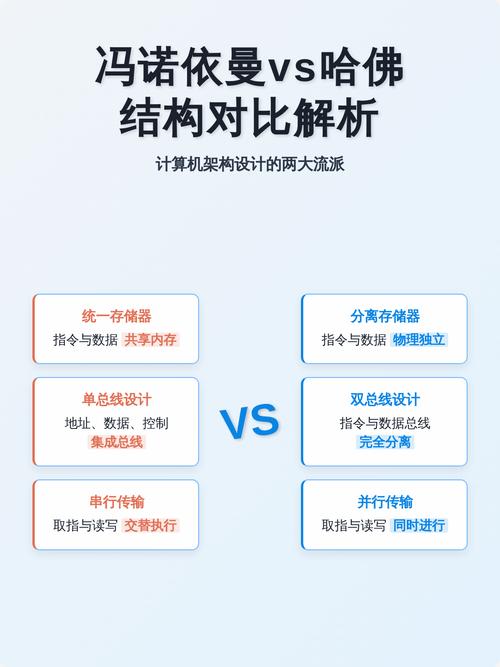 冯诺依曼架构内存墙功耗对比图
堆通用算力的路,越走越窄。所有人都在想,能不能把计算和存储整合在一起,让数据不用长途奔波,从根源上减少传输带来的功耗浪费?
两条路线的优劣势博弈
核心思路说起来简单,真落到硬件设计上,分成了完全不同的两个发展方向,业内至今也没有达成统一的最优共识。现在争议最大的两个方向,就是模拟存算路线和数字存算路线。
模拟存算用器件的物理特性直接做计算,最主流的载体是忆阻器,利用不同忆阻器的电导对应神经网络的不同权重,一次电压输入就能完成整个向量矩阵的乘法运算,天然支持高度并行,功耗能降到传统GPU的十分之一不到,单元密度也比传统架构高很多。这个路线刚好匹配当前端侧AI大模型推理的需求:低精度、高并行、对功耗敏感,所以现在很多产学研项目都往这个方向挤。
但缺陷也致命。模拟信号本身容易受干扰,精度最多稳定做到8比特,再往上就会因为干扰出现过大误差,只能满足推理需求,做不了大模型训练——训练需要16比特以上的精度稳定度,现在模拟路线根本顶不住。良率也是绕不开的问题,忆阻器阵列做到几个Gb规模就会出现大量坏单元,纠错需要额外加逻辑电路,省下来的功耗和面积,一半都填了纠错的坑。
数字存算路线走的是另一个方向,它还是用传统数字CMOS工艺制造,把存储单元和计算单元做的更近,甚至在存储单元里嵌入简单的计算逻辑,精度和传统架构完全兼容,不存在精度缺陷,也能适配一定的通用计算需求。但问题是,它的单元密度上不去,功耗降的也有限,本质只是近存计算,没有真的把计算彻底放进存储介质里,对内存墙的缓解只能算是隔靴搔痒,没有触达根源问题。
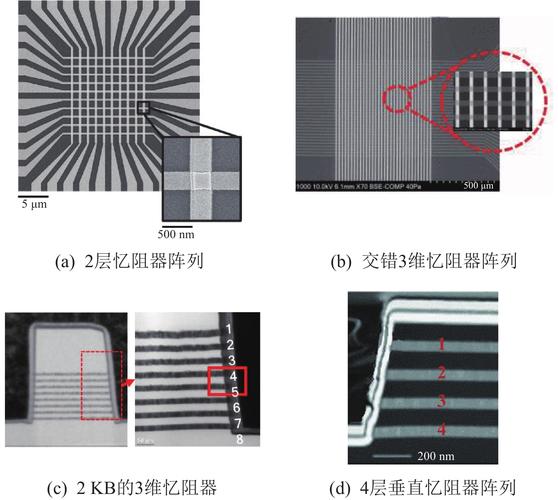 16nm工艺忆阻器存算单元阵列显微图
现在没有哪条路线能做到赢者通吃,只不过是各吃各的场景而已。
落地的边界与隐形的坑
 落地的边界与隐形的坑
现在到处都是“颠覆冯诺依曼”的宣传口号,真落到产业落地才知道,应用边界比大多数人说的要清晰的多。
目前能规模化落地的场景,全都是对精度要求不高、算法结构相对固定的端侧低功耗设备。比如智能门锁的人脸比对、监控摄像头的行为识别、智能手表的健康数据监测,这些场景用存算加速核,确实能把设备待机时间从一天拉长到一周,优势实打实能感知到。
反过来看,数据中心的大模型训练,哪怕是云端推理,短期都看不到替代通用GPU的可能。除了精度问题,最大的短板是可编程性不足。现在大部分存算芯片都是针对特定算法定制的,算法换了、模型结构变了,原来的硬件就没法适配,根本改不了。通用GPU能垄断市场这么多年,核心就是它能跑任何算法,软件升级硬件不用换,灵活性差这个硬伤,不是短时间能填上的。
还有长期可靠性的问题,忆阻器的电导会随时间漂移,温度变化也会带来波动,工业场景用个一两年,推理准确率掉两三个点都是正常情况,对稳定性要求高的工业、汽车场景,现在根本不敢用。
说实话,我见过太多PPT上吹的性能优异,流片出来拿特定的小模型测好看的数据,换个真实的7B参数大模型跑,延时直接翻了五倍,功耗也跟着上去了。不过话说回来,技术成熟本来就需要时间,不能因为有未解决的问题就一棍子打死。
现在行业里最现实的路径,不是搞什么全面替代冯诺依曼架构,是异构集成。把存算加速核和传统的CPU、GPU放在同一块芯片上,存算专门负责跑AI的高并行矩阵乘法,剩下的逻辑控制、通用计算还是交给传统架构,双方各干各擅长的事。比如现在很多终端厂商在研的端侧大模型芯片,就是这个思路,把存算核做成AI加速单元的一部分,专门负责低功耗离线推理,体验提升很明显。
至于更远的未来,生态的建设比硬件本身重要一万倍。现在所有的软件栈、所有的编程模型都是针对传统架构做的,要重新做一套完整适配的开发工具链,培养一批熟悉新架构的开发者,没有十年以上根本做不起来。很多人只看到硬件流片的突破,忘了生态才是真正的壁垒。
路还长。别赚了资本的热度,忘了技术本身的节奏。