从少数样本到通用能力:小样本学习的破局与边界
为什么少数据训练成了卡脖子的问题
传统深度学习的泛化,本质是靠海量样本学出数据的分布,只要测试样本和训练样本落在同一个分布里,就能出不错的结果。但缺数据的场景,连分布都摸不全,更别说学了。
很多人误以为,它只是「数据少一点的深度学习」,这完全错了。这个方向的核心目标,从来都是用少量样本实现分布外泛化能力——也就是模型见过几个同类新样本,就能识别同一类的其他新样本,哪怕这些样本和之前训练过的完全不一样。
举个例子,你给模型看了十张不同种类的猫,每一种只给一张图,模型要能认出从来没见过的同种类猫,而不是只会认训练过那一只。换成人话就是,你看了一眼丹顶鹤,你下次见到另一只丹顶鹤,不会因为它体型大一点、羽毛深一点就认不出来,AI原来做不到,现在要做到。
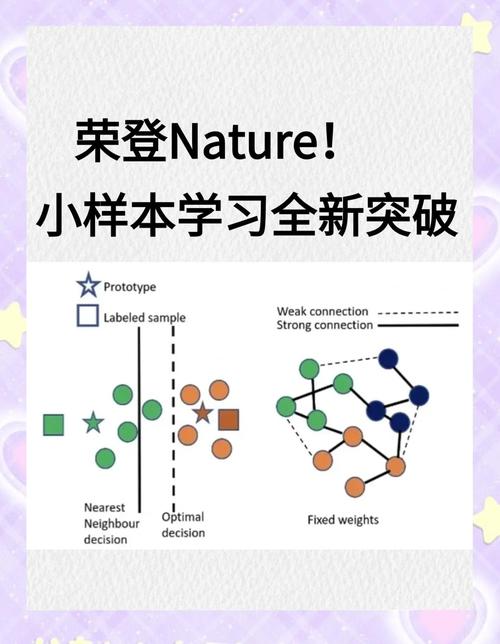 传统深度学习与小样本学习泛化效果对比图
三类主流路径的各自陷阱
现在走到台前的路径大概有三类,各有各的好用,也各有各的甩不掉的坑。
第一类是元学习路径,核心思路是「学会怎么学习」。提前用大量的小任务训练模型,让模型学会快速适配新任务的能力,说白了就是练出好的学习方法,遇到新任务只需要几个样本就能快速调整参数。这个路子在标准测试集上成绩很好,但落地的时候有个隐形前提:你得有足够多的不同小任务来预训练。要是连这个都没有,元学习也巧妇难为无米之炊。
第二类是数据增强路径,靠生成模型给少数样本补数据,原来几个样本,生成几千个同分布的新样本,再训模型。思路很直白,但问题出在生成质量上。如果生成的样本引入了额外的偏差,最终模型的效果反而比直接用原始小样本训还差。比如你识别罕见的植物病害,原始样本都是晴天拍的,生成出来的样本全带了多余的阴影,模型最后就会把阴影当成病害的特征,完全学歪。
第三类是大模型上下文学习路径,这也是现在最火的路子。预训练大模型已经在预训练阶段攒了海量的通用先验知识,只需要把几个样本拼到prompt里给大模型,就能直接输出结果,不用调参数。太方便了对吧?但不稳定。我去年帮朋友测过一个场景,同样三个样本,换个排列顺序,准确率直接掉了12个百分点,这种波动放到工业场景里,谁敢用?
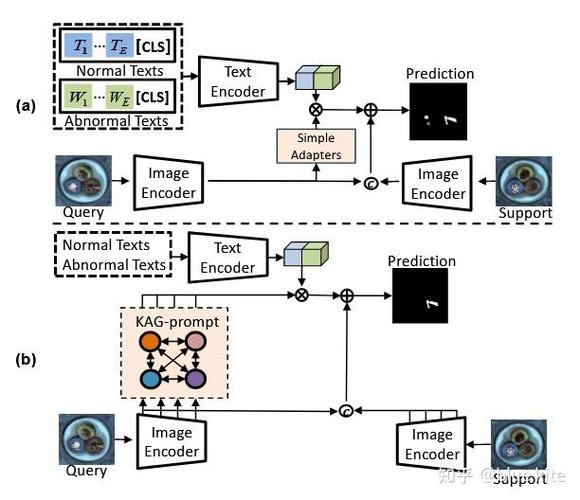 大模型小样本prompt顺序干扰实验结果图
说实话,没有哪条路是万能的,选路径得看你手里有什么资源。你有一堆小任务,就用元学习。你有个效果不错的生成模型,就走增强。你手里有个能调用的大模型,快速出原型用上下文学习也挺好。
被忽略的边界与隐形风险
 被忽略的边界与隐形风险
现在很多人吹这个方向,说未来AI不用大数据了,全靠几个样本就能干活。这话听听就行,别当真。它有它绝对碰不了的边界。
如果一个领域的知识,完全不在模型的先验里,哪怕你给十个八个样本,也出不了能用的模型。比如你要让模型识别一种刚人工合成出来的新材料的微观结构,整个互联网都没有相关数据,大模型预训练也没见过,哪怕你给五个样本,模型也根本提炼不出正确特征。算法变不出来不存在的信息,这个道理永远成立。
比边界更值得警惕的是偏差放大效应。大数据里,少量的偏差会被海量样本稀释,对最终效果影响不大。但在小样本场景里,样本本身少,一丁点偏差都会被模型放大成核心特征。比如做罕见病诊断,收集到的样本全都是来自大城市三甲医院的成年患者,模型就会默认这个病只会得在成年人身上,遇到儿童患者就会漏诊,这个问题比大数据场景下严重十倍都不止。
不过话说回来,这个方向的价值,本来就不是取代大数据深度学习,而是解决原来大数据解决不了的问题。那些攒不出海量数据的细分场景,那些刚起步的新领域,终于能用上AI了,这才是它真正的意义。
未来怎么走?不是比谁能用更少的样本刷榜,而是怎么更好的把人类已经有的领域知识揉进算法里,用知识补样本不足的缺口,这条路才走得远。