拆解联邦学习中的非独立同分布:落地路上的头号拦路虎
你有没有碰到过这种情况?联邦学习模型在实验室训完,精度看着还不错,一放到实际业务里跑,直接拉胯。准确率掉十个点都是常事。
十有八九,就是非独立同分布搞的鬼。
说实话,现在圈外很多人听联邦学习,只记住了“隐私计算”“数据可用不可见”,根本没听过这个概念,可偏偏它就是卡住大部分联邦项目落地的核心问题。
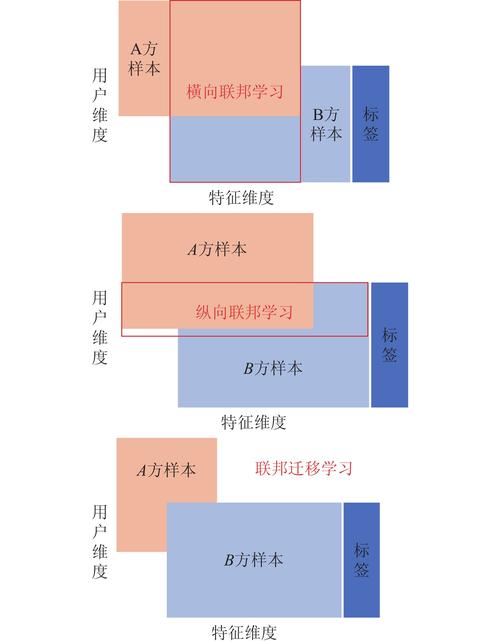 联邦学习不同客户端非独立同分布数据对比图
这种每个客户端数据分布都不一样的情况,就是联邦学习里的非独立同分布,圈内人常简称非IID。
它还分好几种坑人的情况:最常见的是标签分布倾斜,一个客户端全是猫的图片,另一个全是狗的,模型学出来能不歪吗?然后是特征分布偏移,同样是做人脸识别,苹果手机和安卓千元机拍出来的图片,像素、色差差很多,特征分布完全不一样;最坑的是概念偏移,同样是“高风险用户”,消费金融公司看的是逾期,银行看的是授信违规,定义都不一样,模型根本不知道该学啥。
很多刚入行的新手,上来就套FedAvg跑,不崩才怪。
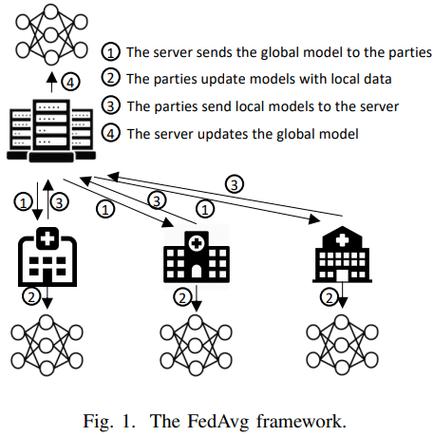 FedAvg在非独立同分布下梯度聚合错误示意图
第二个大问题就是泛化性差,过拟合到本地偏置。每个客户端学的都是自己数据的特有规律,全局模型根本抓不住跨客户端的通用特征。放到新的客户端上用,直接就歇菜。
原来大家说联邦学习解决数据孤岛,可孤岛本身不仅数据不出域,每个孤岛的“生态”都不一样,非IID就是这个生态差异带来的原生问题。
不过话说回来,现在一堆PPT天天吹联邦学习能解决多少问题,连非IID都搞不定,谈什么落地啊?对吧。
 现在行业里都是怎么搞定它的?真的能用了吗?
这几年学界工业界搞出来的方案不少,大概分三派,各有各的好用场景,也各有各的坑。
第一派,从数据层面调,做分布对齐。说白了就是不碰原始数据,在隐私保护的前提下,给各个客户端的数据分布做校准,要么加正则项惩罚偏得太厉害的本地模型,要么用知识蒸馏,让各个客户端把自己的数据知识蒸馏成软标签,互相学习对齐分布。去年字节跳动开源的联邦学习框架里,就加了对比蒸馏的方案,在经典的非IID图像数据集上,准确率直接拉到接近集中训练的水平,提升真的很明显。
第二派,改聚合规则,搞个性化联邦。原来FedAvg是给所有客户端一样的权重,现在呢?要么给分布更均匀、数据质量更好的客户端更高的权重,减少偏梯度的影响;最常用的还是做分层个性化,全局模型学跨客户端的通用知识,每个客户端留一两层自己微调,适配本地的数据分布。现在大部分落地的金融联邦项目,用的都是这个思路,做出来的模型精度,比纯全局FedAvg高五到十个点,效果很明显。当然缺点也有,每个客户端要存自己的参数,存储成本涨不少,小机构承受起来有点压力。
第三派,借大模型的东风,用大模型做联邦。这是最近一两年的新趋势,大模型本身的迁移能力和泛化能力就很强,哪怕数据分布不一样,大模型抽出来的通用特征也不会偏得太离谱,再做联邦微调,非IID的影响自然就小了很多。现在不少大厂都在做大模型联邦,就是冲这个来的。
那现在落地的情况怎么样了?说实话,还没有万能的解决方案,那些说自己完美解决非IID的,都是吹牛逼。
现在工业界做项目,通用的玩法就是先做数据分布预探测,把偏得太离谱的脏数据先筛出去,再用个性化FedAvg加轻度正则,差不多能达到集中训练90%以上的精度,已经足够满足业务需求了——毕竟现在隐私合规要求摆在那,能不碰原始数据还能达到这个效果,已经够能用了。
联邦火了快十年,前十年大家都盯着怎么防隐私泄露,最近几年才回过神来,联邦学习中的非独立同分布,才是真正卡脖子的问题。接下来好几年,估计这个方向还会出一堆新东西,毕竟不搞定它,联邦永远只能躺在实验室发论文,走不进真实业务。
什么是联邦学习里的非独立同分布?说人话不讲公式
我们先掰扯清楚。独立同分布是什么意思?就是所有参与训练的数据集,样本的特征和标签都服从同一个分布。比如你做猫狗分类,每个参与方手里都是一半猫一半狗,像素分布也差不多,这就是独立同分布,模型训起来顺得很。 放到联邦学习的真实场景里,可能吗? 不可能啊。每个参与方都是各自攒的数据,根本凑不到一起调分布。做风控,一线城市城商行的客户和三四线城商行的客户,收入水平、消费习惯天差地别,数据分布能一样吗?做推荐,抖音的用户和快手的用户,偏好差十万八千里,标签分布歪到不知道哪去了。联邦学习不同客户端非独立同分布数据对比图
这种每个客户端数据分布都不一样的情况,就是联邦学习里的非独立同分布,圈内人常简称非IID。
它还分好几种坑人的情况:最常见的是标签分布倾斜,一个客户端全是猫的图片,另一个全是狗的,模型学出来能不歪吗?然后是特征分布偏移,同样是做人脸识别,苹果手机和安卓千元机拍出来的图片,像素、色差差很多,特征分布完全不一样;最坑的是概念偏移,同样是“高风险用户”,消费金融公司看的是逾期,银行看的是授信违规,定义都不一样,模型根本不知道该学啥。
很多刚入行的新手,上来就套FedAvg跑,不崩才怪。
非独立同分布到底把联邦学习坑在了哪?
最直观的问题就是梯度聚合跑偏,模型训不动。 原来经典的FedAvg算法逻辑很简单:每个客户端本地训完模型,把梯度传给中心聚合,平均一下出全局模型。那如果每个客户端数据分布不一样,梯度方向能一样吗?一个客户端梯度往左,一个往右,平均下来直接互相抵消,走不动道了,相当于训了个寂寞。 我之前帮朋友看过一个风控联邦项目,二十多家机构参与,聚合出来的全局模型AUC,比本地表现最好的单个模型还低0.1,你说扯不扯?FedAvg在非独立同分布下梯度聚合错误示意图
第二个大问题就是泛化性差,过拟合到本地偏置。每个客户端学的都是自己数据的特有规律,全局模型根本抓不住跨客户端的通用特征。放到新的客户端上用,直接就歇菜。
原来大家说联邦学习解决数据孤岛,可孤岛本身不仅数据不出域,每个孤岛的“生态”都不一样,非IID就是这个生态差异带来的原生问题。
不过话说回来,现在一堆PPT天天吹联邦学习能解决多少问题,连非IID都搞不定,谈什么落地啊?对吧。
现在行业里都是怎么搞定它的?真的能用了吗?
现在行业里都是怎么搞定它的?真的能用了吗?
这几年学界工业界搞出来的方案不少,大概分三派,各有各的好用场景,也各有各的坑。
第一派,从数据层面调,做分布对齐。说白了就是不碰原始数据,在隐私保护的前提下,给各个客户端的数据分布做校准,要么加正则项惩罚偏得太厉害的本地模型,要么用知识蒸馏,让各个客户端把自己的数据知识蒸馏成软标签,互相学习对齐分布。去年字节跳动开源的联邦学习框架里,就加了对比蒸馏的方案,在经典的非IID图像数据集上,准确率直接拉到接近集中训练的水平,提升真的很明显。
第二派,改聚合规则,搞个性化联邦。原来FedAvg是给所有客户端一样的权重,现在呢?要么给分布更均匀、数据质量更好的客户端更高的权重,减少偏梯度的影响;最常用的还是做分层个性化,全局模型学跨客户端的通用知识,每个客户端留一两层自己微调,适配本地的数据分布。现在大部分落地的金融联邦项目,用的都是这个思路,做出来的模型精度,比纯全局FedAvg高五到十个点,效果很明显。当然缺点也有,每个客户端要存自己的参数,存储成本涨不少,小机构承受起来有点压力。
第三派,借大模型的东风,用大模型做联邦。这是最近一两年的新趋势,大模型本身的迁移能力和泛化能力就很强,哪怕数据分布不一样,大模型抽出来的通用特征也不会偏得太离谱,再做联邦微调,非IID的影响自然就小了很多。现在不少大厂都在做大模型联邦,就是冲这个来的。
那现在落地的情况怎么样了?说实话,还没有万能的解决方案,那些说自己完美解决非IID的,都是吹牛逼。
现在工业界做项目,通用的玩法就是先做数据分布预探测,把偏得太离谱的脏数据先筛出去,再用个性化FedAvg加轻度正则,差不多能达到集中训练90%以上的精度,已经足够满足业务需求了——毕竟现在隐私合规要求摆在那,能不碰原始数据还能达到这个效果,已经够能用了。
联邦火了快十年,前十年大家都盯着怎么防隐私泄露,最近几年才回过神来,联邦学习中的非独立同分布,才是真正卡脖子的问题。接下来好几年,估计这个方向还会出一堆新东西,毕竟不搞定它,联邦永远只能躺在实验室发论文,走不进真实业务。