容错计算技术:你每天用却根本没听说过的“系统保命符”
上次帮一个创业圈的朋友排查云服务器故障,他连着三天大促崩三次,丢了几十万的订单,骂完运维骂供应商,最后翻架构图才发现——所谓的“高可用”就是买了两台服务器,一台主用一台备用,主的挂了手动切,根本没做动态容错。
说白了,他连容错计算的门槛都没摸到。
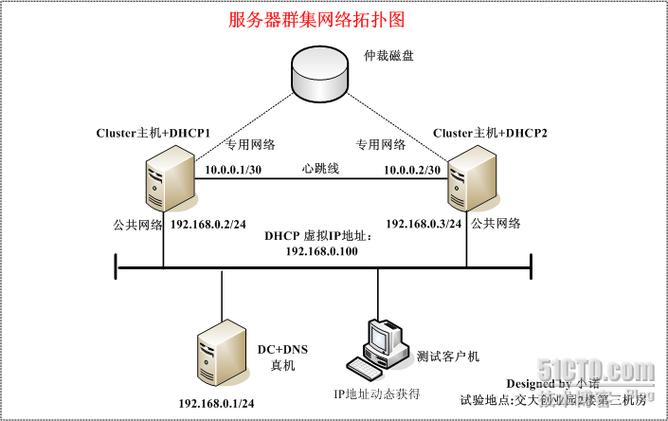 互联网服务器集群容错计算技术原理图
说实话,我见过太多公司踩这个坑。为了省那点服务器成本,觉得“哪那么容易坏”,砍掉了动态容错的架构设计,结果一次突发故障,就把半年赚的钱都赔进去了。
真的不值。
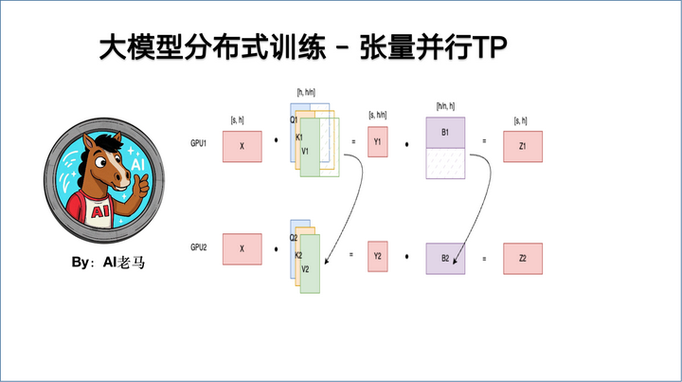 大模型分布式训练容错计算任务调度图
你日常用的各种互联网服务,其实到处都是容错计算的影子。双11的时候淘宝流量炸了,你可能付不了款,但照样能逛商品加购物车,这就是容错里的“降级”——保核心的交易流程,先砍非核心的功能,总比整个系统全崩了强对吧?
微服务里的熔断、限流,本质上都是容错计算延伸出来的工程方法。
 容错计算的下一站,跟着AI一起进化
以前的容错都是“出事了再补救”,现在已经变成“没出事先预防”了,而帮着实现这个转变的,就是AI本身。
现在不少云厂商已经推出了智能容错系统,靠AI模型提前预测硬盘、服务器的故障,准确率能做到九成以上,提前把硬盘换了,把任务挪走,用户根本感知不到任何异常。放在十年前,这种操作想都不敢想,那时候都是硬盘坏了才报警,已经晚了。
现在边缘计算、自动驾驶这些新场景起来,对容错计算的要求更高了。自动驾驶的车机系统,好几个芯片同时工作,主芯片出问题,备用芯片必须毫秒级接过来,不能等撞车了再反应,这就是硬实时容错,对技术的要求比云端高太多了。
不过话说回来,现在很多做AI的团队,还是犯老毛病——只盯着模型参数、准确率,根本不重视底层的容错设计。我之前见过一个做端侧自动驾驶的创业团队,模型精度在测试集上做到了99.9%,结果路测的时候一个摄像头出了点噪声,模型直接错判,差点出事。
真的是捡了芝麻丢了西瓜。
现在头部的AI公司都已经把容错计算放到核心位置了,OpenAI之前发的分布式系统论文,大半篇幅都在讲他们怎么给GPT做容错调度,毕竟这么大的服务,天天几千万人用,崩十分钟都是世界性的新闻,丢不起这个人。
其实往深了想,容错计算的本质特别有意思:它从一开始就承认,这个世界没有完美的东西,硬件会坏,软件会出bug,人会写错代码,接受这种不完美,然后花合理的成本,设计出一套不会因为一点不完美就全垮掉的系统。
这才是真正务实的工程思维。
很多人追求100%完美无错的系统,最后成本高到根本做不出来,反而不如花三成成本做容错,拿到99.99%的可用性,性价比高到天上去。
你今天出门用导航,点外卖,刷社交软件,全程一点卡顿故障都没遇到,别觉得这是理所当然,那是容错计算在背后默默给你兜着底呢。
这技术低调了几十年,从来不爱出来抛头露面,但缺了它,整个互联网都得乱套。
什么是容错计算?不是简单“坏了再换”那么简单
很多人对容错的印象就是备份,坏了恢复就行,这真的错得离谱。 容错计算的核心是:系统出现硬件故障或者软件错误的时候,不用停机,不用用户等待,照样正常干活。备份是出事之后救火,容错是出事的时候你连火都看不到。 你刷短视频刷得好好的,后台某一台服务器电源烧了,你照样划屏,连一秒加载转圈都没有,这就是容错计算在干活。它瞬间就把那台坏机器的任务,分到了集群里其他正常机器上,整个过程不到百毫秒,你根本感觉不到。互联网服务器集群容错计算技术原理图
说实话,我见过太多公司踩这个坑。为了省那点服务器成本,觉得“哪那么容易坏”,砍掉了动态容错的架构设计,结果一次突发故障,就把半年赚的钱都赔进去了。
真的不值。
当下最火的大模型,最离不开的就是容错计算
容错计算发展几十年了,早就不是早年冷备份的笨办法了。 早年航天领域用的容错,就是把三套一模一样的计算机拼上去,三个结果投票,少数服从多数,那成本高到只有航天、银行这种土豪行业玩得起。现在不一样,不管是硬件层还是软件层,都玩出花了。 硬件层面,现在每一块你手机里的CPU,其实都自带容错纠错功能,宇宙射线打歪一个比特,内存直接就给你纠正了,根本不会让你手机闪退。当年阿波罗登月,导航计算机算力还不如你现在的智能手表,就是靠冗余容错设计,愣是扛过了太空的复杂环境,成功登月,说起来真的太神奇了。 放到现在,最需要容错计算的,就是现在火到发紫的大模型训练。你想想,训练一个千亿参数的大模型,几千块GPU跑半个月,光电费就几百万,要是跑到一半某一块GPU出个小小的硬件错,总不能全部从头再来吧? 现在主流的分布式训练框架,都集成了先进的容错计算模块,自动检测出错的GPU节点,立刻把任务切到空闲卡上,整个训练不用停,顶多慢几个小时,不会全功尽弃。这要是搁十年前,根本不敢想。大模型分布式训练容错计算任务调度图
你日常用的各种互联网服务,其实到处都是容错计算的影子。双11的时候淘宝流量炸了,你可能付不了款,但照样能逛商品加购物车,这就是容错里的“降级”——保核心的交易流程,先砍非核心的功能,总比整个系统全崩了强对吧?
微服务里的熔断、限流,本质上都是容错计算延伸出来的工程方法。
容错计算的下一站,跟着AI一起进化
容错计算的下一站,跟着AI一起进化
以前的容错都是“出事了再补救”,现在已经变成“没出事先预防”了,而帮着实现这个转变的,就是AI本身。
现在不少云厂商已经推出了智能容错系统,靠AI模型提前预测硬盘、服务器的故障,准确率能做到九成以上,提前把硬盘换了,把任务挪走,用户根本感知不到任何异常。放在十年前,这种操作想都不敢想,那时候都是硬盘坏了才报警,已经晚了。
现在边缘计算、自动驾驶这些新场景起来,对容错计算的要求更高了。自动驾驶的车机系统,好几个芯片同时工作,主芯片出问题,备用芯片必须毫秒级接过来,不能等撞车了再反应,这就是硬实时容错,对技术的要求比云端高太多了。
不过话说回来,现在很多做AI的团队,还是犯老毛病——只盯着模型参数、准确率,根本不重视底层的容错设计。我之前见过一个做端侧自动驾驶的创业团队,模型精度在测试集上做到了99.9%,结果路测的时候一个摄像头出了点噪声,模型直接错判,差点出事。
真的是捡了芝麻丢了西瓜。
现在头部的AI公司都已经把容错计算放到核心位置了,OpenAI之前发的分布式系统论文,大半篇幅都在讲他们怎么给GPT做容错调度,毕竟这么大的服务,天天几千万人用,崩十分钟都是世界性的新闻,丢不起这个人。
其实往深了想,容错计算的本质特别有意思:它从一开始就承认,这个世界没有完美的东西,硬件会坏,软件会出bug,人会写错代码,接受这种不完美,然后花合理的成本,设计出一套不会因为一点不完美就全垮掉的系统。
这才是真正务实的工程思维。
很多人追求100%完美无错的系统,最后成本高到根本做不出来,反而不如花三成成本做容错,拿到99.99%的可用性,性价比高到天上去。
你今天出门用导航,点外卖,刷社交软件,全程一点卡顿故障都没遇到,别觉得这是理所当然,那是容错计算在背后默默给你兜着底呢。
这技术低调了几十年,从来不爱出来抛头露面,但缺了它,整个互联网都得乱套。