别拿运气当本事:系统可靠性设计到底能帮你躲过多少坑
我上个月帮一个创业公司查线上故障,刚上线三个月的电商系统,大促当天直接崩了。老板蹲在服务器机房门口抽烟,抽了半盒说,之前测试都好好的啊,怎么说崩就崩。
我翻了半天监控,没好气回他,你就一台主服务器,连个备用节点都没有,硬盘挂了你说能怎么办?
他愣了半天,说我想着省点成本...
别把冗余设计当成浪费钱
很多中小团队老板都这思路:我买一台服务器够用来着,多买一台放着不用,不是烧钱吗?测试又没出过错,哪那么巧轮到我倒霉?
去年某社区团购平台,就是主节点挂了,没做跨可用区冗余,直接停服三个小时,十几万订单直接丢了,攒了半年的用户好感,一天就造没了。
冗余不是多余,是给整个系统留后路,对吧?哪怕你是小团队,做个简单的主备切换,花不了多少钱,比真出了问题再救火便宜一万倍。
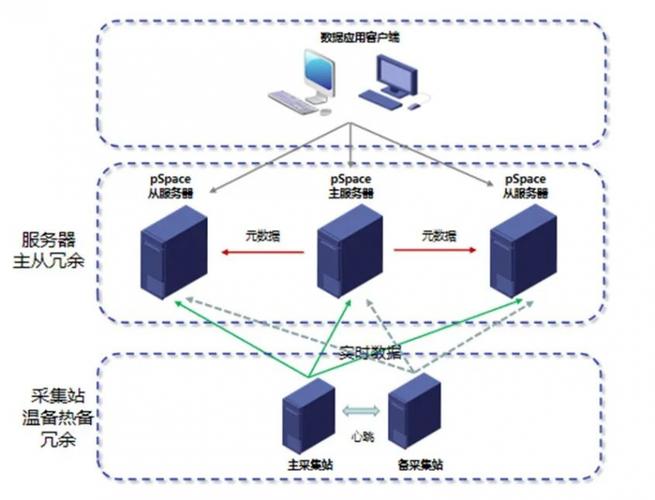 分布式系统可靠性多可用区冗余部署图
说实话,我见过太多团队为了省那千八百块钱的服务器费用,最后赔出去几百万的订单违约金,还有砸掉的口碑。
血的教训。
故障演练不是吃饱了撑的
我跟很多技术负责人聊,十个有八个说,我系统好好的,干嘛故意搞坏它?出了问题谁负责?
之前接触过一个国有银行的科技团队,人家现在每个季度都要随机拔一台服务器的网线,故意搞宕机。一开始运维总监拍桌子反对,说这不是没事找事吗?结果第一次演练就挖出来大问题——主备切换的时候,用户在途交易的流水会丢整整两分钟。
这要是真等到出故障才发现,银保监会都要上门调查,谁担得起这个责任?
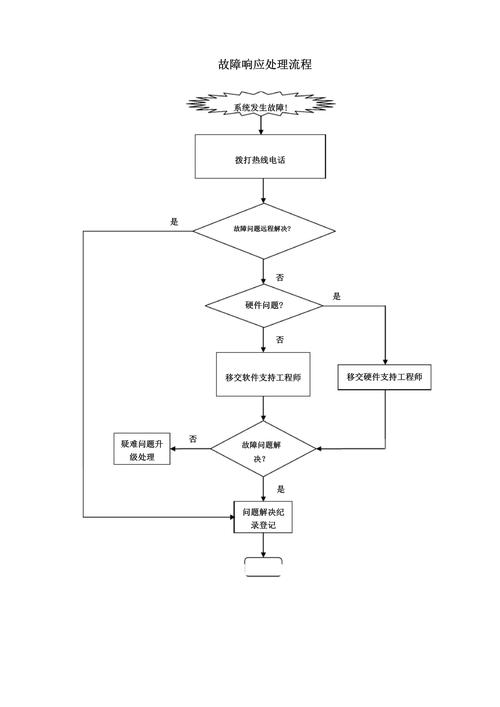 互联网系统混沌工程故障演练流程图
不过话说回来,很多小团队哪有精力学大厂搞全量混沌工程?也不用上来就搞那么复杂。先测最核心的链路行不行?比如支付挂了怎么办?核心数据库连不上怎么办?抽一个下午测一次,你就能发现一堆你想都想不到的暗坑。
我上次帮一个做SaaS的创业团队做了一次半小时的模拟宕机,挖出来三个配置错误,全都是上线两年都没碰到过的暗雷。要是真等到出问题再修,客户估计都跑光了。
慢故障才是最致命的隐形杀手
 慢故障才是最致命的隐形杀手
很多人对系统故障的印象,就是直接宕机、出500错误,整个服务停掉。其实绝大多数能把你坑死的故障,都是慢故障。
什么是慢故障?比如说内存泄漏,一开始只是内存多占了几百M,响应慢个几十毫秒,谁都不会在意。过半个月,慢慢涨到占满整个服务器内存,直接就跪了,等你发现的时候,都不知道问题是从什么时候开始的。
还有连接池泄漏,一开始少一两个连接,只有高峰期才出问题,平峰完全看不出来。等你反应过来不对,已经不知道偷偷挂了多少次,丢了多少请求了。
好的系统可靠性设计,一定会给慢故障留足监控空间。不是只加个宕机告警就完事儿,要对各种核心指标做趋势预警——内存占用连续三天每天涨5%,直接告警,不等它出问题就解决。
哦对了,还有依赖第三方服务带来的慢故障。你这边系统好好的,第三方接口从100ms慢慢变成500ms再变成2s,你的连接池排队排满,最后整个系统都被拖垮。这种事我见得太多了。所以一定要做熔断降级,第三方慢了,直接切掉非核心依赖,别把自己拖死。
这两年AI大模型火,很多公司都在搭自己的大模型推理服务,掉可靠性坑的特别多。我上个月碰一个客户,他们搭的推理集群,忘了给负载均衡加健康检查,某个推理卡出问题了,负载均衡还一直往上面打请求,结果三分之一的请求直接报错,用户投诉炸了才找到问题。其实就是加个十几行配置的事,一开始嫌麻烦,最后花了三天才擦干净屁股。
做技术这行,从来都是走夜路多了总能碰到鬼。你今天偷的懒,省的那点小事,未来某个你睡的正香的深夜,都会变成疯狂响的电话铃把你炸醒。
可靠性设计,不是给领导看的KPI文档,是给你自己买的一份sleep well保险。