当蚂蚁走错路:生物启发算法的工程边界与可验证性
九月下旬在南京的一次产学研交流上,我听到一个不太浪漫的场景。某制造企业把车间排产交给改进的蚁群算法,演示时曲线漂亮,上线两周后班组长开始手动改单。问题不在蚂蚁不聪明,而在约束变了:换模时间、人员资质、临时插单,这些没有进入信息素矩阵。算法仍在搜索,现场已经换了问题。
这类落差值得认真对待。生物启发算法(bio-inspired algorithms)常被包装成通用搜索器,仿佛只要种群够大、迭代够多,就能绕过建模。工程上恰恰相反:启发式只负责在给定表示和评估方式下探索,不能替人定义问题。
蚂蚁留下的是概率,不是答案
蚁群优化(ACO)的机制并不神秘。人工蚂蚁按信息素和启发式因子选择边,走完一条路径后按解质量更新信息素,较好解获得增强,较差解逐渐挥发。它借用的是群体正反馈,不是生物学复刻。粒子群优化(PSO)也类似:粒子在速度惯性、个体历史位置和群体历史位置之间折中。遗传算法则用选择、交叉、变异维持多样性。
这些操作有一个共同前提:解的编码、邻域结构和适应度函数必须匹配问题。编码错了,交叉会破坏可行结构;邻域错了,变异等于随机重启;适应度函数漏掉关键约束,算法会精准地优化一个错误目标。说实话,很多失败案例不是算法弱,而是建模偷懒。
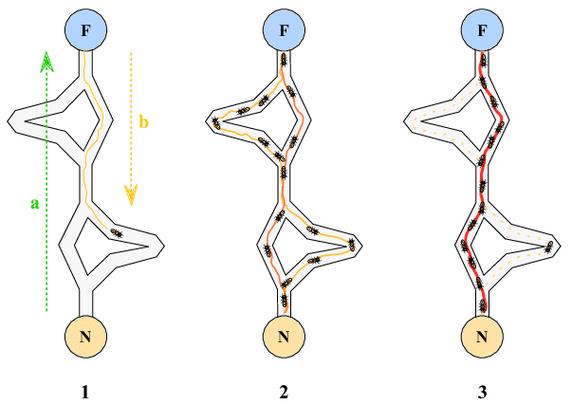 蚁群算法信息素路径选择示意图
还有一个容易被忽略的点:生物启发算法通常不保证收敛到全局较优解。它们提供的是随机搜索框架,收敛性依赖参数、停止准则和问题景观。把“仿生”当成“全局保证”,在学术上不成立,在工程上会付出返工代价。
适应度景观不会因为名字好听就变平
搜索问题的困难来自景观:多峰、平坦、欺骗性、约束狭窄、评估昂贵。启发式算法擅长在缺乏梯度信息时维持探索,但它不消除景观本身。No Free Lunch 的结论早已提醒我们:没有一种搜索策略能通吃所有问题。某个算法在基准函数上表现好,换到带约束的离散调度,可能立刻失灵。
工程上更现实的问题是评估预算。仿真一次耗时四十分钟,种群规模设两百,迭代五百代,算力账先崩。此时关键不在于换一个更“仿生”的名字,而在于代理模型、并行评估、早停和约束修复。例如用高斯过程或随机森林近似昂贵仿真,再用进化算法在代理面上搜索,同时保留少量真实评估校正。这个路径有前提:代理误差可控,且校正策略不能把搜索带偏。
 粒子群优化适应度景观搜索轨迹图
另一个反例是低维、光滑、可求导的问题。梯度法或拟牛顿法通常更稳、更快。生物启发算法在这里的优势有限,硬用只会增加调参负担。反过来,高维黑箱、离散组合、多目标权衡、仿真不可导的场景,才更符合它的用武之地。边界要讲清楚,别把工具当信仰。
落地靠混合,不靠单打独斗
产业界较务实的做法是混合。遗传算法负责全局探索,局部搜索负责精细修正;粒子群提供候选区域,梯度信息在可导子问题上加速;蚁群处理路径与组合结构,约束规划负责可行性。混合不是拼盘,关键是接口:什么时候切换、切换后保留哪些解、如何避免重复评估。这些工程细节决定效果,论文里的伪代码通常不写。
约束处理也值得单独说。罚函数简单,但权重敏感;修复算子能保可行,却可能压缩多样性;多目标化把约束转成目标,Pareto 前沿更丰富,但决策成本上升。没有通用解。车间排产偏修复与规则嵌入,天线设计偏代理模型与多目标,机器人路径规划偏采样与局部优化结合。场景不同,妥协点不同。
 代理模型辅助进化算法流程图
可复现性是另一个硬门槛。随机种子、参数表、评估次数、停止条件、硬件环境都要记录。否则同一套算法在不同团队手里会变成两件事。部署时还要考虑推理延迟、内存占用、失败回退。线上系统不能只给一个随机解,它需要可解释的调整记录和人工接管路径。
从仿生隐喻回到可验证搜索
近年的方向更克制:学习引导的初始化、神经组合优化、代理辅助进化、多保真评估、可微搜索。它们把仿生机制拆成可检验组件,而不是继续堆叠隐喻。这个转向是好事。算法研究需要回答三个问题:在什么条件下有效,失效边界在哪里,工程代价是否可接受。
风险也清楚。评估泄漏会让基准分数虚高;过度调参会在小数据集上过拟合;缺乏统计检验会让“提升”变成噪声。论文里应报告多次运行的分布,而不只给一条收敛曲线。工程上应做消融和回退测试,别让一个漂亮的可视化掩盖脆弱性。
所以,面对“生物启发算法”这个标签,较稳妥的态度是:把它当作一类随机搜索与优化框架,重视表示、评估、约束和预算。蚂蚁可以走错路,人不能假装没看见。