推荐系统技术:别只盯着“猜你喜欢”,大模型已经在改规则了
先泼盆冷水。推荐系统技术,真不是把用户点击日志塞进矩阵分解就完事了。那套东西现在连基线都算不上。你问我为什么?因为工业界的推荐系统早就是个多层流水线——召回、粗排、精排、重排,每一层都在互相打架。离线AUC涨了0.5%,线上GMV纹丝不动,这种事我见太多了。尴尬吧?
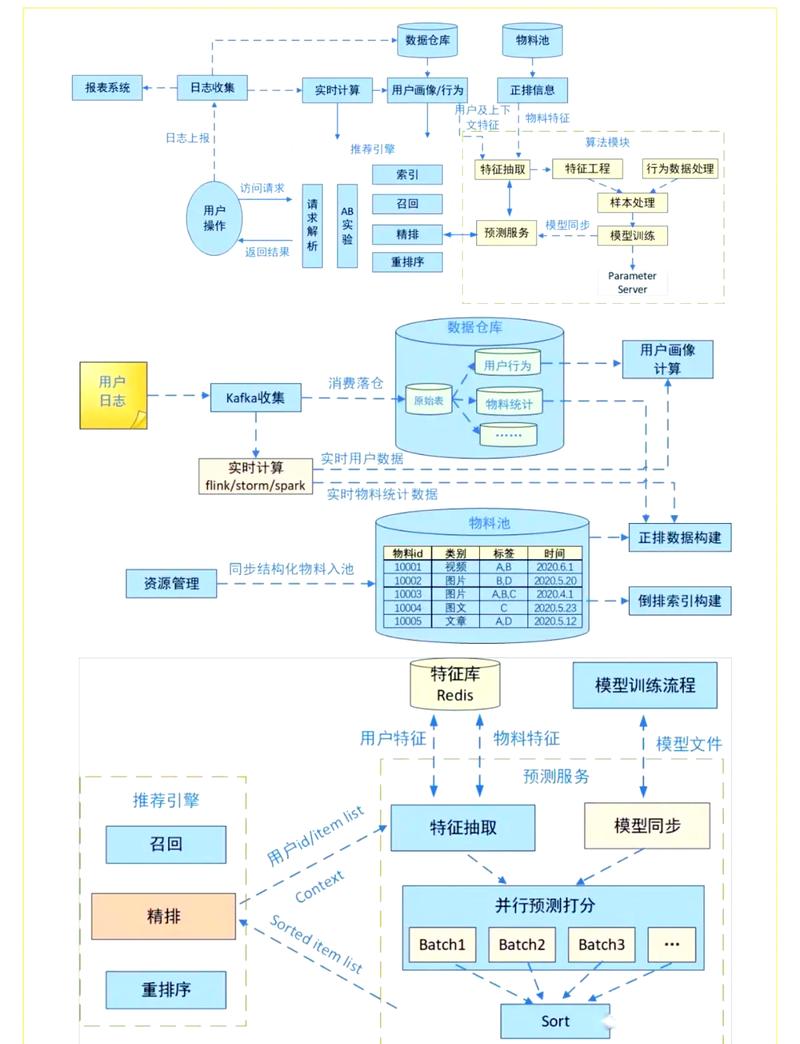 电商推荐系统召回排序重排链路架构图
 短视频推荐系统多模态嵌入模型结构图
 推荐系统特征归因与可解释性分析流程图
再说隐私。联邦学习、差分隐私、端侧推荐,都在往“数据不出设备”走。但推荐系统技术靠的就是数据密度。隐私保护一上,效果掉多少?没人敢拍胸脯。端侧推荐目前更适合轻量场景,比如手机桌面推荐、输入法候选。重模型还是得云端。
最后聊点实在的。推荐系统技术这行,论文要读,但别全信。很多实验设置干净得像实验室培养皿。真实用户行为又脏又稀疏,还有一堆运营干预。离线指标和线上收益之间的鸿沟,才是推荐系统工程师的日常。你问我推荐入门看什么?先把召回、排序、重排的工程链路跑通,再去看DIN那篇论文。别一上来就Transformer。真的。
行了,先聊到这。下次再吐槽冷启动和特征穿越。
召回不是“随便捞”,排序也不是“精排就赢”
很多人一聊推荐系统技术就盯着精排模型。DIN、DIEN、SIM,论文刷得飞起。但说实话,召回阶段漏掉的东西,精排再牛也捞不回来。这就像你开一家餐厅,门口保安只放穿红衣服的人进来,后厨米其林大厨再多也没用。对吧? 早期协同过滤靠UserCF、ItemCF。简单。有效。但冷启动一来就傻眼。后来矩阵分解把稀疏交互压到隐向量空间,算是往前走了一步。再后来双塔模型成了召回标配。可双塔有个硬伤:用户塔和物品塔在最后才交互,特征交叉太晚。于是有了SENet双塔、多兴趣召回。注意,多兴趣召回不是万能药,兴趣数量设多了噪声爆炸,设少了又不够表达。调参调到凌晨三点,我干过。电商推荐系统召回排序重排链路架构图
特征工程那点事,工业界和论文里差着十条街
论文里的特征工程经常被一笔带过。什么“我们使用了用户ID、物品ID和类别特征”。就这?工业界听了想笑。真实场景里,实时特征和离线特征的对齐成本能占掉半个团队。用户刚点了一个商品,下一秒推荐流里就得体现出来。窗口滑得不对,特征穿越就来了。离线指标漂亮得不行,上线直接崩。啧。 还有位置偏差。精排模型学到的“点击率”里掺着展示位置的影响。你不做纠偏,模型就学会“排第一的东西一定好”。这跟让裁判兼运动员有什么区别?有些团队用点击模型加曝光模型做双塔纠偏,有些直接上因果推断。因果推断在推荐系统技术里不是玄学,是保命符。不过话说回来,工业界真能把因果推断做稳的团队,不多。多数还是拍脑袋加个位置特征完事。 对了,特征实时性还有个坑:流计算延迟。你这边Flink窗口刚算完,用户已经划走了。短视频场景下,端侧实时特征比服务端特征更救命。端上算个滑动窗口点击序列,几百毫秒就能用。但端侧模型压缩、隐私合规,又是一堆事。烦躁。短视频推荐系统多模态嵌入模型结构图
大模型和生成式推荐,别急着吹
2023年之后,生成式推荐火得不行。TIGER、HSTU、LLM4Rec,论文一篇接一篇。核心思路是把推荐当成序列生成——用户历史行为变成token,下一个物品ID直接生成。听起来很酷。确实酷。生成式推荐把“召回+排序”的边界给糊掉了,一个模型端到端出结果。Meta的HSTU在规模上确实猛,谷歌的TIGER用语义ID做生成式检索,也很有意思。 但别上头。生成式推荐的推理成本,你算过吗?一个千亿参数模型给每个用户生成候选,延迟能把你服务器烧穿。工业界现在更多是拿LLM做特征增强、做冷启动文案、做语义ID生成,而不是直接端到端替代推荐链路。LLM当“特征工厂”比当“推荐引擎”务实得多。我见过有团队硬上LLM精排,离线NDCG涨了2个点,线上P99延迟从80ms飙到900ms——老板脸都绿了。 还有语义ID。把物品映射到语义空间再生成,缓解了物品ID冷启动。但语义ID的粒度怎么定?粗了区分不开,细了又退化成ID。论文里很少聊这个。科研和工程的gap,永远在这些脏细节里。冷启动、实时性、可解释性,老问题新解法
冷启动。老问题。新物品没交互,协同过滤直接哑火。现在流行用多模态 embedding——商品图、标题、视频封面,编码成向量跟用户历史做匹配。多模态冷启动在内容平台效果最明显,短视频尤其。但图文模态对齐做得不好,推荐出来的东西就像开盲盒。你刷到过那种“封面是猫、内容是汽车”的视频吧?算法干的。 实时性方面,流式训练越来越普遍。Flink + 参数服务器,分钟级更新。但实时训练容易把模型带偏——一个突发热点就能让推荐流全是同质内容。探索与利用的平衡,在实时系统里更难。强化学习喊了这么多年,工业界落地还是以Bandit为主。简单。稳。别看不起Bandit,它至少不会让你一夜之间推荐流全崩。 可解释性呢?监管越来越严。用户问“为什么给我推这个”,你总不能说“模型觉得你会点”。现在有团队用注意力权重做解释,有团队用反事实解释。可解释性不是给用户看的,是给合规和调试看的。精排模型里某个特征权重突然异常,你得能查出来。黑盒模型上线前不做特征归因,出事就是大事。推荐系统特征归因与可解释性分析流程图
再说隐私。联邦学习、差分隐私、端侧推荐,都在往“数据不出设备”走。但推荐系统技术靠的就是数据密度。隐私保护一上,效果掉多少?没人敢拍胸脯。端侧推荐目前更适合轻量场景,比如手机桌面推荐、输入法候选。重模型还是得云端。
最后聊点实在的。推荐系统技术这行,论文要读,但别全信。很多实验设置干净得像实验室培养皿。真实用户行为又脏又稀疏,还有一堆运营干预。离线指标和线上收益之间的鸿沟,才是推荐系统工程师的日常。你问我推荐入门看什么?先把召回、排序、重排的工程链路跑通,再去看DIN那篇论文。别一上来就Transformer。真的。
行了,先聊到这。下次再吐槽冷启动和特征穿越。