当模型学会拟合噪声:深度学习技术的边界与工程约束
一个在实验室里表现稳定的医学影像分类器,换到另一家医院后,准确率掉下去。设备、染色、曝光、标注口径都变了。模型没有坏,它只是把训练集里的捷径学得太熟。这类失败提醒我们,深度学习的能力常被平均误差遮住,真正决定可用性的,是误差在什么条件下成立。
误差下降之后,模型究竟学到了什么
多层非线性变换提供表示学习能力,端到端训练把特征提取与决策合并,梯度反向传播调整参数。问题在于,目标函数只约束输出,不约束内部表示是否稳定。低训练误差与稳定语义表示之间没有必然等号。模型可能利用背景、设备水印、标注习惯等非因果线索。分布内测试误差下降,并不自动意味着语义概念被掌握。数据采集流程单一时,捷径容易形成;长尾类别、罕见病理和开放环境会把它暴露出来。
 深度学习技术医学影像卷积特征图可视化
特征图可视化能看出通道响应偏置,但可视化本身不是证据。它提供诊断线索,不能替代受控实验。一个反例是,某通道对扫描仪标记敏感,调低权重后模型在旧测试集变差,新院数据却改善。这说明评测集设计会直接影响结论。问题在这儿:测试集不是裁判,它只是训练过程的一部分。
数据分布是隐式合同
 数据分布是隐式合同
监督学习假设训练与部署同分布。这个假设很少被明说。标注偏差、采样偏差、时间漂移都会破坏合同。数据增强不能修复标签噪声;重采样不能补因果缺失。工程路径包括数据卡、分层评测、切片监控和OOD验证。分布偏移不是部署后的意外,而是训练前就应写进验收条件的变量。
公开基准被反复使用,调参阶段容易发生验证集污染。榜单分数高,不等于跨机构鲁棒。保留黑箱测试集、记录数据版本、按场景分层报告失败案例,比单点精度更有信息量。小样本学习在类别语义清晰时有效,在细粒度医学或工业缺陷中,先验不足会放大偏差。长尾场景下,重加权可改善尾部召回,也可能牺牲头部精度,阈值应按业务代价设定。
训练流程里的细碎约束
算力、批大小、学习率、正则化、早停、数据管线都会改变结果。过拟合不是只看训练损失曲线。验证损失拐点受学习率调度影响。正则过强可能欠拟合;数据增强过强会改变类别边界。分布式训练中,批归一化统计量、梯度累积、混合精度都会引入差异。复现实验需要记录种子、版本、数据切分和预处理。可复现性不是实验附属品,而是判断方法有效性的前提。
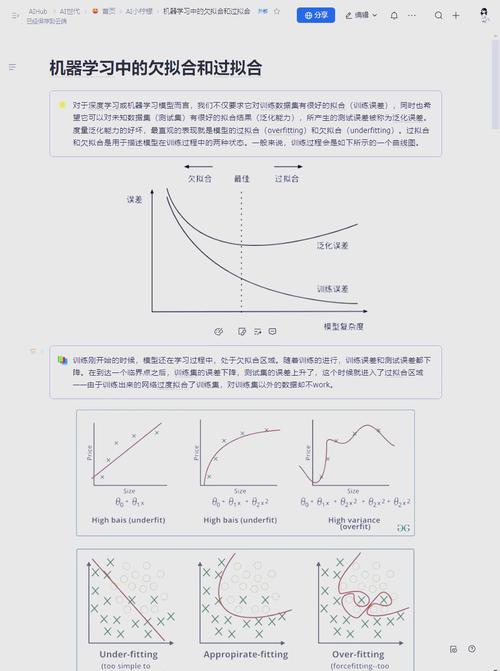 深度学习技术训练损失曲线过拟合示意图
同一模型在同一数据集上,因随机种子差异在少数类上波动明显,单次报告容易误导。工程上应报告多次运行分布、置信区间和失败案例。模型压缩也要谨慎:蒸馏、量化、剪枝可降低部署成本,但量化误差对长尾类别影响不均,需逐类校准。推理监控应关注输入漂移、置信度分布和拒识率。拒识机制比强行预测诚实。
部署端的沉默成本
 部署端的沉默成本
开放环境、安全关键和因果决策构成应用边界。自动驾驶感知在封闭测试场有效,长尾交通参与者仍难覆盖;推荐系统在反馈回路中会自我强化;医疗辅助诊断需要人机协同和责任界定。风险包括对抗样本、隐私泄漏、模型窃取、能耗与合规。评测正在从单点精度转向鲁棒性、校准、可解释和数据治理。不是所有问题都靠扩大模型解决。技术选型应从失败代价出发,而不是从模型规模出发。
一个模型是否可用,要看它在目标分布、标注口径、部署流程和失败模式上是否被充分约束。误差曲线只是入口。数据合同、评测设计和监控机制,才是把实验室结果推向真实系统的约束条件。