自然语言处理这三年:论文分数上去了,工程脏活还得干
上周跟做搜索的朋友吃饭。他一句话把我逗乐了:现在最贵的不是显卡,是“把话说清楚”的数据。听着像段子。其实挺准。自然语言处理这几年,论文里分数蹭蹭涨,工程里还是一地鸡毛。科研和落地之间,隔着一条叫“脏数据”的河。这话我认。
先说个反常识的观察。很多团队做NLP项目,第一反应是换更大的模型。结果呢?效果没动。为什么。因为问题根本不在模型容量,而在任务定义、标注规范、评测集和线上分布对不上。你看,这话不高级,但能省钱。
一、论文里的“聪明”,到底聪明在哪
自然语言处理的科研成果,大致可以拆成三层:表示、训练、对齐。表示这块,从词向量到上下文表示,再到Transformer,本质是让模型更好地处理长距离依赖和语义组合。训练这块,预训练加微调成了默认范式。对齐这块,指令微调、RLHF、DPO这些方法,把模型从“会续写”往“会按要求做事”推。
说白了,预训练解决“见多识广”,对齐解决“听懂人话”。两件事都难。前者烧钱,后者烧人。我见过一个做客服意图识别的项目,模型换了三版,最后提升最大的动作是把标注规范从两页纸扩到十二页。荒诞吧。但这就是NLP的日常。
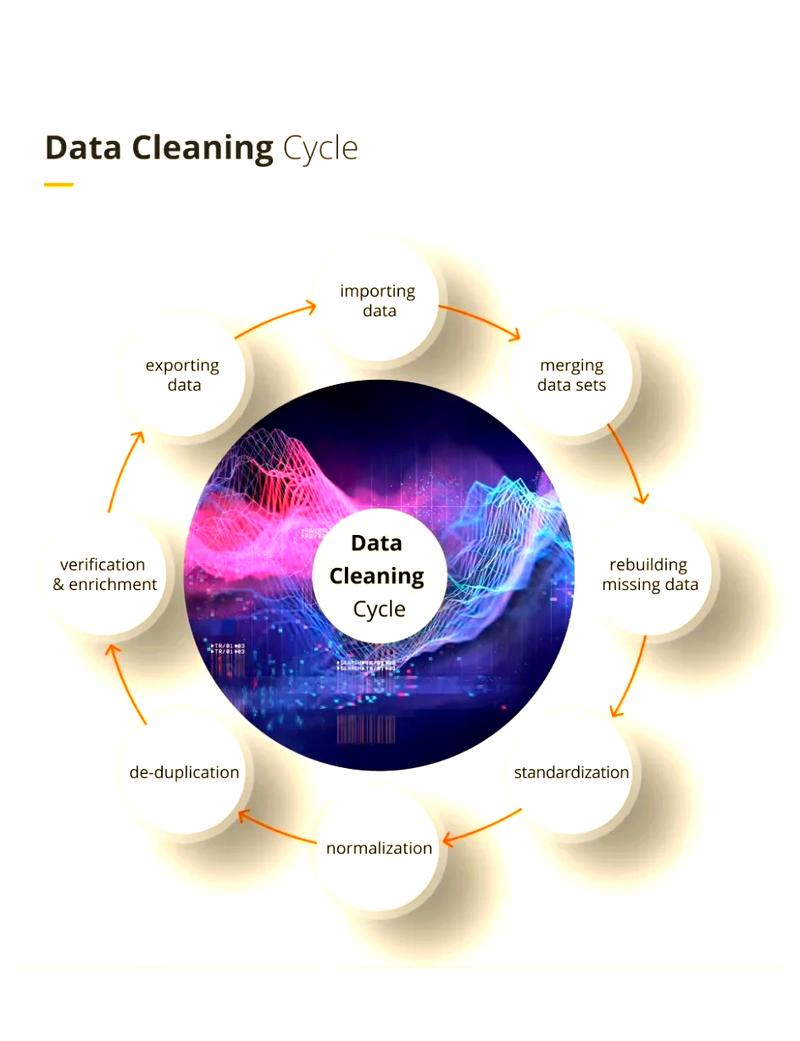 自然语言处理大模型预训练数据清洗流程图
还有个趋势很明显:大模型不是唯一答案,小模型加高质量数据在垂直场景里经常更划算。别被参数规模叙事带跑。延迟、成本、可控性,都是硬约束。对吧。
二、评测分数好看,不代表线上好用
我特别烦一种汇报:榜单涨了两个点,结论是“显著提升”。显著给谁看?用户不关心你刷了哪个benchmark。线上问题往往是另一套:输入有错别字、口语省略、多轮指代、业务黑话、长尾意图。评测集里干干净净,线上脏得离谱。
评测污染也是老问题。公开数据被反复训练,分数虚高。你以为是模型强,其实是背题。更麻烦的是,很多论文的评测设置和真实业务差太远。短文本分类刷到95,放到长文档抽取里可能直接崩。别问,问就是分布偏移。
所以我现在看NLP科研成果,先看三件事:数据怎么来的,评测怎么设计的,错误分析做没做。模型结构反而往后放。没有错误分析的论文,像没放盐的菜。能吃。但没劲。
三、RAG和长上下文:不是万能药,是新的工程债
检索增强生成,也就是RAG,这两年被聊烂了。它的思路不复杂:先检索相关片段,再让模型基于片段回答。好处是知识可更新、可追溯。坏处也明显:检索错了,模型跟着错;片段切不好,答案就碎;多跳问题,链路一长就露馅。
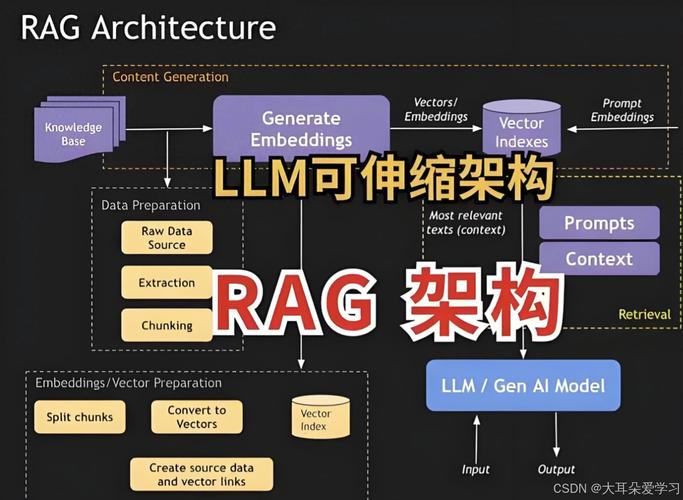 自然语言处理检索增强生成系统架构示意图
长上下文呢?窗口越做越大,大家很兴奋。可窗口大不等于会用。中间位置的信息容易被忽略,噪声多了模型也晕。长上下文是能力,不是策略。你得配合切分、重排、压缩、引用,才像样。否则就是把整本书塞给模型,然后问它第317页第三行是啥。它能答。但不稳。
不过话说回来,RAG和长上下文确实把NLP应用往前推了一大步。客服知识库、法律检索、研报问答,这些场景已经能跑。关键别神化。把RAG当检索系统做,把生成当摘要做,心态就稳了。
四、我看到的几个靠谱方向
第一,数据治理会变成NLP团队的核心竞争力。标注规范、难例挖掘、合成数据过滤、评测集维护,这些活不性感,但决定上限。第二,推理与可验证性。让模型给出依据、引用、置信度,比单纯追求流畅更有价值。第三,多模态与NLP的边界在模糊。文档理解、图表问答、语音转写后的语义纠错,都是硬需求。
还有个小建议。做NLP项目,先把“人怎么判断对错”写清楚。再谈模型。真的。很多争论不是算法之争,是标准之争。标准不清,模型越强越乱。
先写到这。我得去改标注规范了。那玩意儿比调参难。但值得。