把突触焊在硅片上:类脑芯片研发绕不开的三个真实命题
上周在南京紫金山实验室的开放日,摸到一块指甲盖大的类脑芯片样片。
工程师说跑一次神经形态推理的功耗,只有同参数GPU的1/120。
我当时第一反应不是“哇好厉害”,是盯着引脚数愣了三秒。
这东西离能装到你家智能门锁里,还差着十万八千里。毕竟实验室里测出来的极限性能,和量产线出来的能稳定跑在工业温度区间的商用产品,中间隔着工艺、算法、生态三层完全跨不过去的坎——很多人看了几篇发布会通稿就觉得类脑芯片马上要替代所有GPU,这种认知差,才是现在行业里最有意思的部分。
绕开冯·诺依曼墙,不是为了做“更快的芯片”
现在大家熟悉的通用芯片,不管是手机里的SoC还是服务器里的GPU,本质上都还是冯·诺依曼架构的老路子——计算单元和存储单元是物理分开的,每做一次运算,都要先把存在内存里的数据搬到计算核心,算完再把结果写回内存。这个来回搬运的过程,要占整个运算过程60%以上的功耗,哪怕工艺制程已经缩到3纳米,这堵“墙”还是挡在所有开发者面前。
类脑芯片从根上换了个思路。它不追求做更猛的计算核心,而是把存储单元和计算单元揉到一起,模拟大脑里神经元和突触的连接方式,让每个存储权重的突触单元本身就能完成基础的乘加运算,不用跨单元搬数据。存算一体的神经形态架构,从根源上把数据搬运带来的功耗给砍了。
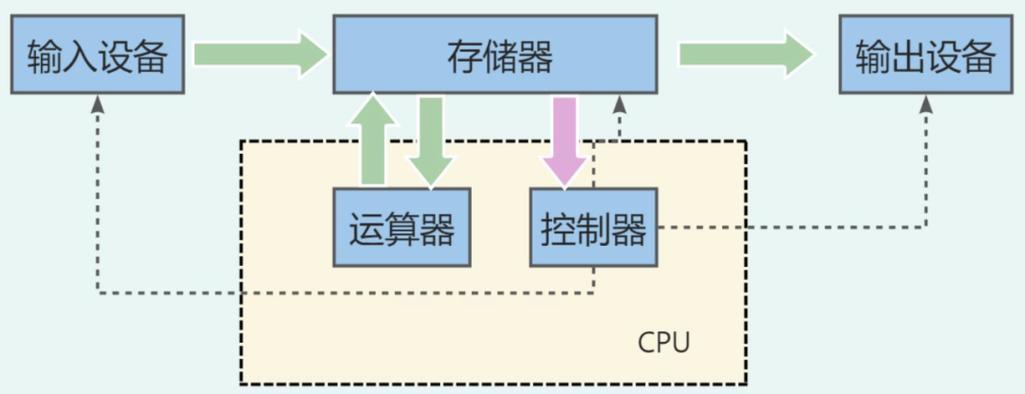 冯诺依曼架构与类脑存算一体架构功耗对比示意图
当然这套架构不是万能的。
它天生不擅长跑需要高精度浮点运算的大模型训练。你要是拿它去训千亿参数的Transformer,算力密度连普通商用GPU的零头都够不上。甚至连现在大家常用的图像识别任务,要是要求16位以上的浮点精度,类脑芯片的表现还不如同功耗的传统MCU。它的优势从来不是“算得快”,是“算得省”——尤其是需要24小时持续感知、没有持续供电来源的场景,比如埋在森林里的防火传感器,装在桥梁结构里的振动监测节点,传统芯片换一次电池要爬几十米高的桥墩,类脑芯片靠一块太阳能板就能连续跑三年,这才是它能站稳的基本盘。
被吹爆的脉冲神经网络,卡在哪了?
类脑芯片的核心算法是脉冲神经网络(SNN)。和现在主流的人工神经网络(ANN)用连续的数值传递信号不一样,SNN是靠离散的脉冲信号传递信息,更接近真实大脑神经元的放电方式,理论上能效比能比ANN高两个数量级。
但现实是,现在绝大多数已经训好的成熟模型,不管是图像识别的ResNet,还是语音识别的Transformer,都是为ANN设计的。直接把这些模型搬到SNN上,就像把燃油车的发动机塞到电动车的车架里——根本适配不上。之前有个高校团队把ResNet50转成SNN跑在自研芯片上,刚转完的时候精度掉了17个点,最后靠手动逐节点调了三周的脉冲阈值参数,才把精度差拉回到2个点以内。这效率,换工业界的产品经理看了直接要拍桌子。
核心的瓶颈其实就在脉冲时序依赖可塑性(STDP)的片上训练效率上。真实大脑里的突触权重调整,是靠前后两个脉冲的时间差自动完成的,不需要外部的复杂反馈信号。但现在芯片上实现的STDP机制,要么是精度不够,调整出来的权重收敛性差;要么是需要的硬件电路太复杂,把之前省下来的功耗又给吃回去了。
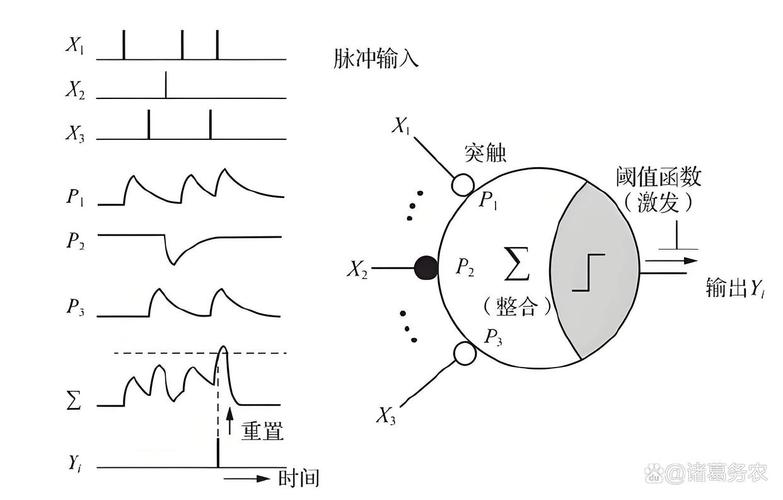 脉冲神经网络突触权重更新流程示意图
现在行业里其实在走两条完全不同的路破局。一条是做更高效的模型转换算法,把已经训好的ANN模型无损转成SNN,不用从头开始训练,尽量蹭上现有深度学习生态的红利;另一条是干脆绕开现有生态,从零开始搭适配SNN的轻量训练框架,专门针对边缘端的小模型做优化。没有哪条路是绝对正确的,前者走得快但天花板低,后者走得慢但长期潜力大,现在谁也没跑出来。
别拿实验室样片,当能量产的商用产品
很多人看了实验室里发布的类脑芯片参数,就觉得马上能买到装着类脑芯片的手机了。真的想多了。
现在实验室里测出来的那些亮眼参数,都是在理想的benchmark测试集上跑出来的。真要走到量产环节,第一个坎就是工艺兼容性。现在类脑芯片的突触单元,很多用的是忆阻器或者新型浮栅晶体管,这些器件的制造工艺和现在成熟的CMOS生产线不是完全匹配的,流一次片的成本比同规模的传统芯片高30%都不止。良率上不去。成本就下不来。
第二个坎是软件生态。现在你要给类脑芯片开发应用,得自己写底层驱动,自己适配模型,甚至连最基础的调试工具都没有——对比传统GPU已经发展了十几年的CUDA生态,类脑芯片的开发生态基本还在蛮荒时代。之前接触过一个做工业振动监测的团队,本来想换类脑芯片把节点功耗压到原来的1/10,结果光把振动信号的特征提取模块适配到芯片上,就花了四个月。算下来人力成本比买三年的工业级GPU还贵,最后只能放弃。
工艺兼容性与生态成熟度的错配,是现在所有类脑芯片研发团队都绕不开的现实问题。你不能一边吹着比传统芯片低两个数量级的功耗,一边让开发者花十倍的精力去适配——这种不对等的投入产出比,没有哪个下游客户会愿意买单。
上周和那个给我看样片的工程师吃饭,他说现在行业里最容易犯的错,就是把类脑芯片吹成能替代所有算力芯片的万能选手。
哪有那么好的事。
它本来就不是为了替代云端的大模型训练设计的,也不是为了给你打游戏、剪视频做加速的。它的价值就是在那些传统芯片“够不着”的窄场景里,把功耗压到一个能靠微幅能量收集就能持续运行的水平——比如植入式的脑机接口设备,总功耗只有几毫瓦,不用经常拆出来做手术充电;比如野外的动物追踪器,靠身体的热量就能连续跑一年。这些场景,传统芯片根本做不到。
毕竟大脑本身也是花了几百万年才演化成现在这样。哪是靠两三年流几次片就能完全复刻的。路还长。